
تضيف pgvector ميزة البحث عن التشابه المتجهي (vector similarity search) إلى أي قاعدة بيانات PostgreSQL. يمكنك تخزين التضمينات (embeddings) كأعمدة أصلية، والاستعلام باستخدام مسافة جيب التمام (cosine) أو مسافة L2 باستخدام لغة SQL العادية. لا يتطلب الأمر أي خدمة إضافية. تُستخدم في بيئات الإنتاج من قِبل فرق العمل على Supabase و AWS RDS و GCP Cloud SQL و Neon.
تُعد pgvector إضافة مفتوحة المصدر لقواعد بيانات PostgreSQL، وتعمل على إضافة ميزة البحث عن التشابه المتجهي إلى أي قاعدة بيانات Postgres حالية. ابتكرها Andrew Kane في عام 2021 وصدرت بموجب ترخيص PostgreSQL (وهو ترخيص مفتوح المصدر متساهل يشبه ترخيص MIT)، وتتيح لك تخزين التضمينات عالية الأبعاد كنوع عمود أصلي وتشغيل استعلامات أقرب جار تقريبي (approximate nearest-neighbor) باستخدام عوامل تشغيل SQL القياسية. تتوفر الإضافة على github.com/pgvector/pgvector، وتحظى بأكثر من 13,000 نجمة على GitHub اعتباراً من أبريل 2026، وتدعمها بشكل أصلي كل من Amazon RDS و Amazon Aurora و Google Cloud SQL و Azure Database for PostgreSQL و Supabase و Neon وغيرها. لا يوجد بائع، ولا اشتراك، ولا رسوم لكل استعلام: التكلفة هي فقط ما تدفعه لتشغيل Postgres.
تضيف الإضافة ثلاثة عوامل تشغيل للمسافة: <-> لمسافة L2 (الإقليدية)، و <#> للضرب الداخلي (inner product)، و <=> لمسافة جيب التمام (cosine distance). وتدعم نوعين من الفهارس: IVFFlat (بحث تقريبي قائم على التقسيم يتطلب خطوة تدريب) و HNSW (عوالم صغيرة هرمية قابلة للتنقل، أُضيفت في الإصدار v0.5.0 في أكتوبر 2023، والتي تُبنى بشكل تدريجي وتوفر معدل استدعاء أعلى دون مرحلة تدريب). يمكنك تخزين متجهات تصل إلى عدة آلاف من الأبعاد بناءً على الإصدار، مما يجعلها متوافقة مع نماذج التضمين من OpenAI و Cohere و Google وغيرها. يتم تشغيل الاستعلامات داخل Postgres، لذا يمكنك دمج (JOIN) نتائج المتجهات مع جداولك العلائقية العادية، وتطبيق سياسات الأمان على مستوى الصف، واستخدام تجمع الاتصالات (connection pool) ونظام ORM الحاليين لديك دون الحاجة إلى أي بنية تحتية جديدة.
ما الذي تقدمه pgvector فعلياً في أبريل 2026
يأتي الإصدار المستقر الحالي من pgvector (v0.8.x) كإضافة Postgres قياسية: أمر واحد CREATE EXTENSION vector; يقوم بتفعيلها في أي قاعدة بيانات متوافقة. يمكنك تعريف عمود متجه مع عدد أبعاد مُعلن (embedding vector(1536) لتضمينات OpenAI ada-002، على سبيل المثال)، وإدراج التضمينات جنباً إلى جنب مع بياناتك العادية باستخدام أمر INSERT قياسي، والاستعلام باستخدام عوامل تشغيل المسافة في جملة WHERE أو ORDER BY. يُعد فهرس HNSW، الذي أُضيف في أكتوبر 2023، هو نوع الفهرس الموصى به الآن لأعباء عمل الإنتاج التي تتجاوز حوالي 100,000 متجه. فهو يدعم عمليات الإدراج المتزامنة دون الحاجة إلى خطوة إعادة بناء، ويقدم باستمرار معدل استدعاء يتجاوز 95 بالمائة بسرعات استعلام معقولة. يظل IVFFlat متاحاً لأعباء العمل التي تكون فيها تكلفة مرحلة التدريب مقبولة والذاكرة مقيدة. يدعم كلا نوعي الفهارس الإنشاء المتوازي للفهارس في إصدارات Postgres الأحدث. تحظى الإضافة بصيانة نشطة، مع وصول التحديثات بانتظام ومتابعة مزودي الخدمات السحابية الرئيسيين للإصدارات الجديدة في غضون أسابيع من نشرها.
موقع pgvector مقارنةً بـ Pinecone و Qdrant
ينقسم سوق قواعد البيانات المتجهية في أبريل 2026 تقريباً إلى ثلاثة معسكرات: خدمات مُدارة مبنية لغرض معين (Pinecone)، وقواعد بيانات مخصصة مفتوحة المصدر (Qdrant و Weaviate و Chroma)، وإضافات Postgres (pgvector). المفاضلات بينها ملموسة وتتعلق بالبنية المعمارية.
pgvector مقابل Pinecone: تُعد Pinecone خدمة مغلقة المصدر ومُدارة بالكامل، صُممت من الصفر للبحث التقريبي عن أقرب جار على نطاق واسع. تتعامل بنيتها الموزعة مع مليارات المتجهات بسلاسة أكبر مما يمكن لـ pgvector القيام به داخل مثيل Postgres واحد. وتوفر تحديثات الفهرس في الوقت الفعلي، وتصفية مدمجة للبيانات الوصفية مرتبطة مباشرة بالفهرس (وليس كجملة SQL WHERE بعد الاستعلام)، وواجهة REST/SDK بدون SQL. تبدأ خدمة Pinecone الخالية من الخوادم (Serverless) مجانية اسمياً، لكن الباقات المدفوعة تبدأ من حوالي $70 شهرياً بمجرد نمو أحجام الفهارس. المفاضلة الأساسية هنا هي سقف الأداء والارتباط بمزود الخدمة (vendor lock-in) مقابل بساطة البقاء داخل Postgres. إذا كان لديك بالفعل تطبيق Postgres، فإن Pinecone تتطلب خدمة جديدة، وعميل API جديد، وعلاقة فوترة جديدة، وكود تطبيق يستعلم من مخزني بيانات مختلفين ويربط النتائج بينهما. بينما تُبقي pgvector كل شيء في مكان واحد.
pgvector مقابل Qdrant: تُعد Qdrant قاعدة بيانات متجهية مفتوحة المصدر وقابلة للاستضافة الذاتية مكتوبة بلغة Rust، وتتوفر أيضاً كخدمة سحابية مُدارة. تستخدم HNSW كفهرس أساسي لها (نفس الخوارزمية التي اعتمدتها pgvector في الإصدار v0.5.0) ولكنها مُنفذة خصيصاً لأعباء عمل المتجهات، مما يُترجم إلى معدل استعلامات في الثانية (QPS) خام أعلى عند نفس معدل الاستدعاء، خاصة تحت أحمال التزامن الثقيلة. تتعامل Qdrant مع تصفية الحمولة (payload filtering) كعنصر أساسي في الفهرسة: يتم ربط فلاتر البيانات الوصفية في مسار HNSW، ولا تُطبق كفلتر بعد الاستعلام. تُظهر معايير الأداء باستمرار تفوق Qdrant على pgvector في الإنتاجية عند التزامن العالي. التكلفة هنا تشغيلية: Qdrant هي خدمة منفصلة ذات حالة (stateful) لها نشرها الخاص، وتنسيق تخزينها، وواجهة برمجة التطبيقات (API)، والمراقبة الخاصة بها. لا يمكنك دمج (JOIN) نتائج Qdrant مع جدول مستخدمي Postgres في استعلام واحد؛ بل تقوم بالجلب من Qdrant، ثم الربط في كود التطبيق أو عبر رحلة ذهاب وإياب ثانية لقاعدة البيانات. بالنسبة للفرق التي تمتلك قدرات DevOps لإدارة خدمة أخرى وأعباء عمل متجهات ستتجاوز 20-50 مليون صف، تُعد Qdrant الخيار التقني الأقوى. أما بالنسبة للجميع، فإن حجة pgvector المتمثلة في "إنها مجرد Postgres الخاصة بك" يصعب تجاهلها.
"لقد انتقلنا من Pinecone إلى pgvector في الربع الأخير. زمن انتقال الاستعلام p99 لدينا أعلى، لكننا تخلصنا من تبعية كاملة للبنية التحتية وانخفضت فاتورتنا الشهرية بحوالي $400. بالنسبة لحجمنا، الذي يقل عن 5 ملايين متجه، كان هذا هو القرار الصحيح." -- throwaway_ml_eng، Hacker News، نوفمبر 2023
كيف يبدو واقع سير العمل اليومي
سير العمل الأكثر شيوعاً في pgvector هو مسار RAG (التوليد المعزز بالاسترجاع): تقسيم المستندات، وتوليد التضمينات عبر استدعاء API إلى OpenAI أو Cohere، وتخزين التضمين والنص المصدر في جدول Postgres، ثم في وقت الاستعلام، توليد تضمين لسؤال المستخدم واسترجاع أقرب K من الأجزاء لحقنها في موجه LLM. مع pgvector، يتم ذلك باستعلام SQL واحد. يعيش التضمين في نفس قاعدة البيانات مع المستخدمين والمستندات والأذونات وسجلات التدقيق. يُطبق الأمان على مستوى الصف تلقائياً. تغطي أدوات مراقبة Postgres الحالية لديك (pg_stat_statements، وسجلات الاستعلامات البطيئة، و Datadog، وما إلى ذلك) استعلامات المتجهات. عمليات الترحيل (Migrations) هي مجرد عبارات ALTER TABLE.
كان إصدار v0.5.0 في أكتوبر 2023، والذي أضاف فهرسة HNSW، هو اللحظة التي حكم فيها المجتمع بشكل واسع على أن pgvector جاهزة لبيئة الإنتاج. قبل ذلك الإصدار، كان IVFFlat هو خيار الفهرس التقريبي الوحيد. يتطلب IVFFlat خطوة تدريب صريحة (SET ivfflat.probes) بعد تحميل بياناتك، ويؤدي إلى تدهور معدل الاستدعاء عند انخفاض عدد المجسات (probes) في مجموعات البيانات الكبيرة، ولا يمكن تحديثه تدريجياً دون إعادة تدريب دورية. العديد من انقطاعات الإنتاج ومنشورات المدونات من 2022-2023 تعود إلى تدهور استدعاء IVFFlat مع نمو المجموعات. قضى HNSW على متطلبات التدريب ورفع مستوى الاستدعاء العملي. جمعت سلسلة مشكلات GitHub التي أعلنت عن v0.5.0 مئات التعليقات في غضون أيام، حيث أبلغت الفرق عن ارتياح فوري من مشكلات الإنتاج طويلة الأمد.
"كان دعم فهرس HNSW في الإصدار 0.5.0 هو الشيء الذي جعل pgvector قابلة للاستخدام الفعلي بالنسبة لنا. قبل ذلك، كنا نضطر إلى إجراء عمليات مسح كاملة للجداول لأي شيء يتجاوز مليون صف. بعد HNSW، أصبح الفرق شاسعاً." -- datasci_pete، سلسلة مشكلات GitHub، pgvector/pgvector، أواخر 2023
لمن صُممت pgvector
تناسب pgvector الفرق التي تدير بالفعل Postgres وترغب في البحث المتجهي دون إضافة خدمة جديدة إلى حزمة تقنياتها. يغطي هذا جزءاً كبيراً من سوق الشركات الناشئة والشركات في مرحلة التوسع: يمكن لأي شخص يستخدم Supabase أو Neon أو RDS أو Cloud SQL أو مثيل Postgres مُدار ذاتياً تفعيل pgvector بأمر واحد والبدء في تخزين التضمينات في نفس اليوم. إنها تناسب مسارات RAG، وميزات البحث الدلالي، ومحركات التوصية، وسير عمل اكتشاف التكرار بأحجام تصل إلى حوالي 10-20 مليون متجه مع أداء استعلام مقبول. وهي مناسبة بشكل خاص لتطبيقات SaaS متعددة المستأجرين حيث توفر سياسات الأمان على مستوى الصف في Postgres عزلاً لبيانات كل عميل دون أي طبقة تحكم في الوصول مخصصة في طبقة المتجهات. ستجد الفرق ذات قدرات DevOps المحدودة والتي لا يمكنها تبرير إدارة خدمة أخرى ذات حالة (stateful) أن البساطة التشغيلية لـ pgvector مقنعة حتى عندما لا تكون أرقام الأداء هي الأفضل في فئتها.
ما لا تقدمه pgvector
لا تُعد pgvector بديلاً لقواعد البيانات المتجهية المبنية لغرض معين على نطاق واسع أو تحت أحمال الكتابة المتزامنة الثقيلة. عند 50 مليون متجه وما فوق، أو في التطبيقات التي يتم فيها الاستعلام من مخزن المتجهات آلاف المرات في الثانية، يصبح العبء الإضافي لمخطط استعلام Postgres والتزامن القائم على MVCC في pgvector قيوداً قابلة للقياس. تُبلغ الفرق في هذا الموقف باستمرار عن الانتقال إلى Qdrant (استضافة ذاتية) أو Pinecone (مُدارة) بدلاً من محاولة ضبط الأداء للالتفاف حول حدود pgvector.
لا توفر pgvector بحثاً هجيناً أصلياً. بالنسبة لمسارات RAG التي تحتاج إلى تصنيف الكلمات الرئيسية BM25 مقترناً بالتشابه المتجهي (وهو نمط أصبح معيارياً بشكل متزايد في أنظمة الاسترجاع في بيئة الإنتاج اعتباراً من 2025-2026)، يتعين عليك تجميع القطع بنفسك باستخدام البحث عن النص الكامل في Postgres، أو pg_trgm، أو فهرس BM25 خارجي، ثم دمج الدرجات في كود التطبيق. توفر الأنظمة المخصصة مثل Weaviate و Elasticsearch البحث الهجين كوضع أساسي مع معلمات ألفا قابلة للضبط. إذا كان الاسترجاع الهجين أمراً مركزياً لمنتجك، فإن pgvector تتطلب هندسة إضافية كبيرة لمطابقة ما توفره الأنظمة المخصصة جاهزاً للاستخدام.
كما أن pgvector لن تفيدك إذا لم يكن تطبيقك مبنياً على Postgres. إذا كان مخزن البيانات الأساسي لديك هو MongoDB أو MySQL أو Cassandra أو مخزن كائنات نقي، فلا يوجد pgvector لك: ستحتاج إلى قاعدة بيانات متجهية مخصصة أو خدمة مُدارة.
تقييمات المستخدمين
لا توجد تقييمات بعد. كن أول من يشارك تجربته!
سجّل الدخول لكتابة تقييم.
ظهرت في مجموعات
قوائم منتقاة تتضمّن pgvector.
مقالات ذات صلة
أدلة ومقالات ذات صلة بـ pgvector.

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Replace 6 SaaS Subscriptions With 4 n8n AI Agents (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing
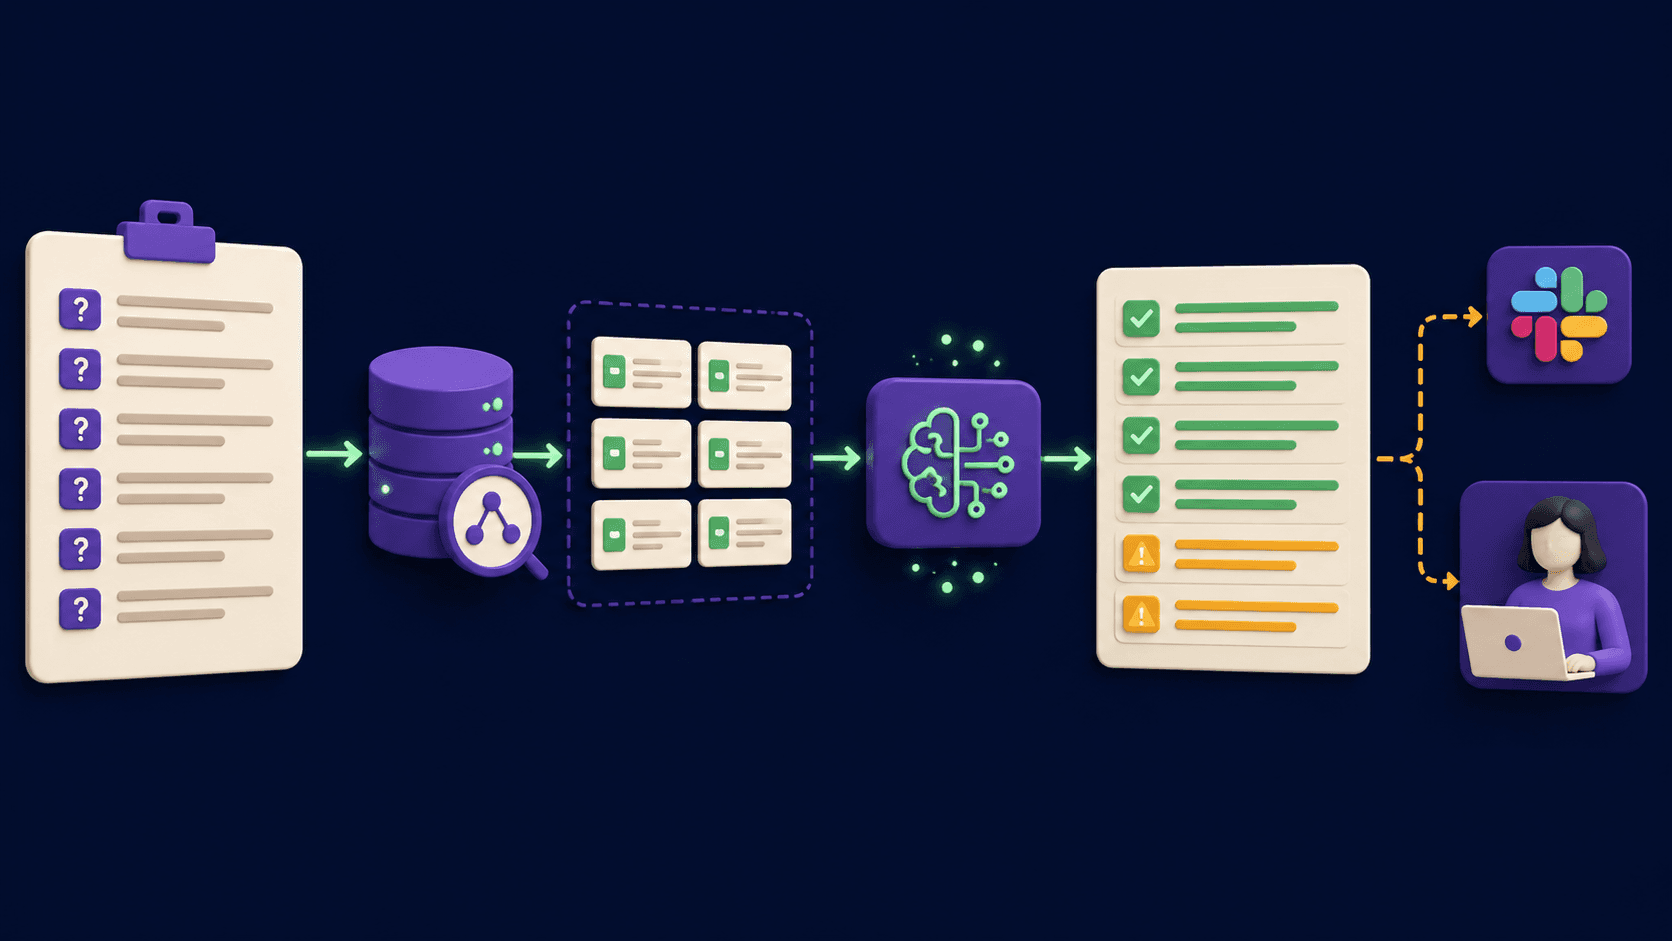
RFP and Proposal Auto-Fill: The Agent That Handles 80% of the Repeating Questions (2026)
