
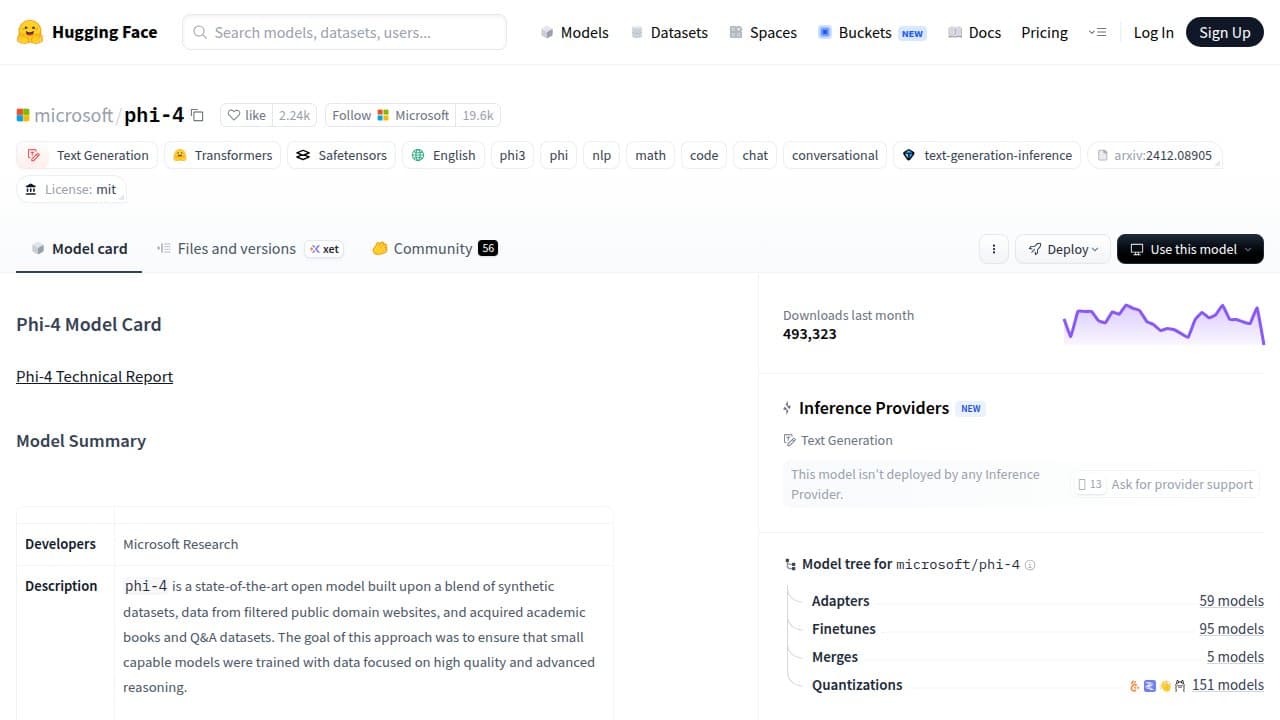
La familia Phi de Microsoft demuestra que la calidad de los datos supera a la escala. La generación Phi-4 (14B, licencia MIT) supera las expectativas en matemáticas y razonamiento, y funciona en hardware de consumo. De descarga gratuita, con inferencia alojada de pago en Azure AI Foundry.
La familia Phi de Microsoft es una serie de modelos de lenguaje pequeños (SLM) basados en una apuesta central: que los datos de entrenamiento sintéticos cuidadosamente seleccionados pueden producir un modelo que supere a rivales con muchos más parámetros. Desarrollado por Microsoft Research y publicado bajo la licencia MIT, Phi ha crecido desde el Phi-1 de 1.3B en 2023 hasta la generación Phi-4, que a principios de 2026 abarca una variante mini de 3.8B, un modelo multimodal de 5.6B, un modelo insignia de 14B y un modelo de razonamiento y visión de 15B lanzado en marzo de 2026. Todos los pesos están disponibles de forma gratuita en Hugging Face bajo la organización microsoft, y todos cuentan con la licencia MIT, lo que significa que el uso comercial, el ajuste fino (fine-tuning) y la redistribución no tienen restricciones. El investigador principal detrás de las primeras apuestas de Phi, Sebastien Bubeck (anteriormente vicepresidente de investigación de IA generativa de Microsoft), se fue a OpenAI en octubre de 2024, pasando el testigo a un equipo que ha seguido impulsando a la familia.
La línea actual ofrece a los desarrolladores opciones significativas para diferentes presupuestos de hardware. Phi-4 (14B) maneja matemáticas, razonamiento y código en una GPU de consumo con 8GB de VRAM cuando se cuantiza a 4 bits. Phi-4-mini (3.8B) admite una ventana de contexto de 128K y llamadas a funciones (function calling), lo que lo convierte en una opción legítima para implementaciones en el borde (edge). Phi-4-multimodal (5.6B) procesa texto, audio e imágenes, y encabezó la clasificación OpenASR de HuggingFace con una tasa de error de palabras del 6.14% en febrero de 2025. Phi-4-reasoning y Phi-4-reasoning-plus (ambos de 14B) utilizan un ajuste fino supervisado en trazas de razonamiento generadas por o3-mini, y la variante plus añade aprendizaje por refuerzo basado en resultados para cadenas más largas y de mayor precisión. El miembro más reciente, Phi-4-reasoning-vision-15B (lanzado el 4 de marzo de 2026), amplía el razonamiento multimodal a la comprensión de interfaces de usuario (UI) y problemas científicos. Todos se pueden implementar a través de Ollama, Hugging Face Transformers, Azure AI Foundry, GitHub Models y entornos de ejecución compatibles con llama.cpp.
Phi de un vistazo, abril de 2026
La generación Phi-4 cubre cuatro objetivos principales de implementación:
Phi-4 (14B): Transformer denso de solo decodificador. Licencia MIT. Contexto de 16K. MMLU 84.8, GPQA 56.1, MATH 80.4, HumanEval 82.6. Entrenado con 9.8 billones de tokens que incluyen datos altamente sintéticos de matemáticas, programación y razonamiento. Lanzado el 12 de diciembre de 2024 como una vista previa de investigación en Azure AI Foundry; pesos abiertos bajo MIT en enero de 2025.
Phi-4-mini (3.8B): Atención de consultas agrupadas (GQA), vocabulario de 200K, contexto de 128K, llamadas a funciones. Lanzado el 26 de febrero de 2025. La opción principal para implementaciones en el borde y el IoT.
Phi-4-multimodal (5.6B): Entrada de texto, audio e imagen; salida de texto. Líder en ASR (6.14% WER). Lanzado el 26 de febrero de 2025.
Phi-4-reasoning / Phi-4-reasoning-plus (14B): Modelos de cadena de razonamiento entrenados con demostraciones de o3-mini. Lanzados en abril/mayo de 2025. Superan a DeepSeek-R1-Distill-Llama-70B en varios puntos de referencia de razonamiento.
Phi-4-reasoning-vision-15B: Modelo de razonamiento multimodal de 15B. Licencia MIT. Lanzado el 4 de marzo de 2026. Maneja matemáticas, ciencias y comprensión de UI con entrada de visión.
El entrenamiento de Phi-4 duró 21 días en 1,920 GPUs H100-80G. Aproximadamente el 8% de los datos de entrenamiento son multilingües; el resto es principalmente en inglés. La fecha de corte de los datos es junio de 2024 para el modelo base Phi-4; agosto de 2024 para algunas variantes posteriores.
En qué destaca realmente Phi
La tesis de los datos sintéticos da sus frutos de manera más visible en tareas estructuradas. Phi-4 (14B) obtiene una puntuación de 80.4 en el punto de referencia MATH y 82.6 en HumanEval, cifras que superan a modelos de dos a cinco veces su tamaño. Para los desarrolladores que ejecutan modelos cuantizados en hardware de consumo, este es el principal atractivo: un modelo que cabe en 8GB de VRAM y maneja problemas reales de programación y matemáticas de manera creíble.
"He tenido un gran éxito con Phi-4 12B cuantizado y Ollama hasta ahora. Es tan rápido como Llama 3.1 8B, pero los resultados han sido (subjetivamente) de mayor calidad." - accrual, Hacker News, diciembre de 2024
La licencia MIT es un auténtico diferenciador. Mientras que Gemma lleva la Licencia Gemma de Google (con requisitos de informes a gran escala) y Llama lleva la Licencia Llama de Meta (uso comercial permitido pero con condiciones para implementaciones de alto tráfico), la licencia MIT de Phi-4 es la más limpia de las tres para los equipos que integran modelos en productos comerciales sin la carga de revisiones legales.
Phi-4-mini es posiblemente el modelo más subestimado de la familia. Con 3.8B de parámetros, una ventana de contexto de 128K y llamadas a funciones fiables, se adapta al caso de uso de agentes en el borde que el modelo base Phi-4 no puede cubrir (el contexto de 16K es un límite estricto para tareas con muchos documentos). Microsoft publicó un tutorial específico sobre la creación de agentes de IA en dispositivos IoT con Phi-4-mini a través de Ollama, y la recepción de la comunidad fue positiva para ese patrón de implementación específico.
"Estos se ven bastante increíbles... Los lanzamientos de Phi-4 lo distinguen como la única competencia por debajo de ~7B." - refulgentis, Hacker News, mayo de 2025 (sobre los modelos Phi-4-reasoning)
Dónde falla Phi: los problemas recurrentes de los usuarios
La brecha entre las puntuaciones de los puntos de referencia y el seguimiento de instrucciones en el mundo real es el problema más persistente de Phi. Es anterior a Phi-4 y no se ha resuelto por completo. En una prueba documentada de enero de 2025, un desarrollador hizo que Phi-4 jugara 30 partidas de ajedrez en las que el modelo tenía que seguir un prompt restringido. Phi-4 obtuvo cero victorias y cero empates, rompió las reglas del prompt después de un promedio de 7.7 movimientos, generó casi seis veces más tokens que Gemma 2 9B y cometió diez veces más errores. El desarrollador concluyó: "Mi impresión general de los modelos pequeños que brillan en las evaluaciones no es tan buena cuando se usan en la vida real". Este patrón de verbosidad se extiende también a los modelos de razonamiento. Simon Willison probó Phi-4-reasoning en mayo de 2025 y notó que generaba 56 oraciones de razonamiento en respuesta a un simple saludo de "hola", un patrón que describió como "una tendencia a pensar demasiado".
El límite de contexto de 16K en el modelo base Phi-4 es una queja recurrente. Un hilo de discusión en Hugging Face titulado "Limited Context Length - Yarn/Rope?" captura la frustración: en el momento en que Phi-4 se lanzó con 16K, tanto Llama 3.2 como Gemma 3 ofrecían 128K. Phi-4-mini solucionó esto más tarde con 128K, pero el contexto del modelo insignia sigue siendo limitado en relación con la competencia. Para cualquier tarea que involucre documentos largos, bases de código o contexto de múltiples turnos, esta es una restricción estricta.
El uso multilingüe es otro punto débil. Con aproximadamente un 8% de datos de entrenamiento multilingües, Phi-4 tiene un rendimiento inferior en prompts que no están en inglés. Los usuarios que necesitan chino, árabe u otros idiomas informan que necesitan un ajuste fino o cambiar a Gemma 3, que cubre 140 idiomas de forma nativa.
Por último, el escepticismo sobre los puntos de referencia ha perseguido a la familia Phi desde Phi-3. Varios miembros de la comunidad han sugerido que los modelos muestran signos de contaminación de datos de los puntos de referencia. Microsoft abordó esto directamente en el informe técnico de Phi-4, describiendo procedimientos mejorados de descontaminación de datos, pero la percepción persiste entre algunos evaluadores. Un comentarista de HN señaló claramente en diciembre de 2024: "los modelos Phi siempre tienen excelentes puntuaciones en los puntos de referencia, pero siempre me decepcionan en los casos de uso del mundo real".
Phi vs. Llama 3.2 vs. Gemma 3
Phi-4 (14B, MIT) es un Transformer denso de solo decodificador entrenado principalmente con datos sintéticos en inglés. Su principal ventaja es el rendimiento en matemáticas y razonamiento por parámetro. Sus principales limitaciones son el contexto de 16K en el modelo base y un entrenamiento multilingüe mínimo.
Llama 3.2 (Meta, Licencia Llama) se presenta en variantes de solo texto de 1B y 3B, y variantes multimodales de 11B y 90B. La diferencia mecánica clave es el contexto: Llama 3.2 admite 128K tokens frente a los 16K de Phi-4. Llama 3.2 utiliza atención de consultas agrupadas (GQA) que reduce la memoria caché KV a 1/8 de las arquitecturas tradicionales. El ecosistema derivado es inigualable: llama.cpp, vLLM, Ollama, TGI y todos los principales entornos de ejecución de inferencia admiten Llama de forma nativa. En MMLU, Llama 3.2 3B se sitúa en torno al 61.8% frente al 84.8% de Phi-4 a 14B, pero Llama 3.3 70B supera a Phi-4 en tareas generales cuando el presupuesto de parámetros no es una restricción.
Gemma 3 (Google DeepMind, Licencia Gemma) se destila de la arquitectura Gemini de Google y utiliza un diseño "delgado y profundo" frente al enfoque "ancho y superficial" de Llama. Gemma 3 se presenta en variantes de 1B, 4B, 12B y 27B, todas con contexto de 128K. Las variantes de 4B+ incluyen entrada de imagen nativa, de la que Phi-4-mini carece por completo (solo el modelo separado Phi-4-multimodal maneja la visión). Gemma 3 cubre 140 idiomas frente al corpus principalmente en inglés de Phi-4. La licencia no es MIT: los términos de Gemma exigen requisitos de informes para implementaciones que superen los 700 millones de usuarios activos mensuales (MAU) e incluyen condiciones adicionales ausentes en MIT. Para la mayoría de los equipos esto no es un problema, pero para la simplicidad legal a gran escala, la licencia MIT de Phi-4 es la ganadora.
El resumen práctico: si la longitud del contexto es importante (RAG de documentos, conversaciones largas), elige Llama 3.2 o Gemma 3. Si el soporte multilingüe es importante, elige Gemma 3. Si la pureza de la licencia MIT es importante y el objetivo es el razonamiento y las matemáticas en un espacio reducido, Phi-4 es la opción más sólida.
¿Vale la pena el nivel de pago?
No hay suscripción de pago para Phi. Los modelos se pueden descargar y ejecutar de forma gratuita. La inferencia alojada en Azure AI Foundry es de pago por token sin compromiso mínimo:
Phi-4-mini (alojado): $0.000075/1K tokens de entrada, $0.0003/1K tokens de salida. La opción más asequible de la familia.
Phi-4 (alojado): $0.000125/1K tokens de entrada, $0.0005/1K tokens de salida.
Phi-4-multimodal (texto/imagen): $0.00008/1K de entrada, $0.00032/1K de salida.
Phi-4-multimodal (audio): $0.004/1K de entrada, $0.00032/1K de salida.
Ajuste fino (Fine-tuning): $0.003/1K tokens de entrenamiento. Alojamiento de modelos ajustados: $0.80/hora.
Para los equipos que se autoalojan, el coste es cero más allá de la infraestructura. Un Phi-4 (14B) cuantizado a 4 bits se ejecuta en una sola GPU de consumo con 8GB de VRAM. Para los equipos que desean inferencia gestionada sin administrar la capacidad de la GPU, las tarifas por token de Azure se encuentran entre las más bajas del mercado para modelos de esta clase de capacidad. La decisión es sencilla: autoalojar de forma gratuita si tienes el hardware y la capacidad de ingeniería; usar Azure para una simplicidad gestionada a un coste muy bajo.
Mejores casos de uso (y cuándo evitarlo)
Phi es muy adecuado para:
Implementaciones de agentes en el borde y el IoT: Phi-4-mini a 3.8B con contexto de 128K y llamadas a funciones está diseñado para esto. Microsoft ha publicado un tutorial dedicado para agentes en el borde basados en Ollama.
Matemáticas y razonamiento estructurado: La puntuación de 80.4 en el punto de referencia MATH a 14B es la cifra principal. Para sistemas de tutoría, asistentes de programación con razonamiento matemático y preguntas y respuestas científicas en inglés, Phi-4 es la opción de modelo pequeño más sólida.
Implementaciones que priorizan la privacidad o aisladas (air-gapped): Licencia MIT, sin requisitos de telemetría, se ejecuta de forma totalmente local. Los equipos en industrias reguladas (salud, finanzas) que no pueden enviar datos a las API en la nube tienen un camino viable aquí.
Investigación y ajuste fino: La metodología de entrenamiento transparente (documentada en los informes técnicos de Microsoft Research) y la licencia MIT hacen de Phi un punto de partida natural para proyectos de ajuste fino académicos y comerciales.
Evita Phi cuando:
Necesites procesar documentos largos, bases de código o conversaciones de múltiples turnos que superen los 16K tokens en el modelo base (usa Gemma 3 o Llama 3.2 con contexto de 128K).
Tus usuarios o contenido sean principalmente en un idioma distinto al inglés (la cobertura de 140 idiomas de Gemma 3 es mucho más amplia).
Estés construyendo un flujo de trabajo de agentes en producción donde el seguimiento estricto y conciso de las instrucciones sea esencial. La verbosidad y los fallos ocasionales en el cumplimiento de las instrucciones documentados por los evaluadores de la comunidad son un riesgo real en bucles de agentes complejos.
Desées el soporte más amplio para motores de inferencia y la mayor comunidad de derivados ajustados (Llama gana aquí por un amplio margen).
Primeros pasos con Phi
El camino más rápido es Ollama: ollama pull phi4 para el modelo base de 14B, o ollama pull phi4-mini para la variante de 3.8B, ambos disponibles sin necesidad de una cuenta. Para Hugging Face, los repositorios microsoft/phi-4 y microsoft/Phi-4-mini-instruct incluyen tarjetas de modelo y ejemplos de pipelines de transformers. Los modelos utilizan tokens en formato ChatML. Para Azure AI Foundry, busca cualquier variante de Phi-4 en el Catálogo de Modelos e impleméntala a través de inferencia gestionada de pago por token sin necesidad de aprovisionar GPUs.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen Phi.
Artículos relacionados
Guías y artículos relacionados con Phi.

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Run Open Source AI Models Locally: Battle-Tested Guide

Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI
