
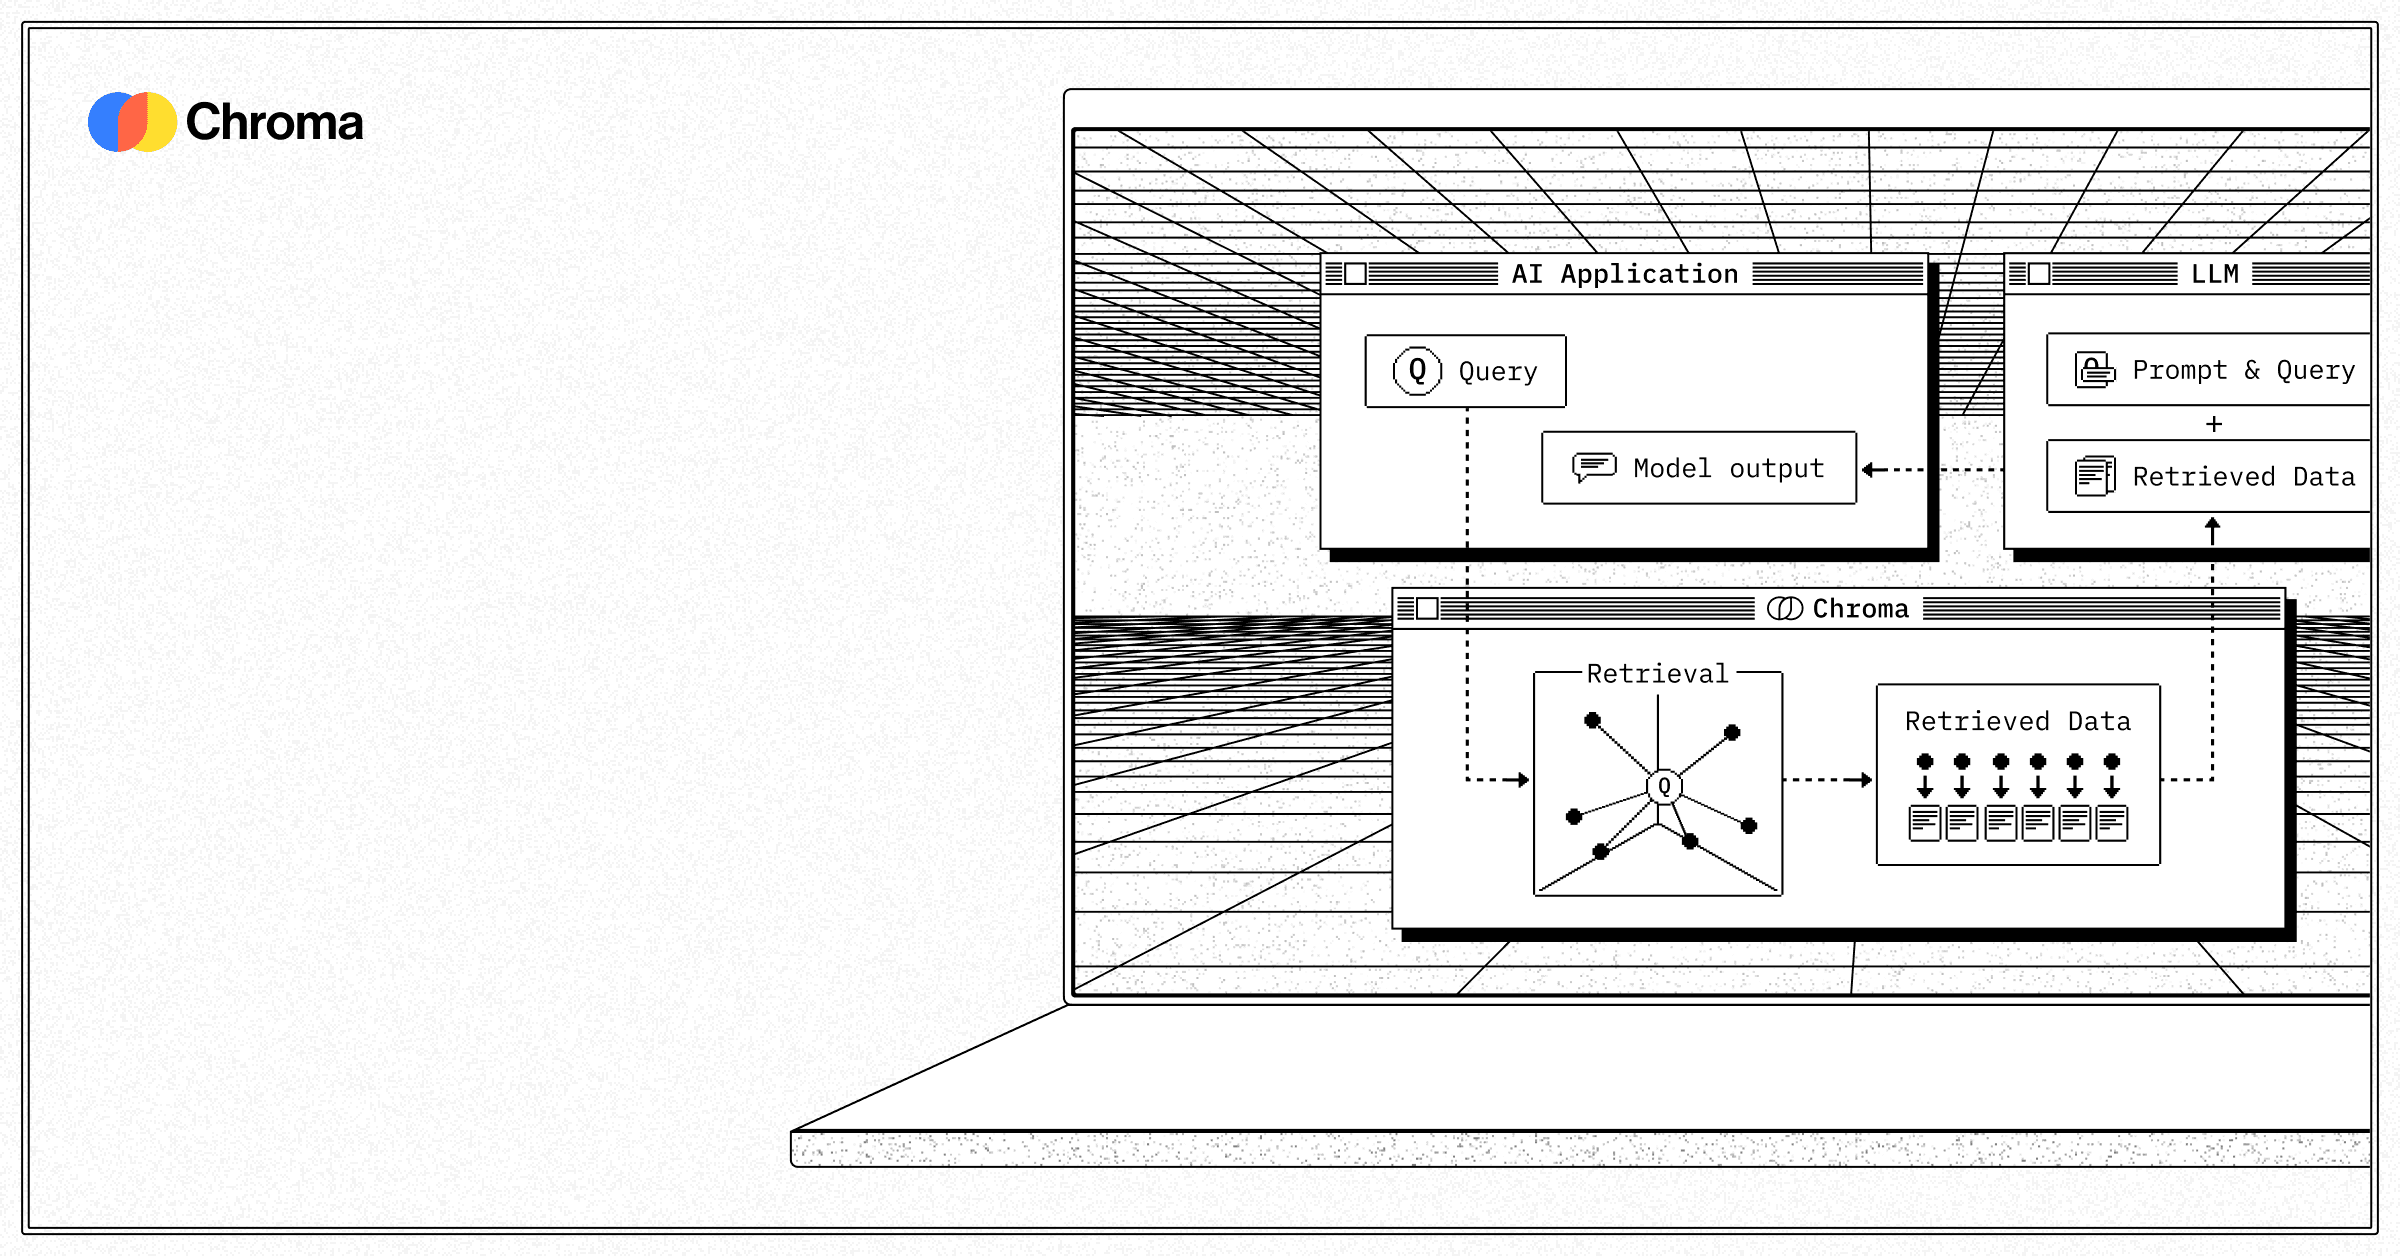
Chroma est la base de données d'embeddings open source vers laquelle les développeurs se tournent en premier pour créer des pipelines RAG. Sous licence Apache 2.0, installable en une ligne de commande et très appréciée pour son API minimaliste à quatre fonctions. Le passage à l'échelle en production est une limite connue qu'il convient de bien comprendre avant de s'engager.
Chroma est une base de données d'embeddings open source conçue pour les développeurs d'applications d'IA qui ont besoin de stocker et de récupérer des embeddings vectoriels sans la lourdeur de la gestion d'infrastructure. Fondée à San Francisco en avril 2022 par Jeff Huber (PDG) et Anton Troynikov (Directeur technique), l'entreprise a levé 18M$ en amorçage en avril 2023 et a créé l'une des bases de données vectorielles les plus citées par la communauté des développeurs, avec 27,7k étoiles GitHub en avril 2026. Le cœur du système est sous licence Apache 2.0, s'installe avec un simple pip install chromadb, et ne nécessite aucun serveur distinct pour fonctionner en mode développement.
L'API se compose de quatre opérations principales : créer une collection, ajouter des embeddings, interroger et supprimer. Ce minimalisme assumé couvre la plupart des besoins en matière de prototypage RAG. Au-delà de l'API de base, Chroma prend en charge la recherche de similarité de vecteurs denses, la recherche en texte intégral, la récupération de vecteurs creux (BM25 et SPLADE, ajoutés en novembre 2025), le filtrage par métadonnées et la recherche par expressions régulières (regex). La réécriture du cœur en Rust en 2025 a permis d'accélérer les écritures et les requêtes de 3 à 5 fois grâce à un véritable multithreading. Chroma Cloud, la version hébergée et gérée, a été lancée pour le grand public en août 2025 avec une tarification serverless, une conformité SOC 2 Type II et une hiérarchisation des données entre le cache en mémoire, les SSD et le stockage objet.
Ce que fait réellement Chroma en avril 2026
Chroma fonctionne selon trois modes en fonction de l'avancement de votre projet. En mode intégré (embedded), il s'exécute au sein de votre processus Python ou JavaScript sans saut réseau et sans aucune configuration. En mode client-serveur, chroma run lance un serveur HTTP local que vous pouvez interroger depuis n'importe quel langage disposant d'un SDK officiel. Chroma Cloud offre la version gérée avec une mise à l'échelle automatique et 5$ de crédits offerts sur le forfait Starter.
La version actuelle (v1.5.8, 16 avril 2026) utilise les collections comme unité d'organisation principale. Chaque collection contient des embeddings ainsi que leurs documents sources et des métadonnées arbitraires. Les requêtes peuvent s'effectuer par vecteur d'embedding, par texte de document (auto-embeddé), par filtre de métadonnées, ou par n'importe quelle combinaison de ces éléments. L'ajout de la recherche de vecteurs creux en novembre 2025 signifie que la récupération hybride (dense + mots-clés) est désormais une fonctionnalité de premier plan et non plus une solution de contournement.
La réécriture du cœur en Rust en 2025 a été l'étape technique la plus importante pour Chroma. L'implémentation initiale en Python était limitée par le Global Interpreter Lock, ce qui empêchait un véritable parallélisme. La réécriture en Rust a éliminé ce goulot d'étranglement et a permis des améliorations mesurées de 3 à 5 fois pour les écritures et les requêtes sur 1M d'embeddings OpenAI à 1536 dimensions. Des bindings natifs pour JavaScript, Ruby et Swift ont été ajoutés en parallèle, ce qui signifie que Chroma n'est plus un outil exclusivement centré sur Python. Des déploiements sur navigateur propulsés par WASM sont également disponibles via les bindings JS.
Chroma Sync, ajouté fin 2025, gère l'ingestion automatisée depuis des dépôts GitHub, des buckets S3 et des pages web : exploration (crawling), découpage (chunking), création d'embeddings et indexation sans gestion manuelle des pipelines. Cette fonctionnalité s'adresse aux équipes qui souhaitent une couche de données gérée pour le RAG, et pas seulement un backend de stockage.
Où se situe Chroma par rapport à Qdrant et pgvector
Trois outils dominent les conversations des développeurs sur l'endroit où stocker les embeddings : Chroma, Qdrant et pgvector. Ils occupent des positions très différentes.
Qdrant est écrit en Rust depuis le début (il ne s'agit pas d'une réécriture, mais d'un outil natif dès le premier jour) et a été conçu spécifiquement pour la recherche vectorielle filtrée à l'échelle de la production. Son indexation HNSW avec filtrage de la charge utile (payload) permet de combiner la correspondance de similarité et les contraintes de métadonnées (plages numériques, correspondances de texte, coordonnées géographiques) tout en maintenant des temps de requête inférieurs à 5 ms à grande échelle. Qdrant prend en charge le clustering multi-nœuds distribué comme fonctionnalité de premier plan et gère des charges de travail vectorielles de l'ordre du milliard en production. La réécriture en Rust de Chroma réduit l'écart de performances brutes, mais l'architecture distribuée de Qdrant est structurelle. Une collection Chroma est fondamentalement mono-nœud. Les clusters Qdrant ne le sont pas.
pgvector est une extension PostgreSQL, et non une base de données autonome. Les vecteurs, les documents et les données d'application partagent la même table, la même transaction et les mêmes requêtes SQL. Les équipes qui utilisent déjà Postgres (la majorité des stacks backend) ajoutent pgvector sans avoir besoin de nouveaux identifiants, de pipelines de synchronisation ou d'infrastructure supplémentaire à surveiller. pgvector passe facilement à l'échelle jusqu'à 5M de vecteurs sur une instance Postgres standard et offre des garanties ACID par défaut. Le compromis : pgvector n'a pas de mode intégré en mémoire, nécessite un serveur Postgres en cours d'exécution même en développement, et ne dispose pas de l'API native Python de Chroma pour les équipes qui ne maîtrisent pas déjà SQL.
L'arbre de décision pratique sur lequel la plupart des équipes s'accordent : utilisez Chroma pour le développement local et les prototypes, évaluez pgvector si votre backend utilise déjà Postgres, et passez à Qdrant (ou Weaviate, Pinecone) si vous avez besoin d'une distribution en production ou d'une indexation à l'échelle du milliard. Le livre de recettes (cookbook) de la communauté Chroma contient un guide littéralement intitulé "Road to Production" qui recommande ouvertement d'envisager des alternatives à grande échelle, ce qui est d'une honnêteté inhabituelle pour la propre documentation d'un fournisseur.
"ChromaDB est généralement une option décente si vous disposez d'un matériel performant et que vous devez construire un prototype rapidement. Mais si vous prévoyez de passer en production, il est logique de se tourner vers des solutions plus matures." - Olexander Hryhor, Architecte de solutions chez AltexSoft, 2025
À quoi ressemble le flux de travail de développement quotidien
Le flux de travail typique de Chroma commence dans un terminal. Installez, importez, créez un client, créez une collection, ajoutez des documents avec leurs embeddings, interrogez par texte. Un pipeline de récupération RAG fonctionnel est réalisable en cinq à dix lignes de Python, souvent en moins de quinze minutes sur une nouvelle machine. Il n'y a pas de serveur à démarrer en mode intégré, pas de clé API à configurer, et aucun schéma à définir au préalable.
LangChain et LlamaIndex traitent tous deux Chroma comme une intégration de premier plan. Définir Chroma comme un magasin de vecteurs (vector store) dans l'un ou l'autre de ces frameworks se fait en une seule ligne. C'est pourquoi Chroma apparaît dans la majorité des tutoriels RAG : la barrière à l'entrée pour obtenir une démo fonctionnelle est plus basse que pour n'importe quelle autre alternative.
C'est lors de la transition vers une utilisation réelle que des frictions apparaissent. Passer du mode intégré au mode client-serveur nécessite l'exécution d'un processus distinct. Passer à Chroma Cloud nécessite de mettre à jour l'initialisation du client et de gérer les clés API. Aucune de ces étapes n'est compliquée, mais toutes deux demandent un travail qui surprend les développeurs qui pensaient que "ça passerait à l'échelle tout seul".
L'expérience d'ingestion pour les grands ensembles de données a fait l'objet de critiques lors du lancement de Chroma Cloud sur Hacker News en août 2025. Un développeur a signalé que l'indexation de 1,2M de documents prenait des jours et était fragile. L'équipe a reconnu ce problème et a cité Chroma Sync comme la réponse structurée, mais les utilisateurs qui ont besoin de charger en masse des dizaines de millions de documents devraient tester le temps d'ingestion avant de s'engager sur la plateforme.
"La principale raison pour laquelle j'ai choisi ChromaDB est qu'il permet de jouer avec les résultats. Il vous donne plus de marge de manœuvre pour travailler sur votre pipeline et vos expériences." - Ismail Aslan, Ingénieur en Machine Learning chez AltexSoft, 2025
À qui s'adresse Chroma
Chroma est conçu pour les développeurs qui en sont aux premiers ou moyens stades d'une application d'IA. Plus précisément : les ingénieurs ML qui prototypent des pipelines de récupération et souhaitent changer de modèles d'embedding sans revoir l'architecture de l'infrastructure. Les data scientists qui construisent des preuves de concept RAG pour les présenter aux parties prenantes. Les développeurs d'applications qui intègrent la recherche sémantique et ne veulent pas provisionner et gérer un service de base de données distinct. Les équipes de l'écosystème LangChain ou LlamaIndex qui souhaitent un backend local sans configuration.
Chroma Cloud élargit la cible aux petits déploiements en production avec une concurrence modérée et des collections de moins de quelques millions de vecteurs. Le forfait Team à 250$/mois inclut la conformité SOC 2 et le support Slack, ce qui couvre les besoins de nombreux produits SaaS en phase de démarrage.
La communauté décrit Chroma comme "le SQLite du monde vectoriel", ce qui est exact dans les deux sens : rapide à adopter, largement utilisé en développement, mais avec des limites documentées qui redirigent le trafic de production sérieux vers d'autres solutions.
Ce que Chroma n'est pas
Chroma n'est pas une base de données distribuée. La version open source est mono-nœud. Il n'y a pas de réplication intégrée ni de haute disponibilité. Si la machine exécutant Chroma tombe en panne, le service est interrompu. C'est parfait pour le développement et acceptable pour de petits outils internes. C'est en revanche une lacune importante pour les systèmes en production nécessitant une disponibilité de 99,9%+.
Chroma ne fournit pas d'isolation multi-locataire (multi-tenancy) dans sa version open source. Construire un produit SaaS où les données des différents clients doivent être isolées nécessite soit des collections séparées par locataire (gérable à petite échelle, fastidieux avec des centaines de locataires), soit une architecture de base de données différente.
Chroma ne prend pas en charge la recherche vectorielle accélérée par GPU. Toute l'indexation et la récupération sont basées sur le CPU. Pour des charges de travail de centaines de millions de vecteurs ou nécessitant une latence inférieure à la milliseconde avec une forte concurrence, la recherche uniquement sur CPU devient le goulot d'étranglement.
Les équipes utilisant principalement Azure rencontrent des frictions supplémentaires : Chroma n'a pas d'intégration native avec Azure. Le déploiement sur Azure nécessite des conteneurs Docker plutôt qu'un support de service géré de première partie. Les équipes fortement investies dans l'écosystème Azure trouveront peut-être Azure AI Search ou Cosmos DB plus simples à exploiter.
Le calendrier de lancement de Chroma Cloud mérite également d'être souligné. Chroma Cloud était promis pour fin 2023 et a été rendu disponible pour le grand public en août 2025, avec environ deux ans de retard. Le produit est arrivé avec des fonctionnalités solides, mais le retard a été suffisamment long pour que de nombreux développeurs ayant besoin d'un hébergement géré soient déjà passés à Pinecone ou Weaviate. Que ce retard affecte ou non votre décision dépend de l'importance de Chroma Cloud dans votre architecture par rapport à l'option auto-hébergée.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant Chroma.
Articles associés
Guides et articles en lien avec Chroma.

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Coding Ate Enterprise AI (2026): The $4B Use Case, Anthropic’s Share, and Seat vs API Math

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
