
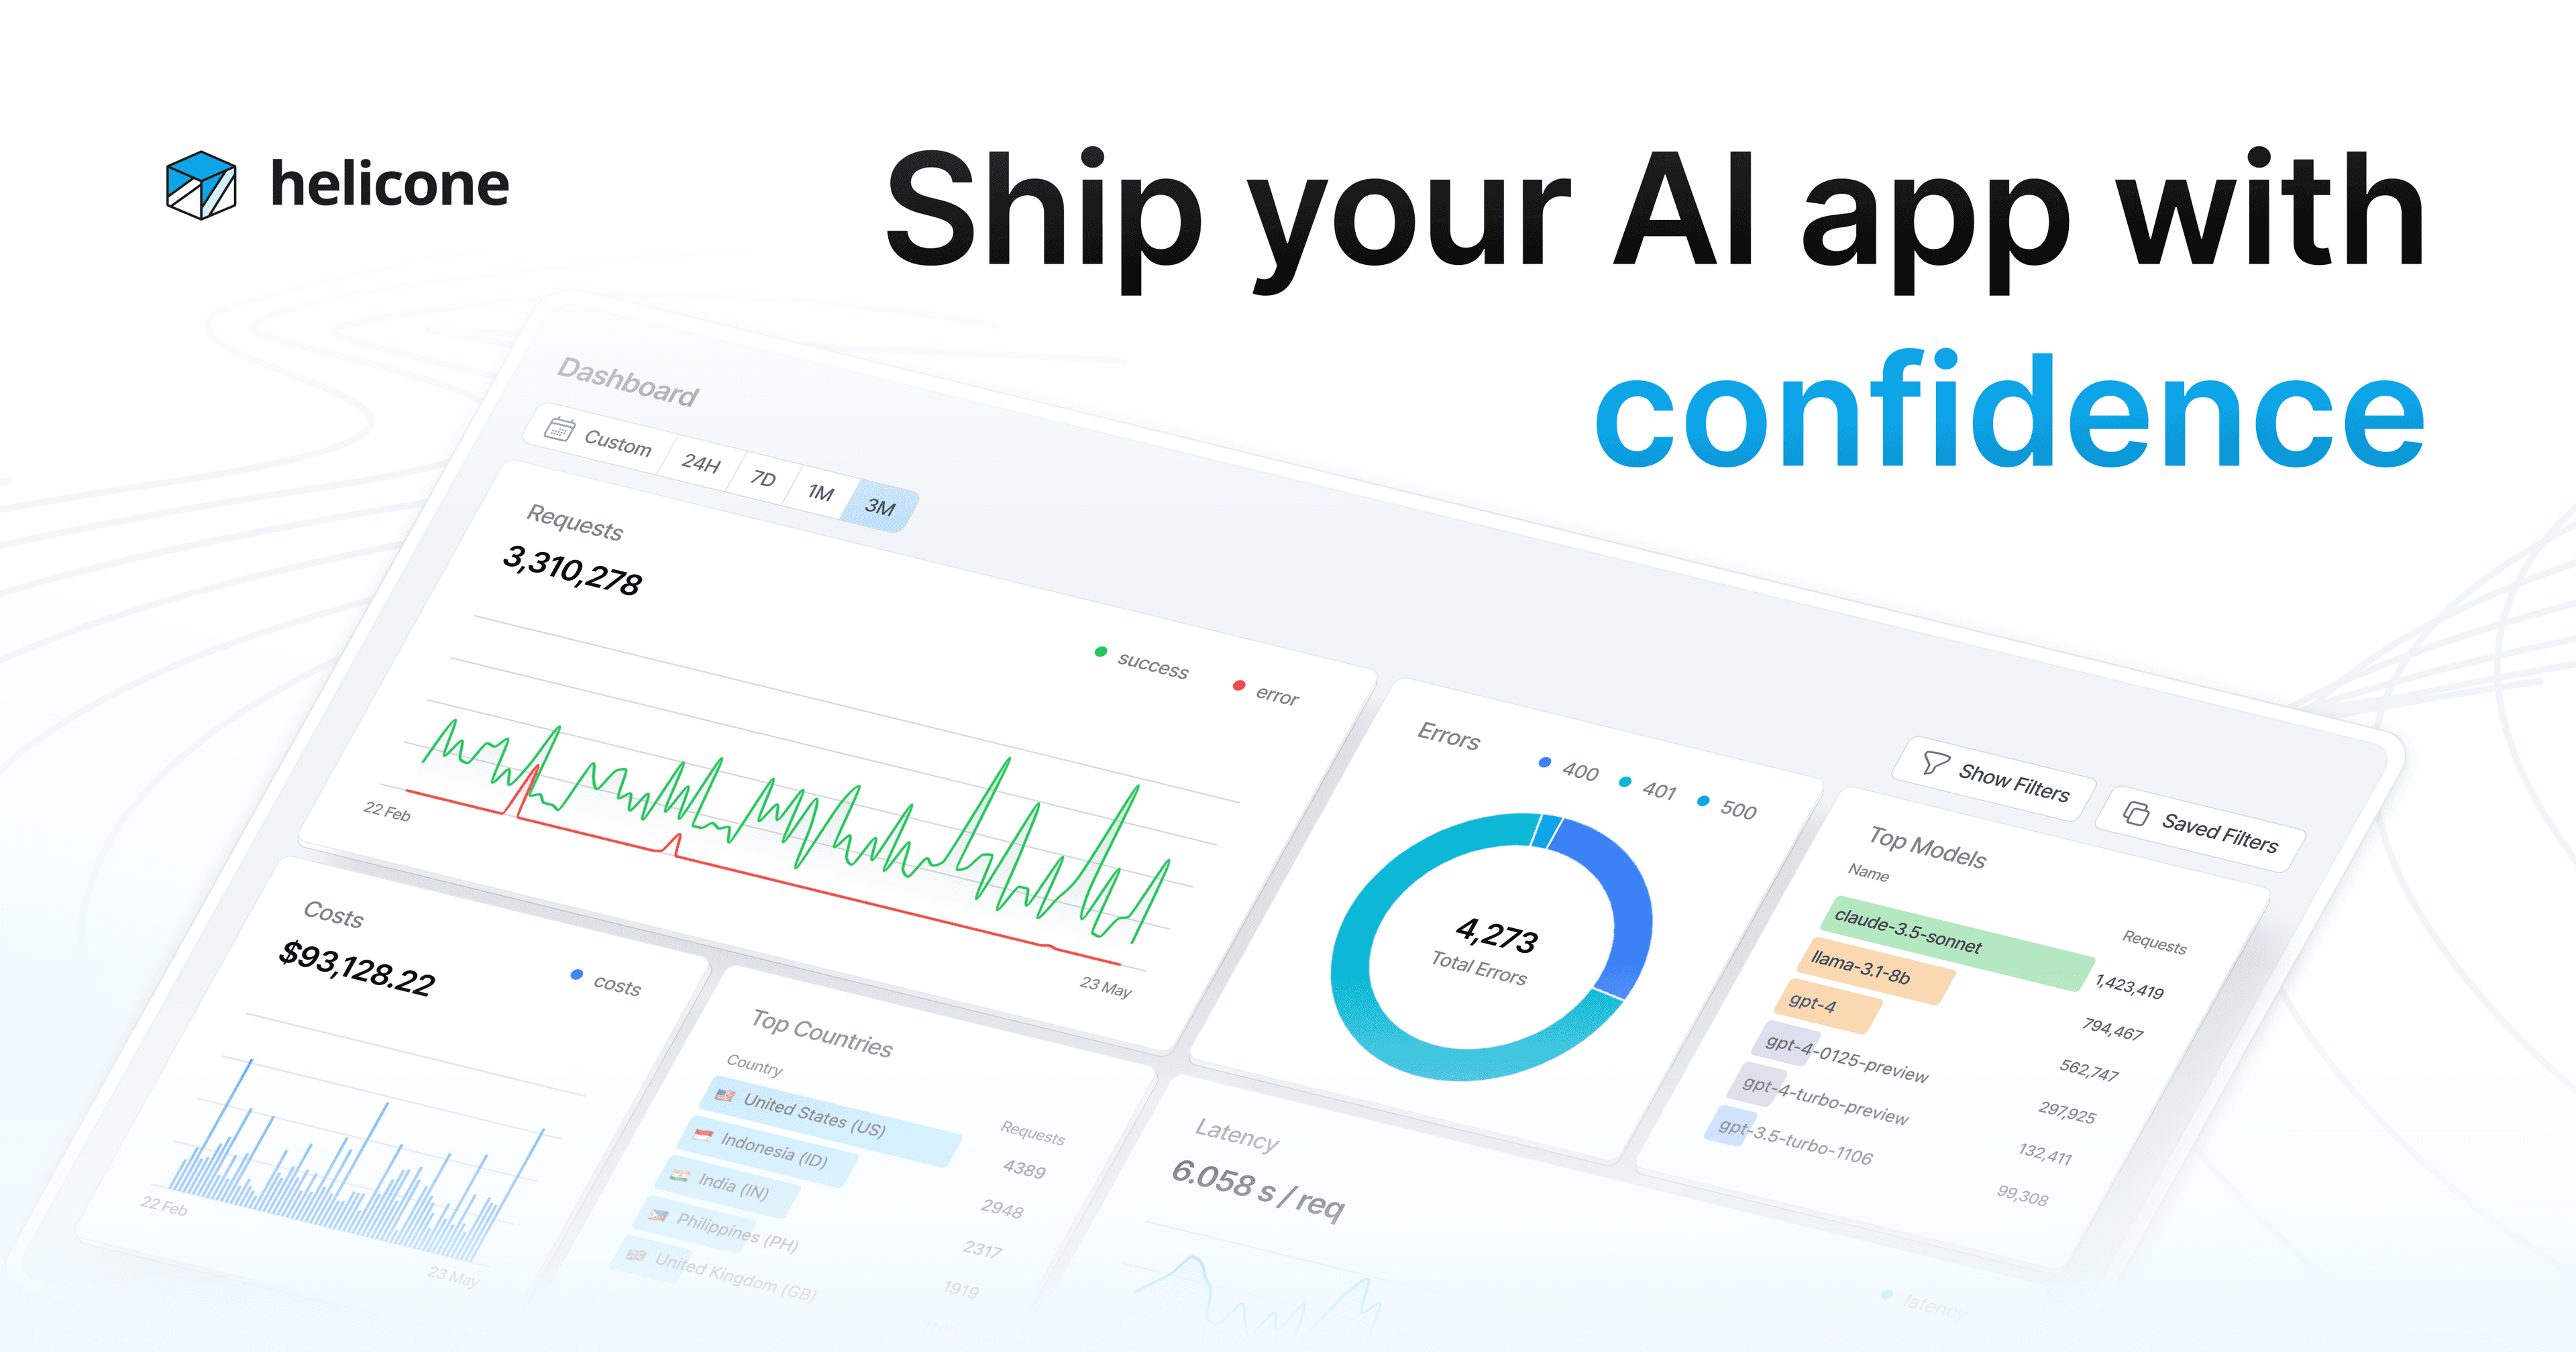
Helicone est une plateforme d'observabilité LLM open source et une passerelle IA issue de YC W23. Un simple changement d'URL offre aux équipes le suivi des coûts, la journalisation des requêtes, la mise en cache sémantique et la gestion des prompts sur OpenAI, Anthropic et plus de 100 modèles. Utilisé par 16 000 organisations avant son rachat en mars 2026 par Mintlify.
Helicone est une plateforme d'observabilité LLM open source et une passerelle IA conçue par Justin Torre et Cole Gottdank, lancée lors de la promotion YC W23 de Y Combinator en 2023. Le problème central qu'elle résout est très concret : lorsque les équipes commencent à déployer des applications d'IA, elles perdent rapidement en visibilité sur ce que font réellement leurs LLM, ce qu'ils coûtent et où ils échouent. Helicone restaure cette visibilité grâce à une architecture basée sur un proxy, en acheminant les requêtes via sa passerelle basée sur Cloudflare Workers afin que chaque appel vers OpenAI, Anthropic, Gemini, Mistral ou DeepSeek soit automatiquement journalisé, chronométré et analysé. Avant le rachat de l'entreprise par Mintlify le 3 mars 2026, Helicone avait traité 14,2 billions de tokens pour 16 000 organisations actives.
La fonctionnalité phare de la plateforme est son intégration en une seule ligne : modifiez votre URL de base OpenAI pour pointer vers la passerelle d'Helicone et l'ensemble de votre application est instantanément instrumenté, sans nécessiter d'encapsulation SDK. Au-delà de la journalisation de base, Helicone propose la mise en cache sémantique (qui, selon les équipes, réduit régulièrement les coûts des LLM de 20 à 40 %), le routage AI Gateway avec basculement automatique entre fournisseurs, le versionnage et la gestion des prompts, HQL (Helicone Query Language) pour des requêtes d'analyse personnalisées, la limitation de débit, ainsi qu'un terrain de jeu (Playground) pour tester des variantes de prompts sur des échantillons de données de production réelles. La plateforme est sous licence Apache 2.0 et entièrement auto-hébergeable via Docker ou Helm. Depuis son rachat en mars 2026 par Mintlify, Helicone fonctionne en mode maintenance avec la poursuite des correctifs de sécurité, la prise en charge de nouveaux modèles et la correction de bugs, mais sans développement de nouvelles fonctionnalités majeures.
Ce que fait réellement Helicone en avril 2026
Helicone fonctionne comme un proxy HTTP transparent situé entre votre application et n'importe quel fournisseur de LLM. Lorsque vous appelez openai.baseURL = "https://oai.helicone.ai/v1", la requête transite par le réseau edge Cloudflare Workers d'Helicone, est enregistrée dans ClickHouse pour l'analyse, puis est transmise à OpenAI avec une surcharge inférieure à 5 ms selon le benchmark de latence p50. La plateforme prend en charge plus de 100 modèles via son AI Gateway unifiée, notamment OpenAI, Anthropic, Azure OpenAI, Google Gemini, DeepSeek, Mistral, Together AI, OpenRouter et Groq. La prise en charge de l'intégration s'étend à plus de 30 frameworks, dont LangChain, LlamaIndex, le Vercel AI SDK et LiteLLM.
Le tableau de bord d'observabilité présente des métriques de coût, de latence et de qualité réparties par utilisateur, session, point de terminaison et modèle. Les équipes utilisent HQL pour écrire des requêtes personnalisées sur l'historique de leurs requêtes, à l'instar des analyses SQL appliquées aux journaux de leurs LLM. La fonctionnalité Prompts permet le versionnage des prompts lié aux données de production réelles, avec le déploiement de nouvelles versions directement via la passerelle sans déploiement de code. La fonctionnalité Datasets d'Helicone permet aux équipes de créer des ensembles d'évaluation à partir d'un échantillonnage du trafic de production, tandis que le Playground prend en charge le test en direct des variantes de prompts avant leur mise en production. Les alertes et rapports intégrés couvrent les pics de coûts, les taux d'erreur et les anomalies de latence.
La plateforme a gagné sa place dans l'écosystème en partie grâce à son timing : elle a été lancée à une époque où la journalisation des appels LLM nécessitait la création de middlewares personnalisés, et elle a véritablement résolu ce problème avec un minimum de friction. Au moment de son rachat, c'était l'outil d'observabilité LLM le plus utilisé parmi les entreprises du portefeuille YC et il avait été numéro 1 sur Product Hunt le jour de son lancement.
"Helicone fonctionne tout simplement dès le départ, c'est vraiment utile pour nous permettre de creuser les problèmes des utilisateurs" - Brandon Chen, Product Hunt, 2024
Où se situe Helicone par rapport à Langfuse et LangSmith
La différence mécanique entre ces trois plateformes est architecturale, et non cosmétique. Helicone intercepte au niveau de la couche réseau, se plaçant entre le code de votre application et le point de terminaison de l'API du fournisseur de LLM. Il voit les requêtes et réponses HTTP individuelles. Langfuse et LangSmith s'intègrent au niveau de la couche applicative, en encapsulant les étapes des agents et la logique de workflow dans votre code avec des appels SDK. Cette distinction détermine ce que chaque plateforme peut réellement observer.
Langfuse (licence MIT, plus de 19 000 étoiles GitHub, auto-hébergeable) nécessite une instrumentation SDK explicite : les développeurs encapsulent chaque étape d'agent, span de trace et hook d'évaluation dans des appels SDK Langfuse. La configuration prend 1 à 2 heures, mais offre une visibilité complète sur les workflows d'agents à plusieurs étapes avec des hiérarchies de spans imbriquées. Langfuse voit que l'appel LLM B a été déclenché par l'appel d'outil A dans l'exécution de l'agent X, ce que le proxy d'Helicone ne peut pas capturer sans un balisage manuel des en-têtes. Langfuse dispose également d'un système de gestion des prompts et d'évaluation des jeux de données plus mature. L'option auto-hébergée est entièrement gratuite ; la version cloud commence à 50 $/mois avec un niveau gratuit généreux de 50 000 événements/mois. Pour les équipes qui souhaitent auto-héberger leurs données d'observabilité dans leur propre infrastructure, Langfuse est le choix évident.
LangSmith (le produit d'observabilité de LangChain, 39 $/mois pour la version Plus) est couplé au framework. Pour les équipes utilisant déjà LangChain ou LangGraph, le traçage se fait presque sans configuration via deux variables d'environnement. LangSmith comprend nativement la topologie des chaînes LangChain, sait quel outil a déclenché quel appel LLM et fait remonter ce contexte automatiquement. Pour les équipes n'utilisant pas LangChain, l'instrumentation manuelle prend 2 à 3 heures et LangSmith perd son principal avantage. En mars 2025, LangChain a ajouté la prise en charge de bout en bout d'OpenTelemetry à LangSmith, réduisant ainsi quelque peu la dépendance vis-à-vis du fournisseur. Le système d'évaluation intégré de LangSmith et son terrain de jeu par exécution sont plus approfondis que les fonctionnalités équivalentes d'Helicone.
Les avantages d'Helicone par rapport aux deux autres sont la rapidité de configuration (moins de 15 minutes, aucune modification du code de l'application) et la mise en cache sémantique intégrée, que ni Langfuse ni LangSmith n'offrent nativement. À 79 $/mois pour un nombre illimité d'utilisateurs, Helicone est également moins cher que les deux autres pour les équipes en pleine croissance. Le compromis : Helicone voit les appels API individuels, et non la topologie du workflow. Si votre application est une simple chaîne d'appels LLM, Helicone vous offre tout ce dont vous avez besoin. S'il s'agit d'un agent complexe à plusieurs étapes où vous devez comprendre pourquoi l'étape 7 a déclenché un appel de modèle particulier, vous avez besoin de Langfuse ou de LangSmith.
"Cela me donne des informations extrêmement utiles et détaillées sur l'utilisation, les coûts et les temps de réponse" - Ryan Hendrickson, Product Hunt, 2024
À quoi ressemble la réalité du proxy au quotidien
L'expérience d'intégration tient véritablement ses promesses. Pour une équipe effectuant des appels OpenAI, le changement se résume à une ligne dans le constructeur du client OpenAI. Pour une équipe Anthropic, il s'agit de la même manière d'un simple remplacement d'en-tête. À partir de ce moment, chaque requête apparaît dans le tableau de bord d'Helicone. Le suivi des coûts est automatique : Helicone associe chaque modèle et nombre de tokens à la tarification actuelle de son fournisseur et vous montre exactement ce que chaque point de terminaison, utilisateur ou fonctionnalité coûte par jour. Les centiles de latence (p50, p90, p99) sont répartis par modèle et par type de requête.
La mise en cache sémantique est la fonctionnalité que la plupart des équipes citent lorsqu'elles décrivent le retour sur investissement. Helicone intègre chaque requête, vérifie dans le cache s'il existe des réponses antérieures sémantiquement similaires dans la limite d'un seuil de similarité configurable, et renvoie la réponse mise en cache si le seuil est atteint. Les équipes ayant des charges de travail très répétitives (bots de support client, systèmes de questions-réponses sur des documents, assistants de codage) signalent couramment des réductions de coûts de 20 à 40 % dans la semaine suivant son activation. La configuration s'effectue via le tableau de bord, et non par le code.
Les frustrations qui font surface en production ont tendance à se concentrer sur ce que l'architecture proxy ne peut pas voir. Lorsqu'un workflow d'agent échoue après sept étapes, le tableau de bord d'Helicone affiche sept appels API individuels avec leurs coûts et latences, mais pas la façon dont ils sont connectés ni quelle décision en amont a déclenché l'échec. Le débogage des échecs d'agents à plusieurs étapes via Helicone nécessite un balisage manuel des sessions et une corrélation des traces, ce qui annule l'avantage du "sans modification de code". Les équipes qui atteignent cette complexité ajoutent généralement Langfuse comme deuxième couche ou migrent entièrement.
À qui s'adresse Helicone
Helicone est l'outil idéal pour les équipes qui ont besoin d'une observabilité LLM rapidement et qui ne souhaitent pas instrumenter leur base de code. Les principaux bénéficiaires sont les équipes produit IA en phase de démarrage (2 à 20 ingénieurs), les équipes exécutant des pipelines LLM simples plutôt que des agents complexes à plusieurs étapes, et les équipes soucieuses des coûts qui souhaitent une mise en cache et des analyses sans avoir à construire d'infrastructure.
Il fonctionne particulièrement bien pour les entreprises multi-modèles qui exécutent des requêtes auprès de plusieurs fournisseurs. Le tableau de bord unifié regroupe les coûts d'OpenAI, d'Anthropic et d'autres fournisseurs dans une vue unique, ce qui est plus difficile à reproduire avec les seuls outils natifs des fournisseurs. Pour les startups qui itèrent rapidement sur les prompts, les fonctionnalités Playground et Datasets permettent aux non-ingénieurs de mener des expériences de prompts sur des échantillons de données de production sans toucher au code. Pour les équipes de moins de 10 personnes qui ont juste besoin de répondre à la question "quelles sont nos dépenses LLM ce mois-ci et quelle fonctionnalité en est la cause", Helicone est sans doute surdimensionné mais tout à fait adéquat.
La conformité SOC-2 et HIPAA est incluse dans le forfait Team à 799 $/mois, ce qui exclut les petites équipes ayant besoin de conformité. Les entreprises ayant des exigences strictes en matière de résidence des données dans l'UE peuvent trouver le modèle de proxy inconfortable, même avec le réseau edge de Cloudflare : chaque requête LLM, y compris le contenu utilisateur, passe par l'infrastructure d'Helicone. Le fil de discussion de lancement sur HN en mars 2023 a explicitement soulevé ces préoccupations, de nombreux commentateurs s'interrogeant sur les PII de l'UE et sur la question de savoir si l'architecture proxy violait les conditions d'utilisation d'OpenAI. Helicone a répondu aux deux questions, mais la réalité architecturale d'un proxy cloud gérant le trafic de production reste un élément à prendre en compte pour les cas d'utilisation sensibles aux données.
Ce que Helicone n'est pas
Helicone est une couche de surveillance, et non une plateforme d'observabilité full-stack. Il ne prend pas en charge les pipelines d'évaluation de prompts avec notation automatisée, détection de régression ou mesure de la qualité de la suite d'évaluation. Sa fonctionnalité Scores permet d'attribuer des notes numériques manuelles aux requêtes, ce qui est basique comparé aux systèmes d'évaluation de Langfuse ou de Braintrust. Lorsqu'une requête échoue ou produit un mauvais résultat, Helicone la journalise, mais il n'y a pas de machine à états pour les problèmes, pas de suivi du cycle de vie, aucun mécanisme pour déterminer si un problème récurrent a été résolu ou a régressé.
Le statut de mode maintenance depuis mars 2026 est également un contexte pertinent. Les équipes qui choisissent Helicone aujourd'hui optent pour un produit en fin de vie : les correctifs de sécurité et l'ajout de nouveaux modèles se poursuivront, mais la feuille de route du produit s'est arrêtée. Pour les équipes ayant un horizon pluriannuel et qui ont besoin d'un développement actif de la plateforme d'observabilité dont elles dépendent, il s'agit d'une véritable contrainte. L'équipe d'Helicone a explicitement nommé LiteLLM et Portkey comme alternatives pour les équipes recherchant un développement actif continu.
Démarrer avec Helicone
Le parcours d'intégration est la fonctionnalité la plus forte de la plateforme. Créez un compte gratuit sur helicone.ai, copiez votre clé API Helicone et remplacez l'URL de base de votre client OpenAI par https://oai.helicone.ai/v1 en ajoutant la clé Helicone comme en-tête. Ce seul changement envoie tout le trafic OpenAI via Helicone. Pour Anthropic, pointez vers https://anthropic.helicone.ai. Pour Azure OpenAI, Google Gemini et d'autres, Helicone fournit des URL de passerelle spécifiques aux fournisseurs. Le temps typique jusqu'à la première requête journalisée est inférieur à cinq minutes.
Le niveau gratuit Hobby gère 10 000 requêtes/mois avec une rétention de 7 jours, ce qui est suffisant pour le développement et une utilisation légère en production. Le forfait Pro à 79 $/mois débloque un nombre illimité d'utilisateurs, une rétention d'un mois, des alertes et des requêtes d'analyse HQL. L'auto-hébergement est documenté pour Docker et Helm avec la pile complète de cinq services (NextJS web, Cloudflare Worker, Express API, Supabase, ClickHouse, MinIO). Pour les équipes qui doivent conserver leurs données hors d'une infrastructure tierce, l'auto-hébergement est viable, bien qu'il nécessite la maintenance de la pile. Le dépôt GitHub sur github.com/Helicone/helicone compte 5,6 k étoiles et un composant de passerelle IA basé sur Rust avec des résultats de benchmark montrant une surcharge p50 inférieure à 5 ms à haut débit.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant Helicone.
Articles associés
Guides et articles en lien avec Helicone.
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Replace 6 SaaS Subscriptions With 4 n8n AI Agents (2026)
