LlamaIndex est un framework de données open source développé par LlamaIndex, Inc. pour créer des applications RAG sur des données privées. Il inclut plus de 300 connecteurs de données, un découpage hiérarchique intégré et LlamaParse pour l'analyse de documents de niveau entreprise. Cœur open source gratuit ; LlamaCloud à partir de 50 $/mois.
LlamaIndex est un framework de données open source conçu par LlamaIndex, Inc. pour les développeurs qui connectent des sources de données privées à de grands modèles de langage. Initialement lancé fin 2022 sous le nom de GPT Index par Jerry Liu et Simon Liu, le projet a atteint près de 49 000 étoiles GitHub et 25 millions de téléchargements mensuels de paquets en avril 2026. La bibliothèque principale est sous licence MIT et son utilisation commerciale est gratuite. La couche commerciale de l'entreprise, LlamaCloud, ajoute des services gérés d'analyse, d'extraction et d'indexation au-dessus du framework open source, avec LlamaParse comme produit phare payant pour la compréhension de documents.
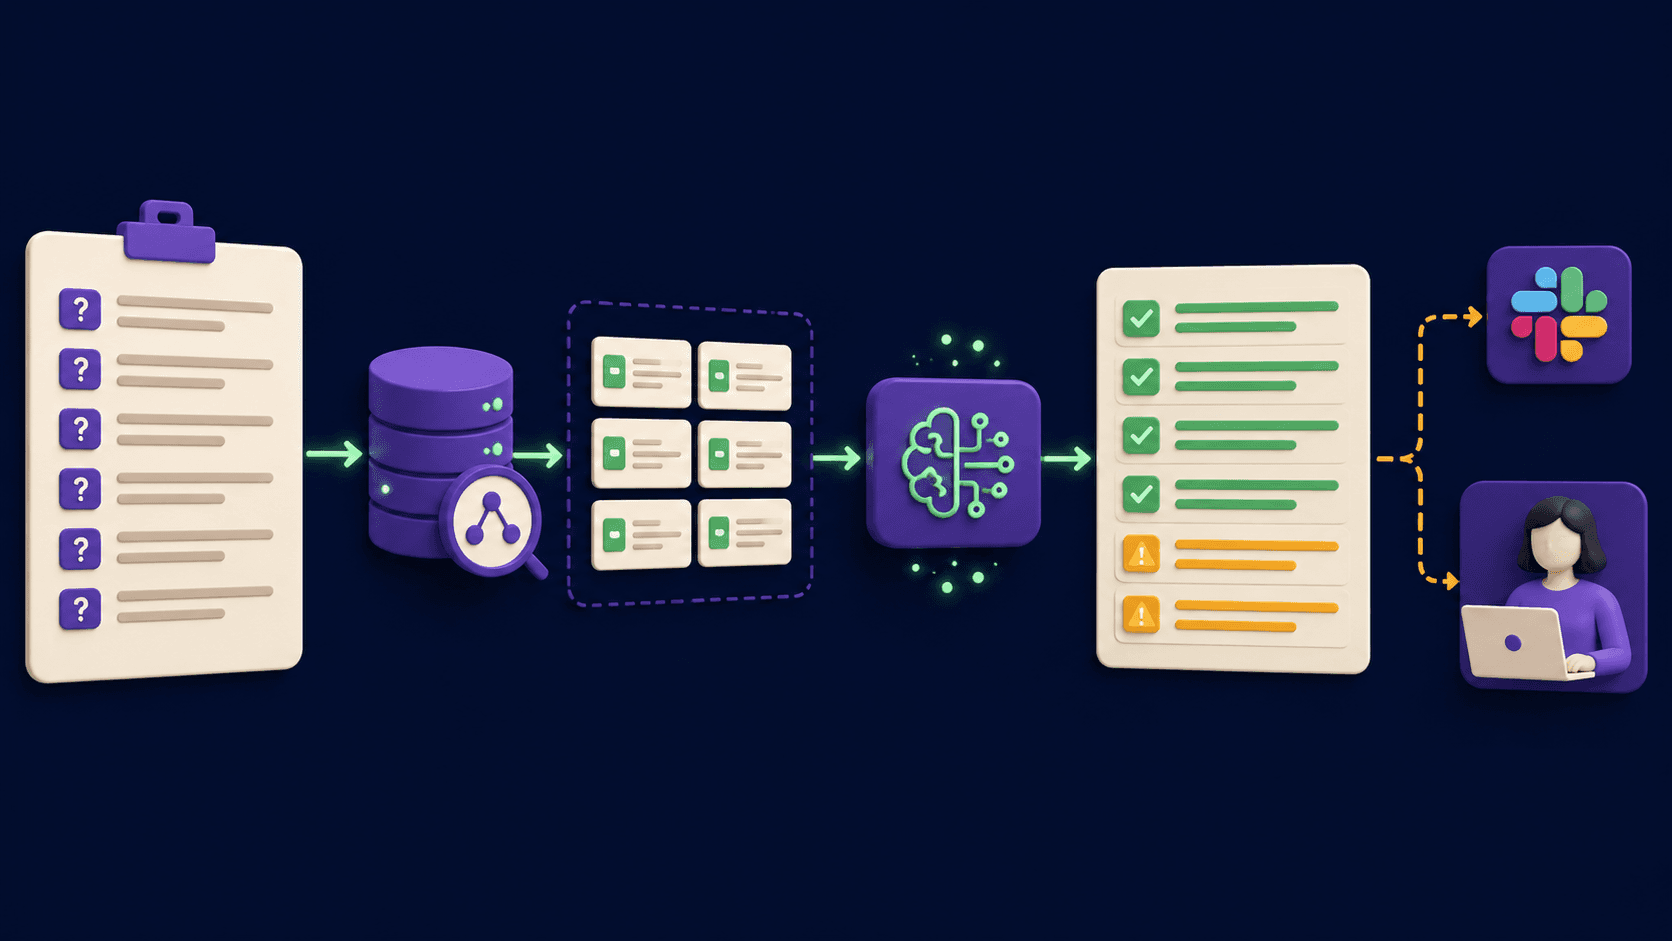
Le framework s'articule autour de cinq abstractions : les connecteurs de données (plus de 300 sources via LlamaHub), les analyseurs de nœuds pour les stratégies de découpage (chunking), les index (vecteur, résumé, mot-clé, graphe de connaissances), les moteurs de requête pour les pipelines de la récupération à la réponse, et Workflows pour l'orchestration asynchrone d'agents. Les capacités intégrées incluent le découpage hiérarchique, la recherche hybride combinant la similarité vectorielle avec la correspondance de mots-clés BM25, la décomposition en sous-questions pour les requêtes multi-documents, et un évaluateur RAG intégré qui mesure la fidélité et la pertinence sans nécessiter de plateforme d'observabilité distincte. LlamaParse gère les mises en page de documents complexes, y compris les tableaux imbriqués, les PDF à colonnes multiples, les graphiques et les notes manuscrites, en utilisant des agents propulsés par des VLM qui dirigent le contenu vers des modèles d'analyse spécialisés.
Ce que fait réellement LlamaIndex en avril 2026
Le framework s'est considérablement développé au-delà de ses racines de pipeline RAG. La version actuelle (v0.14.21, 21 avril 2026) inclut Workflows, un système complet d'orchestration d'agents asynchrones basé sur la transmission d'événements plutôt que sur des graphes orientés. LlamaAgents, lancé en 2025, permet le déploiement en un clic d'agents de traitement de documents avec des modèles prêts à l'emploi pour le traitement des factures, la révision de contrats et la gestion des sinistres, tous construits sur la bibliothèque Workflows.
LlamaParse v2, sorti le 18 décembre 2025, a réorganisé l'analyse en quatre niveaux : Fast (1 crédit par page, documents centrés sur le texte), Cost-effective (3 crédits par page, usage général), Agentic (10 crédits par page, mises en page complexes avec contenu mixte), et Agentic Plus (45 crédits par page, précision maximale). La version v2 a réduit les coûts d'Agentic Plus de 50 % et a ajouté l'épinglage de version (version pinning) afin que les pipelines de production se verrouillent sur un comportement d'analyse spécifique et ne se cassent pas lors des mises à jour automatiques. Les outils supplémentaires lancés en 2025 incluent LlamaSheets (données de tableur prêtes pour l'IA), LlamaSplit (séparation automatique de documents à partir de fichiers regroupés) et le mode Table Row de LlamaExtract pour extraire des entités répétitives à partir de documents structurés.
LlamaCloud a obtenu la certification SOC 2 Type 2 et la conformité RGPD/HIPAA suite à l'annonce de sa série A en mars 2025. Il se déploie en mode SaaS ou sur site (VPC). Les clients dévoilés lors de la disponibilité générale (General Availability) incluent Rakuten, Carlyle, Salesforce et KPMG. L'entreprise fait état de 1 milliard de documents traités et de 300 000 utilisateurs de LlamaParse.
Où se situe LlamaIndex par rapport à LangChain et Haystack
LlamaIndex vs. LangChain : Les architectures divergent au niveau de l'unité de travail fondamentale. LlamaIndex traite la récupération (retrieval) comme l'abstraction principale : les connecteurs de données, les stratégies de découpage, les index et les moteurs de requête sont tous des objets de première classe. LangChain traite les agents comme l'abstraction principale, la récupération n'étant qu'un composant assemblé manuellement avec des séparateurs de texte, des bases de données vectorielles, des récupérateurs et des re-classeurs (re-rankers). Le résultat pratique est qu'un pipeline RAG de base nécessite environ 30 à 40 % de code en plus dans LangChain que dans LlamaIndex, et l'équivalent dans LangChain du découpage hiérarchique de LlamaIndex nécessite un assemblage manuel des composants. LlamaIndex a une surcharge de framework d'environ 6 ms et une surcharge de 1,6K tokens par requête ; LangGraph se situe à environ 14 ms et 2,4K tokens dans les benchmarks de production. Cependant, LangChain domine en termes de taille de communauté, de tutoriels et d'offres d'emploi, et LangSmith fournit une observabilité de première partie qui manque nativement à LlamaIndex (qui s'appuie sur des outils tiers comme Langfuse ou Phoenix). De nombreuses équipes de production finissent par utiliser les deux : LlamaIndex comme couche de récupération, LangGraph comme couche d'orchestration.
LlamaIndex vs. Haystack : Haystack (par deepset) utilise un modèle de pipeline modulaire explicite où le prétraitement est divisé en composants nommés : convertisseurs, nettoyeurs, séparateurs, récupérateurs et re-classeurs, chacun étant une étape du pipeline visible dans le code. Cela rend les flux de travail complexes de traitement de documents plus faciles à auditer et à maintenir dans les environnements d'entreprise. Haystack propose également un constructeur de pipeline visuel (Haystack Studio) pour lequel LlamaIndex n'a pas d'équivalent. Le compromis : LlamaParse est un service propriétaire d'analyse de documents propulsé par des VLM qui gère les mises en page complexes, les tableaux et les graphiques mieux que la pile de composants open source de Haystack (Apache Tika, Unstructured.io). Pour les pipelines de recherche de documents simples, le modèle de pipeline explicite de Haystack l'emporte sur la clarté ; pour les applications où la qualité de l'analyse des documents est le goulot d'étranglement, l'approche axée sur les données de LlamaIndex et la précision de LlamaParse font la différence. La surcharge du framework pour les deux est presque identique dans les benchmarks (Haystack ~5,9 ms/1,57K tokens ; LlamaIndex ~6 ms/1,6K tokens).
À quoi ressemble la réalité du pipeline RAG au quotidien
Pour un développeur qui débute avec LlamaIndex, les 30 premières minutes sont véritablement rapides. Installer le paquet principal, pointer un SimpleDirectoryReader vers un dossier de PDF, créer un VectorStoreIndex et exécuter un moteur de requête prend moins de 20 lignes de Python. La première démo fonctionne. Les frictions commencent lors du passage de la démo à la production.
La migration vers la v0.10 en février 2024 a été le moment le plus perturbateur de l'histoire de LlamaIndex. L'équipe a divisé le paquet unique llama-index en llama-index-core plus des centaines de paquets d'intégration versionnés séparément, a déprécié ServiceContext (un objet de configuration largement utilisé) et a réécrit les abstractions de découpage. Les notebooks, les tutoriels et le code de la communauté se sont cassés sur des ImportError. Le ticket GitHub #10747 ("Breaking changes makes it hard to work with llama_index") est devenu un long fil de discussion de développeurs frustrés. Les outils de migration ont aidé, mais les équipes avec des délais serrés ont dû absorber un temps de débogage réel.
"Je ne l'utiliserai probablement plus jamais car c'est instable, l'interface change constamment, la documentation est régulièrement obsolète et les abstractions sont trop compliquées. Les documents ont entièrement changé 3 fois. C'est exaspérant." -- Développeur anonyme, GitHub Issues #10747, 2024
Depuis la v0.10, la stabilité s'est améliorée. La branche actuelle v0.14 n'a pas déclenché de plaintes équivalentes. Mais le décalage de la documentation persiste : le rythme des mises à jour est rapide, les exemples vieillissent vite, et les débutants qui suivent un tutoriel vieux de trois mois rencontrent régulièrement des erreurs qui nécessitent de croiser les informations avec le journal des modifications (changelog) ou Discord. Une fois qu'un développeur comprend suffisamment bien les abstractions de base pour lire le code source lorsque quelque chose casse, LlamaIndex devient beaucoup plus confortable.
C'est avec LlamaParse que le produit commercial gagne sa place. Pour les PDF propres et bien formatés, y compris les contrats juridiques, les déclarations financières et la documentation technique, la précision est forte. L'accueil de la communauté sur le fil de discussion Hacker News de février 2025 a été positif :
"Là où la qualité est plus importante que la quantité, je doute qu'il y ait beaucoup d'outils qui puissent s'approcher de Llamaparse." -- BenGosub, Hacker News, 7 février 2025
La mise en garde notée dans le même fil de discussion : les démos sur la page de destination de LlamaParse utilisent des rendus numériques propres. Les performances en conditions réelles sur des numérisations de mauvaise qualité, des photos de reçus et des documents manuscrits sont plus variables, et l'entreprise a reconnu que la gestion d'"une longue traîne de problèmes au-delà des simples tableaux", incluant les polices, les en-têtes, les graphiques et les champs de formulaire, est un défi permanent.
À qui s'adresse LlamaIndex
LlamaIndex convient le mieux aux développeurs Python ou TypeScript qui créent des applications où le problème central est la récupération structurée à partir de données privées : bases de connaissances d'entreprise, Q&R sur des documents, agents de données multi-sources et pipelines de traitement de contrats ou de rapports. Les équipes traitant des flux de travail riches en documents dans la finance, le juridique, la santé ou la recherche tireront le meilleur parti de LlamaParse et LlamaExtract sans avoir à créer une logique d'analyse personnalisée. Les développeurs qui souhaitent un framework orienté données et avec des partis pris forts (opinionated), qui gère le découpage, l'indexation et la récupération hybride de manière native, couvriront le même terrain que LangChain avec moins de code standard (boilerplate) pour les cas d'usage centrés sur le RAG.
Le framework open source est également bien adapté aux configurations LLM locales. Les intégrations Ollama et llama.cpp permettent aux développeurs d'exécuter l'ensemble du pipeline avec des modèles hébergés localement, en conservant toutes les données sur site sans utiliser LlamaCloud du tout. Cela rend LlamaIndex viable pour les environnements de données sensibles, même avec la version gratuite.
Ce que LlamaIndex n'est pas
LlamaIndex n'est pas un produit no-code. Il n'y a pas d'interface visuelle, pas de constructeur de pipeline par glisser-déposer, et aucune interface de chat que les utilisateurs peuvent ouvrir sans la configuration d'un développeur. Les utilisateurs non techniques ne peuvent pas l'utiliser directement.
Ce n'est pas le meilleur choix pour les équipes dont le besoin principal est l'orchestration complexe d'agents plutôt que la récupération de données. Si l'application concerne fondamentalement le raisonnement en plusieurs étapes, l'utilisation d'outils, la mémoire et les boucles d'agents sur des API web plutôt que des données privées riches en documents, l'écosystème plus large de LangChain/LangGraph et son observabilité de première partie (LangSmith) constituent un meilleur point de départ. De même, si l'équipe a besoin d'un constructeur de pipeline d'entreprise visuel pour les flux de travail gérés par l'informatique, Haystack Studio répond plus directement à ce besoin.
LlamaParse à grande échelle devient rapidement coûteux. Au niveau Agentic (10 crédits par page, 0,0125 $ par page), le traitement de 100 000 pages par mois coûte 1 250 $ en crédits d'analyse avant l'abonnement au forfait Pro à 500 $. Le traitement par lots à volume élevé sur des documents bruités devrait faire l'objet d'un calcul de coûts avant de s'engager.
Enfin, pour les équipes encore sur la v0.9 ou antérieure, la migration vers la branche actuelle v0.14 nécessite un effort délibéré. Les changements d'architecture de la v0.10 ne sont pas rétrocompatibles. Prévoyez du temps pour la migration avant de vous fier aux exemples de la communauté qui supposent la structure de paquets actuelle.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant LlamaIndex.
Articles associés
Guides et articles en lien avec LlamaIndex.

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)