
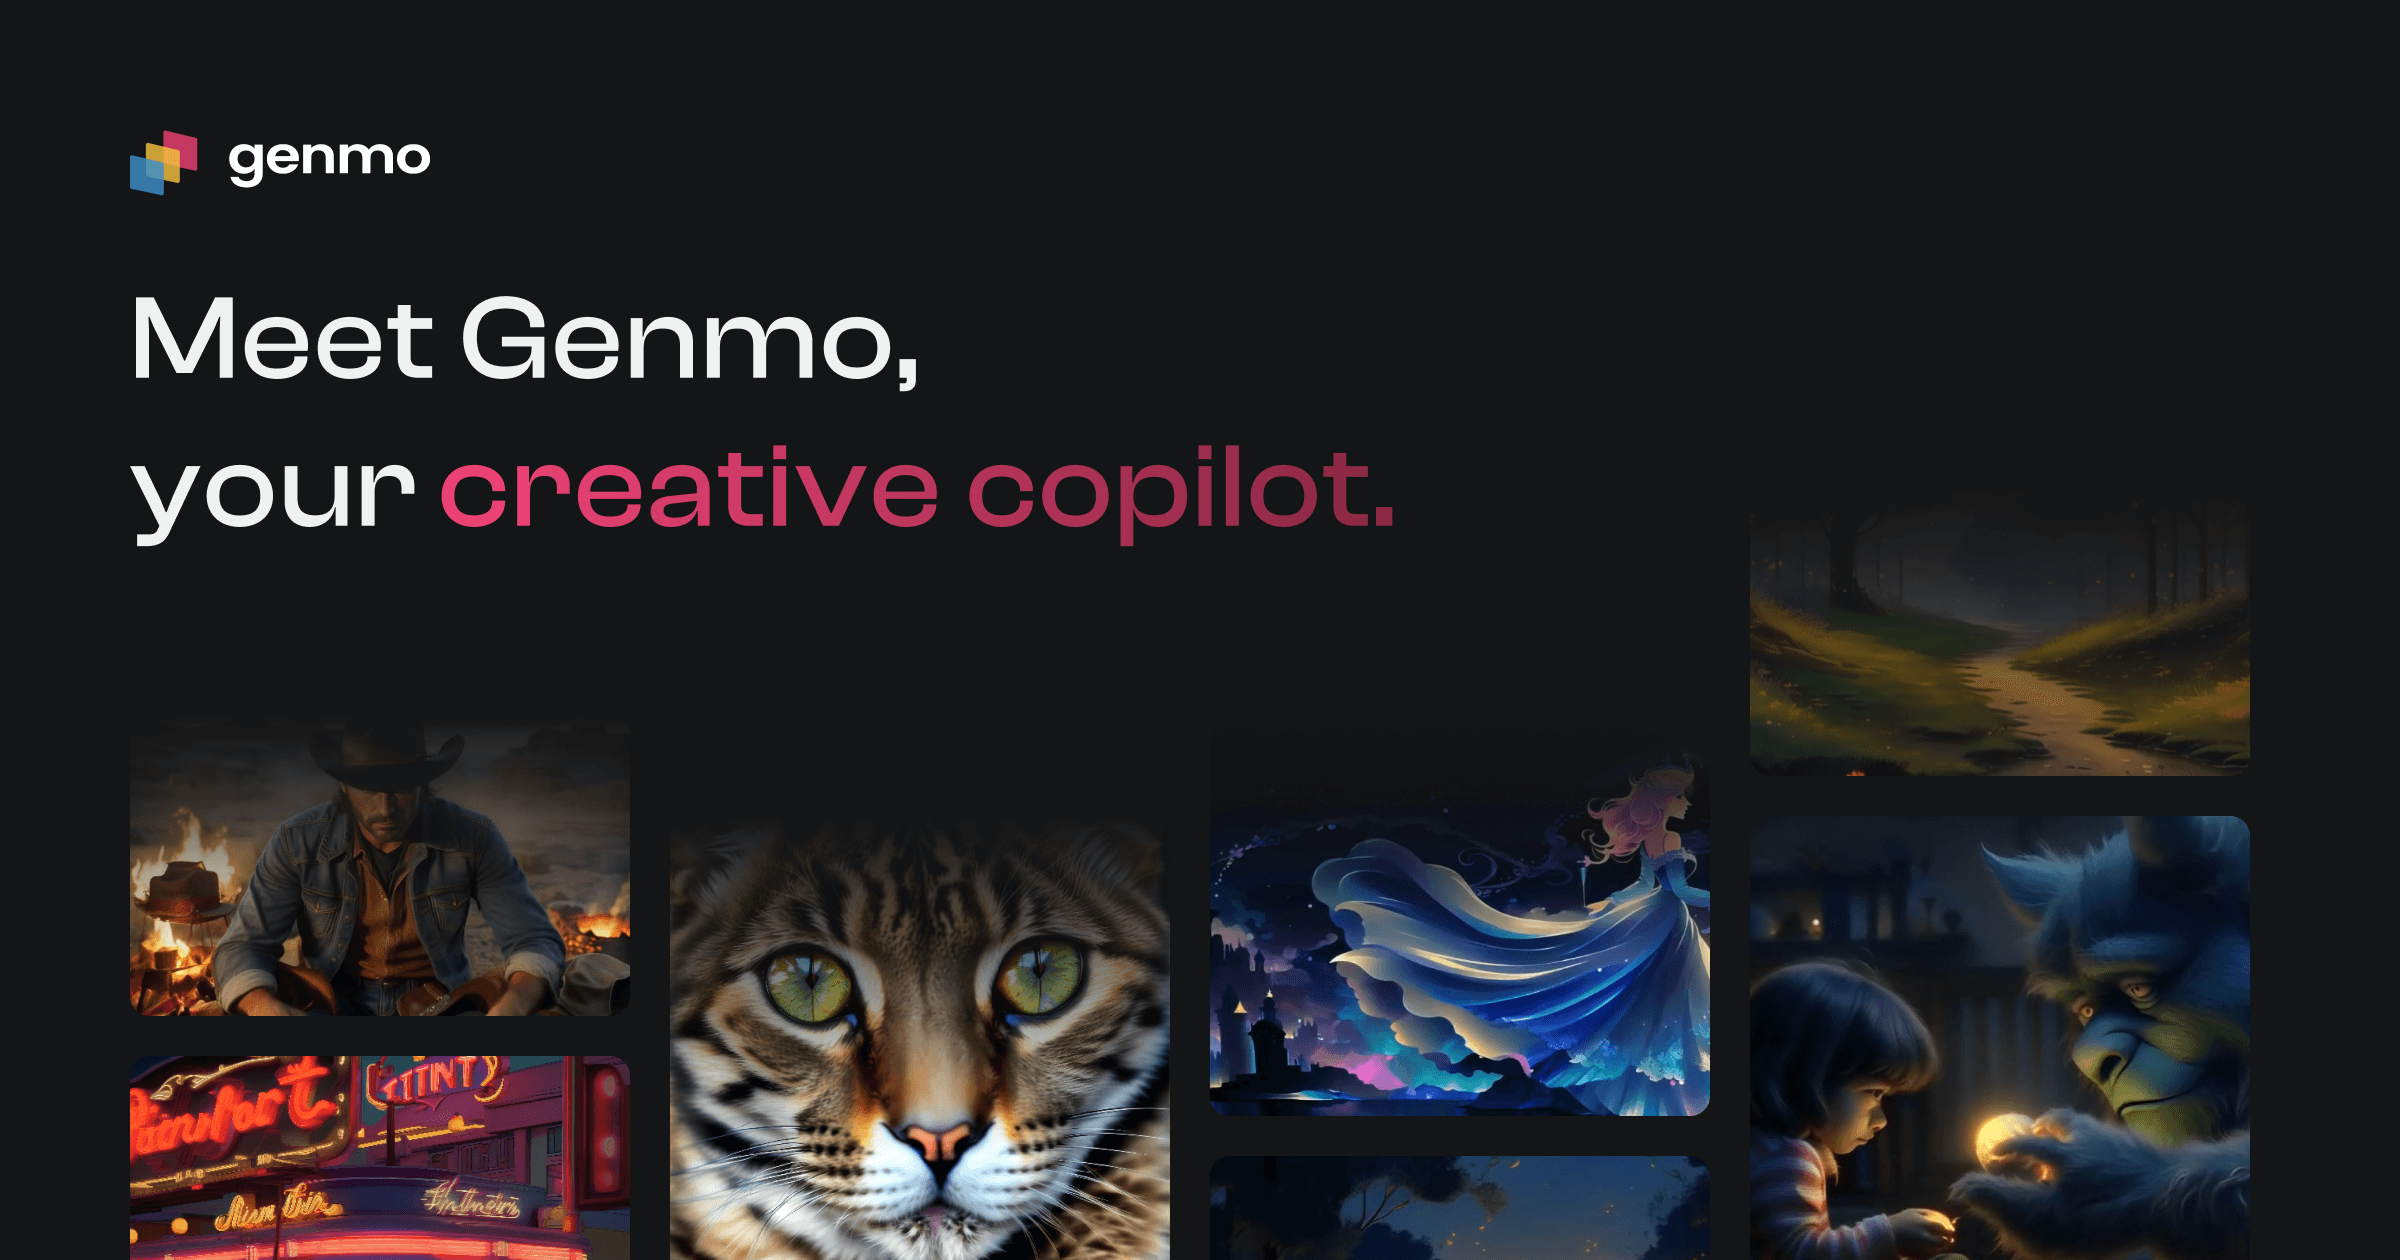
Mochi 1 est le modèle de génération vidéo open source à 10 milliards de paramètres de Genmo, publié sous licence Apache 2.0 en octobre 2024. Il génère des clips en 480p à 30fps avec un excellent respect des prompts. Les poids peuvent être téléchargés gratuitement et exploités commercialement sans redevances.
Mochi 1 est un modèle text-to-video open source conçu par Genmo, une startup d'IA basée à San Francisco et soutenue par une levée de fonds de série A de $28.4 million. Publié le 22 octobre 2024 sous licence Apache 2.0, il offre une capacité de génération vidéo de 10 milliards de paramètres, accessible gratuitement pour un usage personnel et commercial, avec des poids hébergés sur Hugging Face et l'intégralité du code source sur GitHub. Lors de son lancement, Genmo l'a qualifié de « plus grand modèle génératif vidéo jamais publié en open source », une affirmation qui s'est vérifiée pendant environ deux mois : aucun autre modèle ouvert n'égalait sa combinaison d'échelle, de qualité de mouvement et de licence permissive.
Le modèle s'appuie sur une architecture Asymmetric Diffusion Transformer (AsymmDiT) à 48 couches, une fenêtre de contexte visuel de 44,520 tokens et un VAE de 362 millions de paramètres qui compresse la vidéo dans un espace latent 128x plus petit. Les rendus sont en 480p à 30 images par seconde pour une durée maximale de 5.4 secondes, pilotés par un encodeur de texte T5-XXL qui garantit un excellent respect des prompts, qu'il s'agisse de mouvements physiques, de comportements de caméra ou de scènes à éléments multiples. La version Apache 2.0 autorise le fine-tuning, l'adaptation LoRA (ajoutée en novembre 2024) et le déploiement commercial sans dépendance vis-à-vis d'un fournisseur. Genmo propose également un playground web hébergé sur genmo.ai avec un abonnement par crédits à partir de $10 par mois pour les équipes qui ne souhaitent pas gérer leur propre infrastructure GPU.
À quoi ressemblent réellement les rendus de Mochi 1 en avril 2026
Nous avons généré un clip de 5 secondes montrant une goutte d'eau au ralenti frappant la surface d'un étang immobile, en utilisant le playground hébergé genmo.ai en avril 2026. La propagation des ondulations était physiquement plausible sur toute la durée du clip, sans aucun artefact de morphing au bord de l'eau. Le rendu en 480p conservait suffisamment de détails pour une timeline en 1080p avec un upscaling appliqué en post-production, bien qu'une compression visible soit apparue sur la version upscalée lors d'une inspection minutieuse. Le framerate à 30fps semblait fluide pour un contenu source au ralenti, bien que la limite stricte de 5.4 secondes ait coupé la phase de stabilisation naturelle de la séquence d'ondulation.
En avril 2026, le modèle public génère toujours des vidéos en 480p à 30fps pour des clips allant jusqu'à 5.4 secondes. Genmo avait promis une variante Mochi 1 HD ciblant le 720p avant la fin de 2024 ; ce délai n'a pas été respecté, et une issue GitHub de février 2025 demandant des éclaircissements sur la sortie HD est restée sans réponse de la part de l'équipe. La model card officielle indique que le modèle « optimise les styles photoréalistes » et que « des déformations et distorsions mineures peuvent également se produire » dans les cas de mouvements extrêmes. Le modèle a accumulé plus de 100 Spaces sur Hugging Face, 5 adaptateurs, 6 fine-tunes et 4 quantifications de la part de la communauté, reflétant une utilisation active et soutenue malgré ses limites techniques.
« Il y a une courbe d'apprentissage, mais une fois que vous concevez de bons prompts, on a l'impression de réaliser un court-métrage Pixar. » - Évaluateur G2, via Geniusfirms.com, 2025
Les meilleurs cas d'usage et les désastres à éviter
Mochi 1 trouve sa place dans les workflows où la licence Apache 2.0 est importante, où la qualité photoréaliste est la priorité, et où les équipes disposent soit de leur propre infrastructure GPU, soit d'un budget d'hébergement modeste. Les cinéastes indépendants explorant la visualisation de scènes assistée par l'IA, les équipes marketing créant de courtes démos de produits, et les chercheurs en ML qui ont besoin de faire du fine-tuning sur des jeux de données visuelles propriétaires ont tous des raisons légitimes de choisir Mochi 1 plutôt que d'autres alternatives.
La capacité de fine-tuning LoRA ajoutée en novembre 2024 est particulièrement précieuse pour les cas d'usage liés à la cohérence de marque. Une équipe peut entraîner Mochi sur un ensemble de références visuelles approuvées, puis générer des clips vidéo respectant l'image de marque à travers différentes campagnes sans avoir à recréer les prompts de zéro. Les outils propriétaires de Runway, Pika ou Kling ne permettent pas ce workflow. Sur la plateforme hébergée, le forfait Lite à $10/mois, qui couvre environ 12 générations de vidéos par mois, convient aux créateurs solos qui produisent du contenu social photoréaliste sans avoir à configurer une infrastructure GPU locale.
Les désastres : orientez Mochi vers des styles anime, cartoon, cel-shading ou peinture, et les résultats seront médiocres. Le modèle a été entraîné sur des séquences photoréalistes et ne dispose d'aucun mécanisme fiable pour le transfert de style esthétique. Tentez une séquence d'action rapide et des artefacts de morphing apparaîtront sur les contours. Essayez de l'exécuter sur un GPU de 12GB et les versions quantifiées produiront une dégradation notable de la qualité. Utilisez-le pour une itération rapide de concepts à travers de nombreuses variations de prompts, et le temps de génération de 8 à 20 minutes par clip deviendra rapidement un goulot d'étranglement créatif.
Contrôle du mouvement et de la caméra : ce qu'il vaut vraiment
Le contrôle du mouvement est l'une des capacités démontrées les plus fortes de Mochi 1. La fenêtre de contexte visuel de 44,520 tokens de l'AsymmDiT applique une attention 3D complète sur toute la séquence vidéo, ce que Genmo attribue à la cohérence image par image du modèle. Dans la pratique, cela se voit le plus clairement dans les mouvements régis par la physique : la dynamique des fluides, le mouvement des cheveux, la simulation de tissus et les gestes humains lents conservent tous une meilleure cohérence spatiale que les modèles ouverts précédents.
Le contrôle de la caméra s'exprime principalement par le langage du prompt. Décrire les directions de panoramique, les vitesses de zoom, les angles d'inclinaison et les mouvements de travelling dans le prompt textuel produit des résultats qui s'alignent sur ces instructions de manière plus fiable que de nombreux modèles comparables. L'interface hébergée genmo.ai propose également des contrôles d'intensité de mouvement allant de stable (environ 50%) à très dynamique (jusqu'à 99%), offrant aux utilisateurs non techniques une approche par curseur du comportement du mouvement sans avoir recours au prompt engineering. Ce que le modèle ne prend pas en charge nativement, c'est l'image-to-video avec une trajectoire de caméra structurée, ce qui limite son utilisation dans les workflows de composition cinématographique contrôlée.
C'est dans les mouvements extrêmes que le contrôle se dégrade. Les panoramiques rapides de la caméra, les mouvements d'objets véloces et les séquences de mouvements à haute fréquence poussent le modèle vers des artefacts de déformation aux limites des objets. La model card officielle le reconnaît explicitement. Le consensus parmi les utilisateurs de workflows ComfyUI est que maintenir l'intensité du mouvement en dessous de 80% produit des rendus plus propres pour la plupart des types de sujets.
« Le modèle nécessite une longueur de séquence de 44,520 tokens pour la génération vidéo, ce qui consomme de la mémoire, et le VAE est extrêmement gourmand en mémoire. Bonne nouvelle : les prérequis ont été réduits, il est donc désormais possible de le faire tourner sur une seule RTX 4090. » - ved-genmo (membre de l'équipe Genmo), fil de discussion Hugging Face, 1er novembre 2024
Limites d'exportation : résolution, durée, filigranes
Les poids open source produisent des vidéos en 480p (848x480) à 30fps, limitées à 5.4 secondes (162 images). Il n'y a pas de filigrane natif sur les rendus générés localement ; la licence Apache 2.0 permet une exportation sans restriction. Les workflows d'upscaling de la communauté utilisant Real-ESRGAN ou des outils similaires peuvent porter la résolution effective à 1080p, bien qu'un 480p upscalé ne soit pas équivalent à un 720p natif, en particulier sur les détails du visage et les textures fines à courte distance de visionnage.
Sur la plateforme hébergée genmo.ai, la version gratuite applique un filigrane Genmo à tous les rendus. Les forfaits payants (Lite à $10/mois et Standard à $30/mois) suppriment le filigrane et accordent des droits d'utilisation commerciale sur les clips générés via l'hébergement. Il n'y a pas d'option pour exporter plus de 5.4 secondes à partir d'une seule génération ; les séquences plus longues nécessitent d'assembler plusieurs clips en post-production. La plateforme hébergée exporte des fichiers MP4 ; le ratio d'aspect est défini avant le début de la génération avec des options 16:9, 9:16 et 1:1 disponibles pour le formatage sur les réseaux sociaux.
Un workflow réel : animation de produit de marque avec Mochi 1
Un workflow typique d'animation de produit e-commerce utilisant Mochi 1 sur la plateforme hébergée se déroule comme suit. Un créateur télécharge une photo de produit fixe (un flacon de parfum, par exemple), utilise l'outil de pinceau sélectif sur genmo.ai pour marquer la région intérieure liquide comme zone à animer, puis ajoute un prompt textuel décrivant un léger mouvement tourbillonnant avec un éclairage ambiant doux. La génération prend 2 à 5 minutes dans la file d'attente hébergée. Le résultat est un MP4 de 5 secondes en 480p montrant le liquide en mouvement à l'intérieur du flacon tandis que le verre et l'étiquette restent statiques. Le créateur télécharge, applique l'upscaling Real-ESRGAN pour atteindre 1080p, ajoute un fond musical dans un éditeur séparé et publie sur Instagram Reels. Temps total entre le téléchargement et le clip publié : environ 15 à 20 minutes. Coût avec le forfait Lite : environ 83 centimes par génération vidéo (100 crédits à $10/1,200 crédits).
Pour une variante de recherche auto-hébergée, une équipe ML pourrait faire un fine-tuning de Mochi via LoRA sur 500 clips vidéo de marque approuvés, produisant un modèle adapté au domaine qui génère systématiquement des visuels cohérents avec la marque sans avoir à redécrire le style dans les prompts. Ce workflow nécessite une infrastructure GPU (une RTX 3090 ou supérieure pour l'inférence, un cluster GPU haut de gamme pour l'entraînement LoRA) mais ne coûte rien en frais de licence et produit des rendus sur lesquels Genmo n'a aucune visibilité.
Le coût réel par vidéo finalisée
Auto-hébergé : uniquement le calcul. Faire tourner une RTX 4090 à 8-20 minutes par génération sur une plateforme de location cloud à environ 80 centimes de l'heure place le coût à 10-30 centimes par clip. Une équipe possédant sa propre infrastructure GPU ne paie que l'électricité, s'approchant d'un coût marginal nul par vidéo. Les services de GPU cloud comme RunPod et Lambda Labs offrent un accès A100 à environ $1.50-2.50 de l'heure, plaçant une génération Mochi typique entre 20 et 80 centimes selon la complexité du clip.
Hébergé via genmo.ai : chaque génération vidéo Mochi coûte 100 crédits. Les forfaits se répartissent ainsi :
Gratuit (Hébergé) : $0/mois, 50 crédits/mois, filigrane Genmo, usage personnel uniquement. Couvre environ 0 à 1 génération vidéo Mochi par mois une fois le bonus d'inscription initial épuisé.
Lite (Hébergé) : $10/mois, 1,200 crédits/mois (environ 12 générations Mochi), sans filigrane, usage commercial, haute priorité dans la file d'attente. La facturation annuelle réduit le tarif de 20%.
Standard (Hébergé) : $30/mois, 5,000 crédits/mois (environ 50 générations Mochi), sans filigrane, file d'attente la plus rapide, accès anticipé aux modèles. La facturation annuelle réduit le tarif de 20%.
La tarification de l'API Replicate pour Mochi 1 s'élève à environ $0.42 par génération (soit environ 2 exécutions pour $1), ce qui en fait une option viable pour les développeurs qui ont besoin d'une inférence hébergée sans engagement d'abonnement.
Mochi 1 vs. HunyuanVideo vs. LTX-Video
HunyuanVideo (Tencent, décembre 2024) utilise 13 milliards de paramètres contre 10 milliards pour Mochi, construit sur une architecture Mixture-of-Experts avec des modules de guidage textuel inter-trames plutôt que l'AsymmDiT de Mochi. La différence de résolution de sortie est le changement le plus visible : HunyuanVideo génère du 1280x720 nativement contre 848x480 pour Mochi. Sur le benchmark VBench, HunyuanVideo obtient un score de 83.2 contre 77.4 pour Mochi, avec des avantages en termes de qualité cinématographique, de fidélité des visages sur plusieurs personnages et de cohérence des mouvements sur des durées plus longues. Le compromis est la vitesse : HunyuanVideo prend environ 45 minutes pour générer un clip de 5 secondes sur un A100, contre 8 minutes pour Mochi. HunyuanVideo utilise une licence personnalisée avec des conditions commerciales ; Mochi 1 est sous Apache 2.0 sans restrictions. Pour les projets axés sur la qualité où le temps de génération est secondaire, HunyuanVideo est le leader open source actuel. Pour la clarté de la licence ou une itération plus rapide, Mochi 1 est plus pratique.
LTX-Video (Lightricks) fait le compromis inverse. Son modèle de base utilise 2 milliards de paramètres (avec une variante dev 13B également disponible) et utilise une attention factorisée, traitant les dimensions spatiales et temporelles indépendamment plutôt que l'attention 3D complète de Mochi sur 44,520 tokens. Le résultat : LTX-Video génère un clip de 5 secondes en environ 45 secondes sur un A100 contre 8 minutes pour Mochi, et fonctionne sur 8GB de VRAM contre un minimum de 17-18GB pour Mochi. La résolution de sortie atteint 1216x704. Son score VBench est de 71.2, en dessous des 77.4 de Mochi, reflétant le compromis de qualité fait pour atteindre cette vitesse. LTX-Video utilise une licence personnalisée, et non Apache 2.0. Pour une itération rapide de concepts à travers de nombreuses variations de prompts, LTX-Video est le choix par défaut pratique. Pour une qualité photoréaliste soutenue sous une licence commerciale claire, Mochi 1 tire son épingle du jeu.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant Mochi 1.
Articles associés
Guides et articles en lien avec Mochi 1.

AI Video Generator Prompting: The Filmmaker's Real Workflow

Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

AI Fashion Prompts That Stay Consistent: The Working Formula (2026)
