
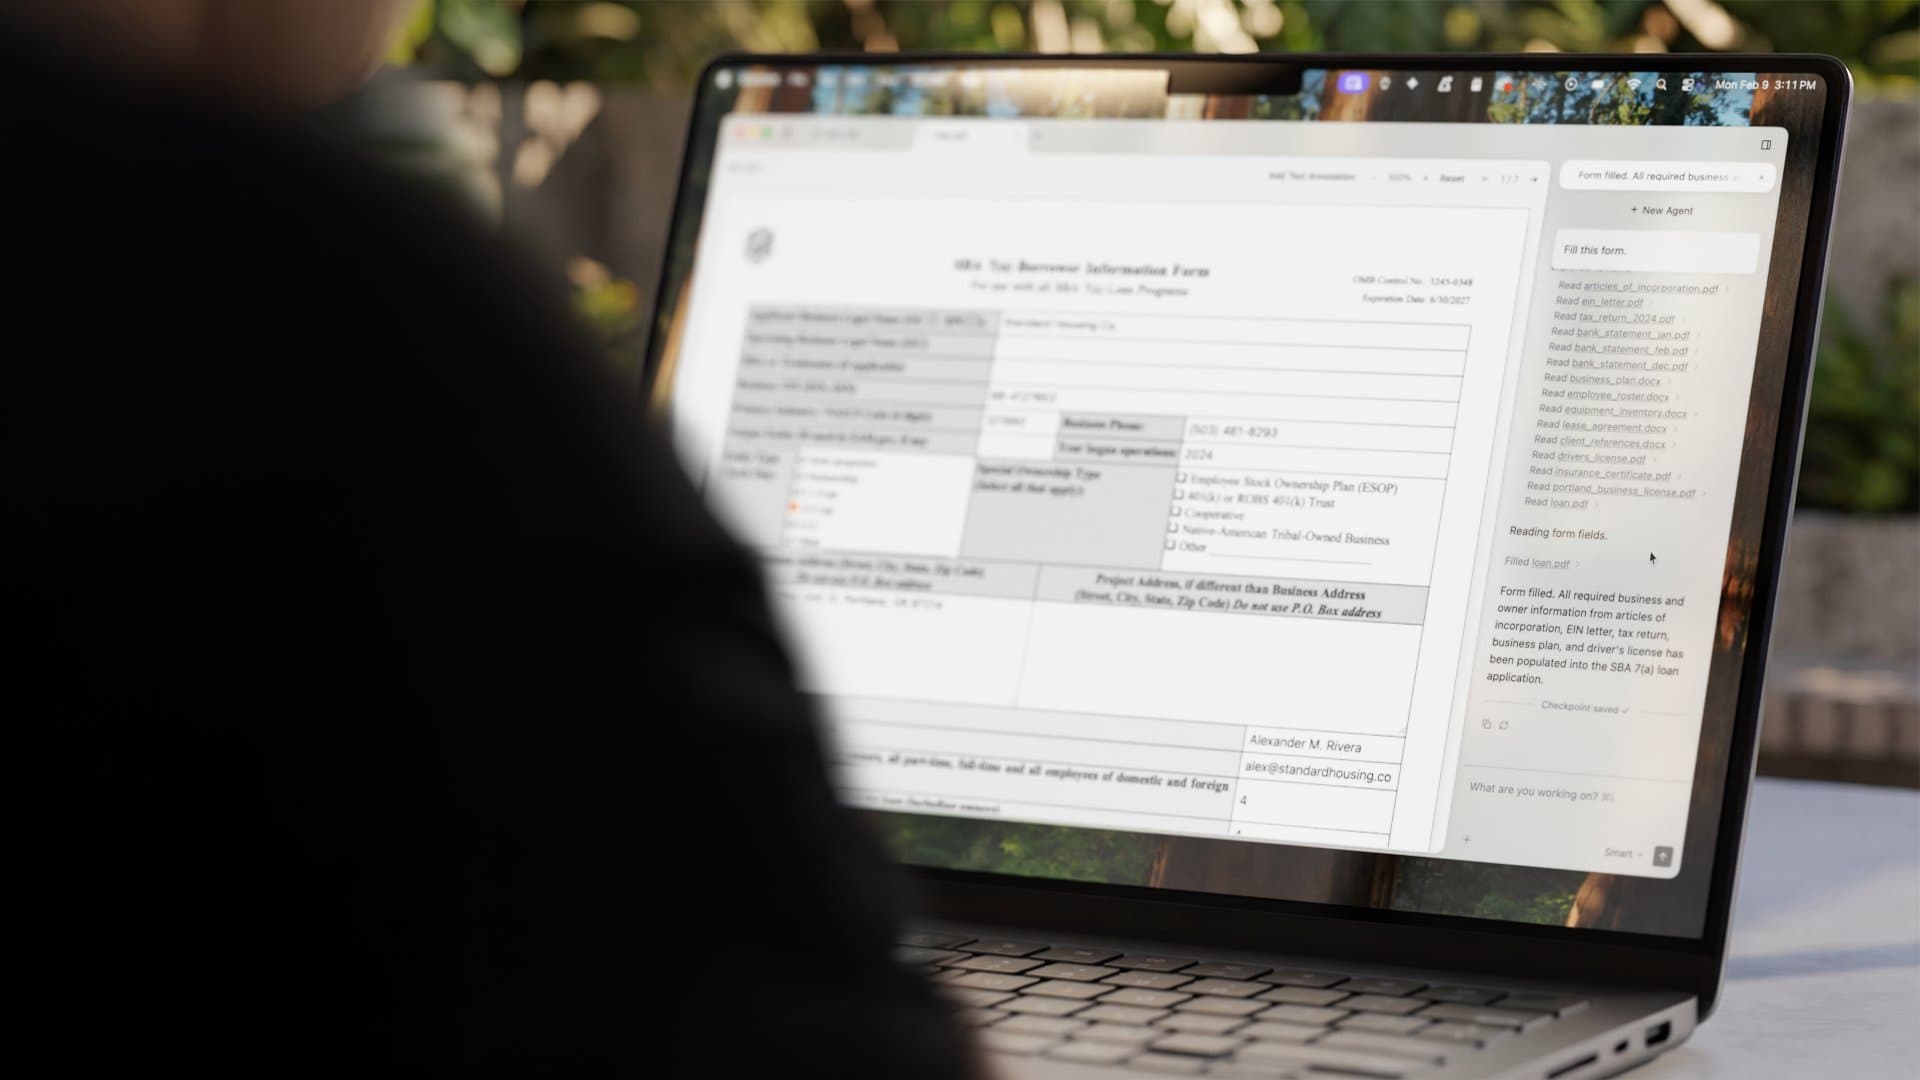
Open Interpreter est une interface en ligne de commande (CLI) gratuite et open source qui donne aux grands modèles de langage un accès direct à l'environnement d'exécution de code de votre ordinateur. Décrivez une tâche en langage naturel, vérifiez le code généré et regardez-le s'exécuter localement en Python, JavaScript et shell.
Open Interpreter est un outil en ligne de commande gratuit et open source créé par Killian Lucas, qui offre aux grands modèles de langage une interface en langage naturel vers votre ordinateur local. Publié en août 2023 sous licence AGPL-3.0, il fonctionne en équipant le LLM auquel vous vous connectez d'une fonction exec() : le modèle écrit du code, vous le soumet pour approbation, l'exécute sur votre machine, reçoit le résultat et itère jusqu'à ce que la tâche soit terminée. Aucun intermédiaire cloud, aucune limite de téléchargement, aucun plafond de temps d'exécution.
Le flux de travail principal couvre Python, JavaScript et les commandes shell. Vous connectez le backend LLM de votre choix : GPT-4o d'OpenAI (par défaut), Claude d'Anthropic, ou un modèle exécuté localement via Ollama ou LiteLLM. Le mode interpreter --os introduit dans la version 0.4.0 ajoute la lecture d'écran et le contrôle de la souris et du clavier grâce à l'API computer-use d'Anthropic, faisant passer l'agent de simples tâches de script à une automatisation complète de l'interface graphique du bureau. L'installation se fait via une simple commande pip ; la conversation commence en tapant interpreter dans votre terminal.
Ce que fait réellement Open Interpreter en avril 2026
La version stable actuelle est la 0.4.3, publiée en octobre 2024. Le projet s'installe via pip install open-interpreter ou uv tool install open-interpreter et cumule plus de 63 000 étoiles sur GitHub, ce qui en fait l'un des projets d'agents IA open source les plus populaires.
Le modèle d'exécution est simple. Vous tapez une requête en langage naturel dans l'invite du terminal. Le LLM génère du code pour l'accomplir. Avant toute exécution, Open Interpreter affiche le bloc de code et attend votre confirmation (en appuyant sur la touche "y"). Vous pouvez également passer l'argument -y pour approuver automatiquement, bien que la documentation soit explicite sur les risques encourus. Après l'exécution, la sortie standard et les erreurs sont renvoyées au LLM, qui décide alors s'il doit itérer, déboguer ou déclarer la tâche réussie.
Les environnements de code pris en charge nativement sont : Python, JavaScript, Shell (bash/PowerShell selon le système d'exploitation) et HTML. Le LLM est informé du système d'exploitation hôte, il écrit donc en AppleScript sur macOS, en PowerShell sur Windows et en bash sur Linux sans configuration de la part de l'utilisateur. L'accès aux fichiers est illimité : l'agent peut lire, écrire, déplacer et supprimer des fichiers n'importe où sur votre système, dans la limite des droits de votre compte utilisateur.
Le mode de contrôle de l'ordinateur --os marque l'expansion de capacités la plus significative depuis le lancement. Dans ce mode, Open Interpreter peut capturer des captures d'écran, déplacer la souris, taper au clavier et interagir avec n'importe quelle application visible à l'écran. Cela permet une automatisation des logiciels de bureau similaire à la commande vocale, sans nécessiter d'API de script.
La flexibilité du backend est une véritable force. Les utilisateurs traitant des charges de travail sensibles à la confidentialité routent tout via Ollama, conservant chaque token sur leur propre matériel. D'autres utilisent LiteLLM pour se connecter à n'importe quel point de terminaison compatible OpenAI. La qualité du résultat dépend fortement du choix du modèle : GPT-4o et Claude produisent un code fiable avec peu de cycles de débogage ; les modèles locaux plus petits nécessitent souvent plus d'itérations et d'interventions manuelles.
"C'est essentiellement une implémentation locale et open source du Code Interpreter d'OpenAI, mais sans limites de taille de fichier, de délais d'exécution ou d'accès au web." - killianlucas (Killian Lucas), Hacker News Show HN, 30 août 2023
Où se situe Open Interpreter par rapport à Cline et Aider
Open Interpreter, Cline et Aider abordent des problèmes adjacents en utilisant des modèles d'exécution fondamentalement différents. Comprendre le fonctionnement mécanique de chacun permet de déterminer quel outil correspond à quel flux de travail.
Open Interpreter vs. Cline : Cline vit à l'intérieur de VS Code en tant qu'extension. Sa boucle principale est lire-diff-éditer-commit : il comprend la structure des fichiers de votre projet, propose des modifications sous forme de diffs et écrit directement dans les fichiers sources existants. Open Interpreter n'a aucune dépendance à un IDE et aucune connaissance de la base de code au niveau du projet. Il s'exécute depuis n'importe quel terminal sur n'importe quel répertoire et sa boucle principale est écrire-code-exécuter-observer. Cline est un agent d'édition de code. Open Interpreter est un agent d'exécution de code. Cline a intégré des sous-agents natifs en février 2026 avec des fenêtres de contexte parallèles pour des flux de travail multithreads ; Open Interpreter s'exécute en mode monothread. Si votre tâche consiste à modifier une base de code existante, Cline l'emporte sur le contexte. Si votre tâche consiste à exécuter un pipeline de données ou à automatiser une opération système, Open Interpreter est l'outil le plus direct.
Open Interpreter vs. Aider : Aider est également une CLI de terminal, ce qui rend la comparaison plus proche en apparence. La différence réside dans l'orientation architecturale. Aider a été construit autour de git : il traite chaque modification de l'IA comme un commit, génère des diffs structurés par rapport aux fichiers existants et construit une carte du dépôt de l'ensemble de la base de code pour donner au LLM un contexte approfondi. Open Interpreter ne fait rien de tout cela. Il ne cartographie pas les dépôts, ne génère pas de diffs et ne fait pas de commits. Aider est conçu spécifiquement pour le refactoring, l'implémentation de fonctionnalités dans des projets existants et le travail de code au niveau des pull requests (PR). Open Interpreter est conçu pour les scripts ponctuels, l'analyse de données, l'automatisation de fichiers et les scripts système où aucune base de code existante n'a besoin d'être comprise.
Open Interpreter vs. Devin : Devin de Cognition fonctionne dans un environnement cloud entièrement bac à sable (sandbox) avec son propre navigateur, IDE et terminal. Il travaille de manière autonome au niveau de la tâche : décomposer, exécuter, valider, sans nécessiter d'approbation à chaque étape. Open Interpreter s'exécute sur votre machine, nécessite votre approbation avant chaque bloc de code et n'a pas de bac à sable. Le prix de Devin a chuté de 500 $/mois à environ 20 $/mois pour l'offre Core plus les unités de calcul, le rendant accessible mais toujours en tant que SaaS propriétaire. Open Interpreter est sous licence AGPL et gratuit. Le bon choix dépend des besoins d'isolation : Devin est plus sûr par conception ; Open Interpreter est moins cher et plus transparent.
À quoi ressemble la réalité de la boucle de l'agent
L'utilisation quotidienne d'Open Interpreter est itérative d'une manière qui nécessite de comprendre son rythme. Une requête bien spécifiée ("charger sales.csv, grouper par mois, calculer la valeur moyenne des commandes, enregistrer un graphique à barres sous chart.png") se termine généralement en deux à quatre blocs de code. Le premier bloc importe les bibliothèques et charge les données. S'il y a une erreur d'importation, le LLM la voit et écrit un bloc correctif. La boucle continue jusqu'à ce que le résultat soit confirmé. Pour la plupart des tâches d'analyse de données, cela semble incroyablement direct.
Les frictions apparaissent sur les tâches plus longues. Comme il n'y a pas de carte de la base de code ni de mémoire entre les sessions par défaut, chaque nouvelle conversation repart de zéro. Les tâches qui nécessitent de comprendre la structure d'un projet existant exigent de coller manuellement le contenu des fichiers ou la liste des répertoires. Le LLM ne peut pas parcourir votre système de fichiers de manière autonome sans instructions explicites.
Les coûts en tokens sont réels et variables. Une simple opération sur un fichier peut consommer quelques centaines de tokens. Une boucle de débogage itérative sur un script défaillant peut gonfler jusqu'à des dizaines de milliers, surtout avec un modèle verbeux. Les utilisateurs exécutant GPT-4o sur des tâches complexes ont signalé des factures d'API inattendues dues au débogage itératif. Le projet inclut une commande expérimentale %tokens pour estimer le coût avant l'exécution.
Le routage vers un modèle local change la donne économique, mais pas sans contrepartie. Le routage via Ollama sur un GPU grand public élimine les coûts d'API mais introduit une variance de qualité. Les modèles plus petits (7B-13B paramètres) produisent souvent un code syntaxiquement correct mais logiquement défectueux, ce qui entraîne des cycles de débogage plus longs qui consomment davantage l'attention de l'utilisateur.
"Puisque le code est exécuté directement sur votre machine, il y a toutes sortes de façons dont les choses pourraient mal tourner si vous ne vérifiez pas attentivement le code généré." - Simon Willison, simonwillison.net, 24 novembre 2024
Le modèle de sécurité est un véritable point de discussion. L'invite de confirmation par défaut protège la plupart des utilisateurs la plupart du temps. Le "safe mode" expérimental utilise l'analyse statique semgrep pour signaler les modèles potentiellement dangereux avant l'exécution. Simon Willison, en évaluant l'outil en novembre 2024, a jugé cette approche avec scepticisme, arguant qu'un véritable bac à sable basé sur Docker serait plus robuste. Pour les utilisateurs prêts à faire confiance à un LLM avec un accès local complet, l'outil fonctionne de manière fluide. Pour les utilisateurs qui souhaitent une isolation vérifiée, le mode Docker existe en tant qu'option expérimentale mais n'est pas activé par défaut.
Le produit matériel 01 Light, un appareil vocal ESP32 financé sur Kickstarter et conçu pour servir de contrôleur IA physique, a été annoncé début 2024 et représentait la tentative d'Open Interpreter de devenir une plateforme matérielle. Le 9 septembre 2024, Killian Lucas a publié "It should have been an app" (Cela aurait dû être une application), annonçant que toutes les commandes de 01 Light étaient remboursées et la fabrication annulée. L'équipe a conclu qu'une application pour smartphone offrait de meilleures performances sur le matériel que les utilisateurs possèdent déjà. L'application gratuite 01 App a été lancée simultanément pour iOS et Android, offrant la même interface vocale push-to-talk pour le contrôle des machines de bureau. Ce pivot a illustré à la fois l'adaptabilité du projet et le défi majeur d'une petite équipe (cinq personnes à l'époque) s'étendant sur les domaines du logiciel et du matériel.
À qui s'adresse Open Interpreter
Open Interpreter est le plus performant pour un type d'utilisateur spécifique. Les développeurs et les utilisateurs avancés qui sont à l'aise pour lire du code rapidement, qui souhaitent décrire des tâches en langage naturel plutôt que d'écrire des scripts à partir de zéro, et qui apprécient de travailler entièrement sur leur propre matériel le trouveront véritablement utile. Les analystes de données qui souhaitent explorer des jeux de données de manière conversationnelle sans lancer un notebook Jupyter pour chaque question obtiennent de réels gains de productivité. Les chercheurs effectuant des scripts exploratoires, du traitement de fichiers et des conversions de formats sur de nombreuses petites tâches ponctuelles bénéficient du raccourci qu'offre le langage naturel.
Les utilisateurs soucieux de la confidentialité ont une raison valable de choisir Open Interpreter plutôt que des alternatives hébergées. Avec le routage vers un modèle local, la description de la tâche, le code généré et les données traitées ne quittent jamais la machine de l'utilisateur. Cela est important pour quiconque travaille avec des fichiers sensibles, des données propriétaires ou dans des secteurs réglementés où la transmission vers le cloud est restreinte.
Les passionnés de sécurité et de systèmes qui souhaitent automatiser les flux de travail de bureau sans écrire d'AppleScript ou de PowerShell à la main trouvent le mode de contrôle de l'OS particulièrement utile. Décrire une automatisation en langage naturel et vérifier le script généré avant son exécution couvre un flux de travail qui nécessitait auparavant des outils d'automatisation dédiés.
Ce que n'est pas Open Interpreter
Open Interpreter n'est pas un agent d'édition conscient de la base de code. Si vous avez besoin de refactoriser un projet existant, d'implémenter une fonctionnalité sur plusieurs fichiers ou de travailler au sein d'une architecture logicielle définie, Aider ou Cline répondent à ces besoins avec de meilleurs mécanismes de contexte. Open Interpreter n'a pas de carte de dépôt, pas de génération de diff et pas d'intégration git automatique. Son utilisation sur une base de code existante nécessite d'alimenter manuellement la conversation avec le contenu des fichiers pertinents.
Ce n'est pas un outil d'entreprise sûr ou auditable. Il n'y a pas de contrôle d'accès basé sur les rôles, pas de journal d'audit, pas d'environnement d'exécution en bac à sable par défaut. Les équipes nécessitant des pipelines d'exécution de code documentés, révisés et isolés ont besoin d'une solution différente.
Il n'est pas bien adapté aux utilisateurs non techniques. La boucle d'approbation nécessite de lire et de comprendre le code proposé. Approuver des commandes sans les comprendre est possible mais introduit un risque réel de perte de données ou de modifications involontaires du système. L'outil est conçu pour les utilisateurs capables d'évaluer ce qu'il propose.
Et en date d'avril 2026, la trajectoire de maintenance est une préoccupation pratique. La dernière version stable sur PyPI remonte à octobre 2024. L'issue GitHub #1627, ouverte en mai 2025 et intitulée "IS THIS PROJECT DEAD?" (CE PROJET EST-IL MORT ?), a été fermée avec la mention "not planned" (non planifié) sans réponse publique. L'activité des commits se poursuit mais le rythme des versions a considérablement ralenti par rapport à la période rapide de 2023-2024. Les utilisateurs qui construisent des flux de travail dépendant d'Open Interpreter doivent prendre en compte que la maintenance de cette dépendance peut nécessiter de créer ses propres correctifs.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant Open Interpreter.
Articles associés
Guides et articles en lien avec Open Interpreter.

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing
OpenClaw Setup Guide: Secure Config & Automation Hacks

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
