
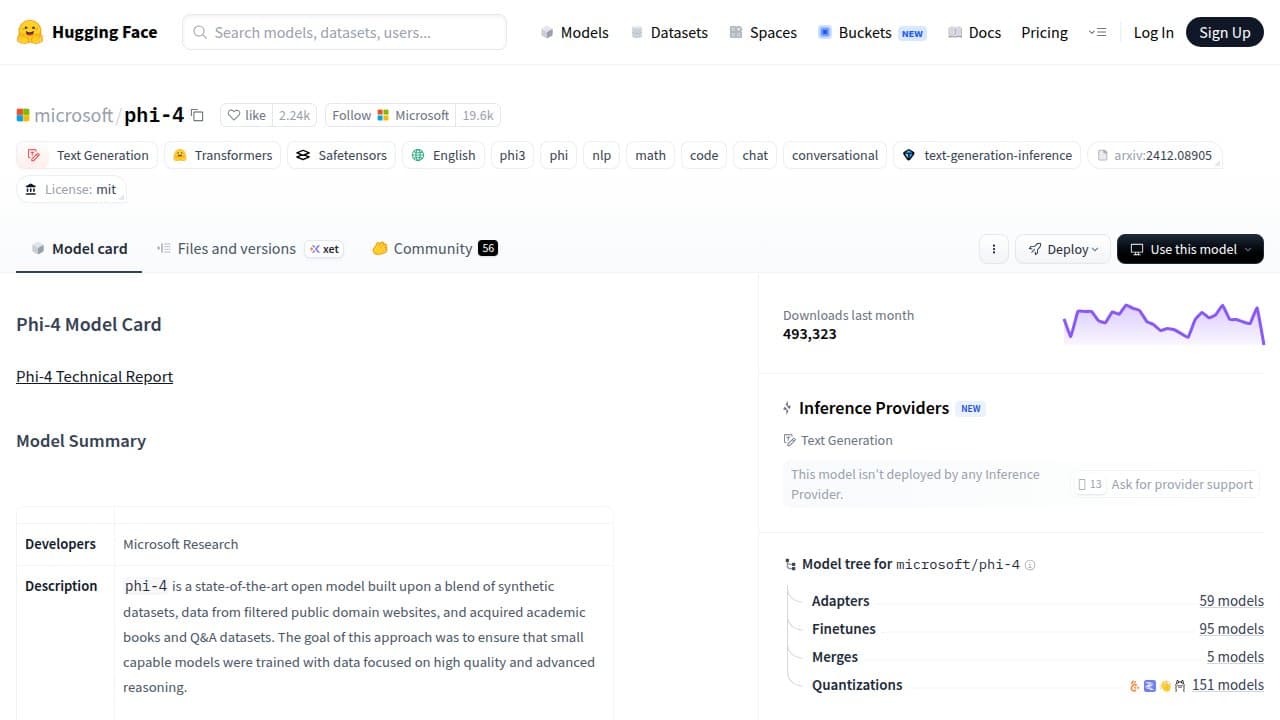
La famille Phi de Microsoft prouve que la qualité des données prime sur la taille. La génération Phi-4 (14B, licence MIT) surpasse les attentes en mathématiques et en raisonnement, et fonctionne sur du matériel grand public. Téléchargement gratuit, avec inférence hébergée payante sur Azure AI Foundry.
La famille Phi de Microsoft est une série de petits modèles de langage reposant sur un pari fondamental : des données d'entraînement synthétiques soigneusement sélectionnées peuvent produire un modèle surpassant des concurrents dotés de beaucoup plus de paramètres. Développé par Microsoft Research et publié sous licence MIT, Phi a évolué depuis le modèle Phi-1 (1,3B) en 2023 jusqu'à la génération Phi-4 qui, début 2026, comprend une variante mini de 3,8B, un modèle multimodal de 5,6B, un modèle phare de 14B et un modèle de raisonnement-vision de 15B sorti en mars 2026. Tous les poids sont disponibles gratuitement sur Hugging Face sous l'organisation microsoft, et tous bénéficient de la licence MIT, ce qui signifie que l'utilisation commerciale, le fine-tuning et la redistribution sont sans restriction. Le chercheur principal à l'origine des premiers paris sur Phi, Sebastien Bubeck (ancien vice-président de la recherche en IA générative chez Microsoft), est parti chez OpenAI en octobre 2024, passant le relais à une équipe qui a continué à faire progresser la famille.
La gamme actuelle offre aux développeurs des choix pertinents adaptés à différents budgets matériels. Phi-4 (14B) gère les mathématiques, le raisonnement et le code sur un GPU grand public avec 8GB de VRAM lorsqu'il est quantifié en 4 bits. Phi-4-mini (3,8B) prend en charge une fenêtre de contexte de 128K et l'appel de fonctions (function calling), ce qui en fait une option de déploiement edge tout à fait légitime. Phi-4-multimodal (5,6B) traite le texte, l'audio et les images, et a dominé le classement HuggingFace OpenASR avec un taux d'erreur de mots de 6,14% en février 2025. Phi-4-reasoning et Phi-4-reasoning-plus (tous deux de 14B) utilisent un fine-tuning supervisé sur des traces de raisonnement générées par o3-mini, la variante plus ajoutant un apprentissage par renforcement basé sur les résultats pour des chaînes plus longues et plus précises. Le tout dernier membre, Phi-4-reasoning-vision-15B (sorti le 4 mars 2026), étend le raisonnement multimodal à la compréhension des interfaces utilisateur et aux problèmes scientifiques. Tous sont déployables via Ollama, Hugging Face Transformers, Azure AI Foundry, GitHub Models et des environnements d'exécution compatibles avec llama.cpp.
Phi en un coup d'œil, avril 2026
La génération Phi-4 couvre quatre cibles de déploiement principales :
Phi-4 (14B) : Transformer dense de type décodeur uniquement. Licence MIT. Contexte de 16K. MMLU 84.8, GPQA 56.1, MATH 80.4, HumanEval 82.6. Entraîné sur 9,8 billions de tokens incluant des données fortement synthétiques en mathématiques, code et raisonnement. Lancé le 12 décembre 2024 en tant qu'aperçu de recherche sur Azure AI Foundry ; poids ouverts sous licence MIT en janvier 2025.
Phi-4-mini (3,8B) : Grouped-query attention, vocabulaire de 200K, contexte de 128K, appel de fonctions. Sorti le 26 février 2025. Le choix principal pour les déploiements edge et IoT.
Phi-4-multimodal (5,6B) : Entrée texte, audio et image ; sortie texte. Leader ASR (6,14% WER). Sorti le 26 février 2025.
Phi-4-reasoning / Phi-4-reasoning-plus (14B) : Modèles de chaîne de raisonnement entraînés sur des démonstrations de o3-mini. Sortis en avril/mai 2025. Surpassent DeepSeek-R1-Distill-Llama-70B sur plusieurs benchmarks de raisonnement.
Phi-4-reasoning-vision-15B : Modèle de raisonnement multimodal de 15B. Licence MIT. Sorti le 4 mars 2026. Gère les mathématiques, les sciences et la compréhension des interfaces utilisateur avec des entrées visuelles.
L'entraînement de Phi-4 a duré 21 jours sur 1 920 GPU H100-80G. Environ 8% des données d'entraînement sont multilingues ; le reste est principalement en anglais. La date limite des données (cutoff) est juin 2024 pour le modèle de base Phi-4 ; août 2024 pour certaines variantes ultérieures.
Les véritables points forts de Phi
La thèse des données synthétiques porte ses fruits de manière très visible sur les tâches structurées. Phi-4 (14B) obtient un score de 80.4 sur le benchmark MATH et de 82.6 sur HumanEval, des chiffres qui battent des modèles deux à cinq fois plus grands. Pour les développeurs exécutant des modèles quantifiés sur du matériel grand public, c'est l'attrait principal : un modèle qui tient dans 8GB de VRAM et gère de manière crédible de vrais problèmes de code et de mathématiques.
"J'ai eu beaucoup de succès avec Phi-4 12B quantifié et Ollama jusqu'à présent. C'est aussi rapide que Llama 3.1 8B mais les résultats ont été (subjectivement) de meilleure qualité." - accrual, Hacker News, décembre 2024
La licence MIT est un véritable élément différenciateur. Là où Gemma utilise la licence Gemma de Google (avec des exigences de reporting à grande échelle) et Llama utilise la licence Llama de Meta (utilisation commerciale autorisée mais avec des conditions pour les déploiements à fort trafic), la licence MIT de Phi-4 est la plus claire des trois pour les équipes intégrant des modèles dans des produits commerciaux sans lourdeur de révision juridique.
Phi-4-mini est sans doute le modèle le plus sous-estimé de la famille. Avec 3,8B de paramètres, une fenêtre de contexte de 128K et un appel de fonctions fiable, il correspond au cas d'usage des agents edge que le modèle de base Phi-4 ne peut pas servir (le contexte de 16K est une limite stricte pour les tâches riches en documents). Microsoft a publié un tutoriel spécifiquement sur la création d'agents IA sur des appareils IoT avec Phi-4-mini via Ollama, et l'accueil de la communauté a été positif pour ce modèle de déploiement spécifique.
"Ils ont l'air assez incroyables.. Les sorties de Phi-4 le distinguent comme la seule concurrence en dessous de ~7B." - refulgentis, Hacker News, mai 2025 (à propos des modèles Phi-4-reasoning)
Les limites de Phi, les échecs récurrents rencontrés par les utilisateurs
L'écart entre les scores des benchmarks et le suivi des instructions dans le monde réel est le problème le plus persistant de Phi. Il précède Phi-4 et n'a pas été entièrement résolu. Lors d'un test documenté de janvier 2025, un développeur a fait jouer Phi-4 à 30 parties d'échecs où le modèle devait suivre un prompt contraint. Phi-4 a obtenu zéro victoire et zéro match nul, a enfreint les règles du prompt après une moyenne de 7,7 coups, a généré près de six fois plus de tokens que Gemma 2 9B et a fait dix fois plus d'erreurs. Le développeur a conclu : "Mon impression générale sur les petits modèles qui brillent dans les évaluations n'est pas très bonne lorsqu'ils sont utilisés dans la vie réelle." Ce schéma de verbosité s'étend également aux modèles de raisonnement. Simon Willison a testé Phi-4-reasoning en mai 2025 et a noté qu'il générait 56 phrases de raisonnement en réponse à un simple "salut", un comportement qu'il a décrit comme "une tendance à trop réfléchir".
Le plafond de contexte de 16K sur le modèle de base Phi-4 est une plainte récurrente. Un fil de discussion sur Hugging Face intitulé "Limited Context Length - Yarn/Rope?" illustre cette frustration : au moment où Phi-4 est sorti avec 16K, Llama 3.2 et Gemma 3 offraient tous deux 128K. Phi-4-mini a par la suite corrigé cela avec 128K, but le contexte du modèle phare reste limité par rapport à la concurrence. Pour toute tâche impliquant de longs documents, des bases de code ou un contexte à tours multiples, il s'agit d'une contrainte stricte.
L'utilisation multilingue est un autre point faible. Avec environ 8% de données d'entraînement multilingues, Phi-4 sous-performe sur les prompts non anglophones. Les utilisateurs ayant besoin de chinois, d'arabe ou d'autres langues signalent la nécessité d'un fine-tuning ou de passer à Gemma 3, qui couvre nativement 140 langues.
Enfin, le scepticisme face aux benchmarks suit la famille Phi depuis Phi-3. Plusieurs membres de la communauté ont suggéré que les modèles montrent des signes de contamination des données de benchmark. Microsoft a abordé ce point directement dans le rapport technique de Phi-4, décrivant des procédures de décontamination des données améliorées, mais cette perception persiste chez certains évaluateurs. Un commentateur sur HN a noté clairement en décembre 2024 : "les modèles Phi ont toujours d'excellents scores de benchmark, mais ils me déçoivent toujours dans les cas d'usage réels."
Phi vs. Llama 3.2 vs. Gemma 3
Phi-4 (14B, MIT) est un Transformer dense de type décodeur uniquement, entraîné principalement sur des données synthétiques en anglais. Son principal avantage est la performance en mathématiques et en raisonnement par paramètre. Ses principales limites sont le contexte de 16K sur le modèle de base et un entraînement multilingue minimal.
Llama 3.2 (Meta, licence Llama) est disponible en variantes texte uniquement de 1B et 3B, et multimodales de 11B et 90B. La principale différence mécanique est le contexte : Llama 3.2 prend en charge 128K tokens contre 16K pour Phi-4. Llama 3.2 utilise la grouped-query attention (GQA) qui réduit la mémoire cache KV à 1/8 des architectures traditionnelles. L'écosystème en aval est inégalé : llama.cpp, vLLM, Ollama, TGI et tous les principaux environnements d'exécution d'inférence prennent en charge Llama nativement. Sur MMLU, Llama 3.2 3B se situe autour de 61,8% contre 84,8% pour Phi-4 à 14B, mais Llama 3.3 70B dépasse Phi-4 sur les tâches générales lorsque le budget de paramètres n'est pas une contrainte.
Gemma 3 (Google DeepMind, licence Gemma) est distillé à partir de l'architecture Gemini de Google et utilise une conception "fine et profonde" par rapport à l'approche "large et superficielle" de Llama. Gemma 3 est disponible en variantes de 1B, 4B, 12B et 27B, toutes avec un contexte de 128K. Les variantes 4B+ incluent une entrée d'image native, ce qui manque totalement à Phi-4-mini (seul le modèle distinct Phi-4-multimodal gère la vision). Gemma 3 couvre 140 langues contre le corpus principalement anglophone de Phi-4. La licence n'est pas MIT : les conditions de Gemma exigent des rapports pour les déploiements dépassant 700M de MAU et incluent des conditions supplémentaires absentes de la licence MIT. Pour la plupart des équipes, ce n'est pas un problème, mais pour la simplicité juridique à grande échelle, la licence MIT de Phi-4 l'emporte.
En résumé : si la longueur du contexte est importante (RAG de documents, longues conversations), choisissez Llama 3.2 ou Gemma 3. Si le multilinguisme est important, choisissez Gemma 3. Si la pureté de la licence MIT est primordiale et que l'objectif est d'obtenir des performances en mathématiques/raisonnement sur une petite empreinte, Phi-4 est la meilleure option.
Le niveau payant en vaut-il la peine ?
Il n'y a pas d'abonnement payant pour Phi. Les modèles sont gratuits à télécharger et à exécuter. L'inférence hébergée sur Azure AI Foundry est facturée au token sans engagement minimum :
Phi-4-mini (hébergé) : $0.000075/1K tokens d'entrée, $0.0003/1K tokens de sortie. L'option la plus abordable de la famille.
Phi-4 (hébergé) : $0.000125/1K tokens d'entrée, $0.0005/1K tokens de sortie.
Phi-4-multimodal (texte/image) : $0.00008/1K en entrée, $0.00032/1K en sortie.
Phi-4-multimodal (audio) : $0.004/1K en entrée, $0.00032/1K en sortie.
Fine-tuning : $0.003/1K tokens d'entraînement. Hébergement des modèles fine-tunés : $0.80/h.
Pour les équipes qui s'auto-hébergent, le coût est nul au-delà de l'infrastructure. Un Phi-4 (14B) quantifié en 4 bits fonctionne sur un seul GPU grand public avec 8GB de VRAM. Pour les équipes qui souhaitent une inférence gérée sans gérer la capacité GPU, les tarifs par token d'Azure sont parmi les plus bas du marché pour les modèles de cette classe de capacité. La décision est simple : auto-hébergez gratuitement si vous avez le matériel et la capacité d'ingénierie ; utilisez Azure pour une simplicité gérée à un coût très faible.
Meilleurs cas d'usage (et quand l'éviter)
Phi est bien adapté pour :
Déploiements d'agents edge et IoT : Phi-4-mini à 3,8B avec un contexte de 128K et l'appel de fonctions est conçu pour cela. Microsoft a publié un tutoriel dédié pour les agents edge basés sur Ollama.
Mathématiques et raisonnement structuré : Le benchmark MATH de 80.4 à 14B est le chiffre phare. Pour les systèmes de tutorat, les assistants de codage avec raisonnement mathématique et les Q&R scientifiques en anglais, Phi-4 est la meilleure option de petit modèle.
Déploiements axés sur la confidentialité ou isolés (air-gapped) : Licence MIT, aucune exigence de télémétrie, fonctionne entièrement en local. Les équipes des secteurs réglementés (santé, finance) qui ne peuvent pas envoyer de données aux API cloud disposent ici d'une solution viable.
Recherche et fine-tuning : La méthodologie d'entraînement transparente (documentée dans les rapports techniques de Microsoft Research) et la licence MIT font de Phi un point de départ naturel pour les projets de fine-tuning académiques et commerciaux.
Évitez Phi lorsque :
Vous devez traiter de longs documents, des bases de code ou des conversations à tours multiples dépassant 16K tokens sur le modèle de base (utilisez Gemma 3 ou Llama 3.2 avec un contexte de 128K).
Vos utilisateurs ou votre contenu sont principalement non anglophones (la couverture de 140 langues de Gemma 3 est beaucoup plus large).
Vous construisez un pipeline d'agents en production où le suivi strict et concis des instructions est essentiel. La verbosité et les échecs occasionnels de respect des instructions documentés par les testeurs de la communauté constituent un risque réel dans les boucles d'agents complexes.
Vous souhaitez le support de moteur d'inférence le plus large et la plus grande communauté de dérivés fine-tunés (Llama l'emporte ici avec une large avance).
Premiers pas avec Phi
La voie la plus rapide est Ollama : ollama pull phi4 pour le modèle de base de 14B, ou ollama pull phi4-mini pour la variante de 3,8B, tous deux disponibles sans compte. Pour Hugging Face, les dépôts microsoft/phi-4 et microsoft/Phi-4-mini-instruct incluent des fiches de modèles et des exemples de pipelines transformers. Les modèles utilisent des tokens au format ChatML. Pour Azure AI Foundry, trouvez n'importe quelle variante de Phi-4 dans le catalogue de modèles et déployez-la via une inférence gérée facturée au token sans aucun provisionnement de GPU requis.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant Phi.
Articles associés
Guides et articles en lien avec Phi.

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Run Open Source AI Models Locally: Battle-Tested Guide

Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI
