
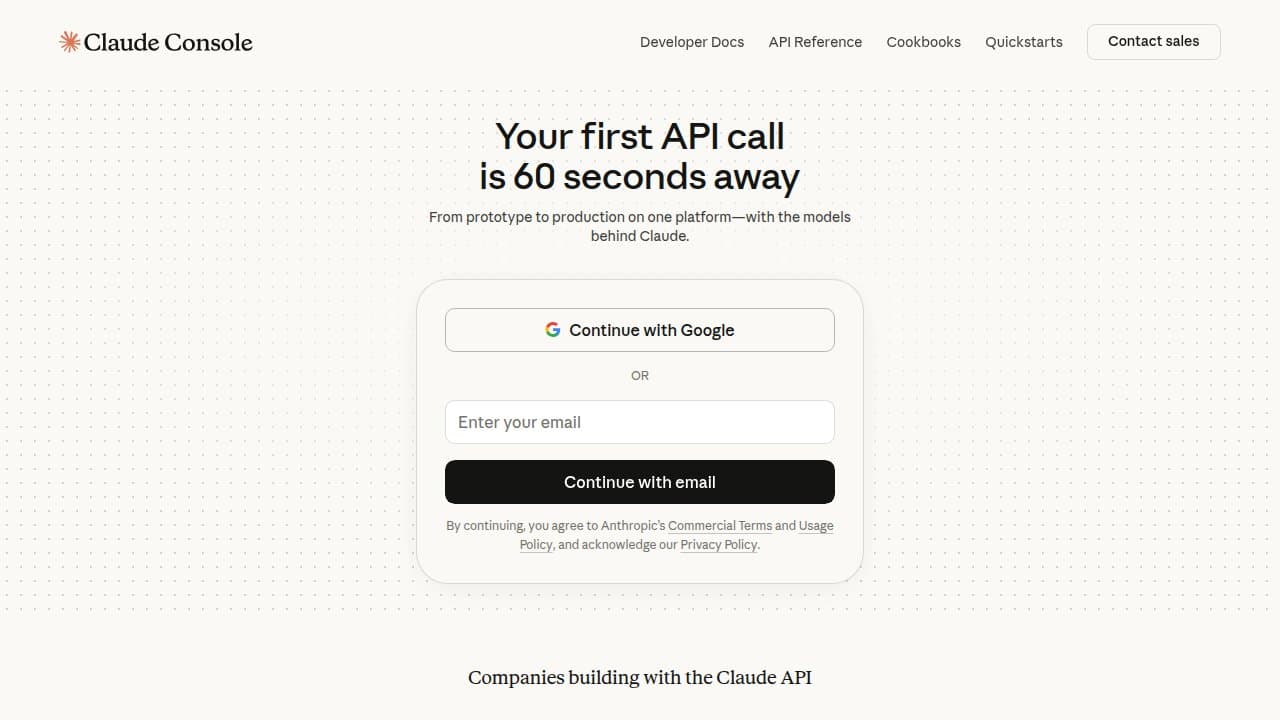
Anthropic Console 是使用 Claude 进行开发的开发者中心。它集成了 Workbench 提示词编辑器、结构化的 Eval 评估框架、API 密钥管理,以及(截至 2026 年 4 月)用于长时间运行的 AI 工作流的 Managed Agents 部署界面。
Anthropic Console (console.anthropic.com) 是使用 Anthropic 开发的 AI 模型系列 Claude 构建、测试和部署应用程序的官方开发者平台。它不是一个独立的 AI 助手——它是每一个 Claude API 集成的控制平面。希望通过 API 访问 Claude 的开发者都需要从这里开始,生成密钥、设置支出限制并监控使用情况。Console 是 Claude API 的必经入口,因此它的普及程度直接反映了 API 本身的采用情况。
该平台拥有三大主要界面:Workbench,一个实时提示词编辑器,开发者在编写代码前可在此进行系统提示词原型设计和参数测试;Evaluate 选项卡,一个结构化的测试套件环境,支持自动生成测试用例、并排比较提示词版本以及 5 分制人工评分;以及 Managed Agents,一项于 2026 年 4 月 8 日至 9 日推出公开测试版的托管智能体基础设施服务,为长周期智能体工作流提供持久化文件系统、会话状态管理和沙盒执行环境。Console 还提供 Files API、提示词缓存控制,以及自 2025 年 10 月起推出的 Skills——可通过 /v1/skills 端点进行版本控制和程序化部署的打包指令集。
Anthropic Console 在 2026 年 4 月的实际功能
Workbench 是新 API 开发者最常用的界面。在编写任何 SDK 代码之前,您可以粘贴系统提示词,配置模型参数(temperature、max tokens、extended thinking budget),并向当前产品线中的任何 Claude 模型(Opus 4.7、Opus 4.6、Sonnet 4.6 或 Haiku 4.5)发送测试消息。当获得理想的响应行为后,只需一键即可导出生产就绪的 API 调用代码。对于没有现有评估基础设施的团队来说,这通常能将提示词设计周期从几天缩短到几个小时。
Evaluate 功能于 2024 年 7 月发布,填补了非正式的 Workbench 测试与生产环境信心之间的空白。开发者描述一项任务,Claude 使用思维链(chain-of-thought)技术生成结构化提示词,然后通过三种方法创建测试用例:手动输入、CSV 导入或由 Claude 针对真实场景自动生成。所有测试用例批量运行,不同提示词版本的输出并排显示,领域专家按 1-5 分制对每个响应进行评分。这使得非工程师人员无需接触代码即可参与提示词质量审查。
Prompt Improver 于 2024 年 11 月添加,它采用 Anthropic 官方文档中的提示词工程技术,自动优化现有的提示词。Nick Garnett 在 2025 年 3 月对 Console 进行了结构化评测,发现该功能带来了显著的提升:“一个分类提示词的准确率提高了 30%。一个摘要提示词实现了对字数要求的 100% 遵循。”缺点是过于冗长——生成的提示词往往比实际需要的更复杂,他指出“你通常会修剪生成的提示词,而不是逐字使用它们。”
Managed Agents 是 2026 年 4 月最重要的新增功能,它将 Console 从一个提示词测试工具转变为一个完整的智能体部署界面。开发者定义智能体行为和工具访问权限,然后将运行时职责(编排、沙盒、会话状态、凭证处理)委托给 Anthropic 的基础设施。智能体的计费标准为每运行小时 $0.08 加上标准模型 Token 成本。持久化记忆(Persistent memory)于 2026 年 4 月 23 日进入公开测试阶段,将智能体记忆作为文件存储在托管文件系统上,开发者可以通过 API 或直接在 Console 中进行检查、编辑和导出。
“Console 专注于 Claude 特有的技术。在这里开发的提示词在 Claude 上表现出色,但如果用于其他 AI 模型可能需要进行调整。”—— Nick Garnett,Substack,2025 年 3 月
Anthropic Console 与 OpenAI Platform 和 Google AI Studio 的定位对比
这三个平台不可互换——每个平台都绑定在其自有的模型系列上。它们在机制上存在巨大差异。
OpenAI Platform vs Anthropic Console:最显著的差距在于微调(fine-tuning)。OpenAI Platform 支持整个 GPT-4.1 模型系列的监督微调(SFT)、直接偏好优化(DPO)和强化微调(RFT)。Anthropic 完全不提供针对 Claude 4.x 的微调——唯一支持微调的 Claude 模型是 Claude 3 Haiku,且仅通过 Amazon Bedrock 提供,而非 Console。这意味着任何需要特定领域模型定制的开发者都不能将 Anthropic Console 作为唯一平台;他们将需要 OpenAI Platform 或 Bedrock。OpenAI 的评估仪表板还直接集成到微调管道中,创建了一个数据飞轮,评估结果可直接反馈到训练迭代中。Anthropic 的 Evaluate 选项卡没有这种下游连接,因为它没有可连接的微调目标。
OpenAI Platform 还通过同一个仪表板和计费账户提供第一方多模态 API——图像生成(DALL-E)、语音转文本(Whisper)、文本转语音(TTS)和嵌入(embeddings)。Anthropic Console 仅涵盖文本和视觉。没有 Anthropic 原生的嵌入、没有 TTS、没有图像生成。对于构建多模态管道的团队来说,即使语言模型在处理大量文本任务时 Claude 表现更佳,OpenAI Platform 的集成度也明显更高。
Google AI Studio vs Anthropic Console:Google AI Studio 是一个更轻量级的原型环境。它的主要优势在于易用性:无需信用卡即可开始使用,通过 Gemini API 提供具有慷慨速率限制的免费层,并在单一界面中原生支持文本、图像、音频和视频。但它缺乏结构化的评估框架。Google AI Studio 没有类似于 Evaluate 选项卡的自动测试用例生成、提示词版本控制或人工评分工作流。希望在 Gemini 上使用评估基础设施的开发者必须使用 LangSmith 或 Langfuse 等第三方工具,并自行构建评估管道。在定价方面,Gemini 2.5 Flash 的输入 Token 成本比同类 Claude 模型便宜约 10 倍,这对于成本敏感、高容量的应用程序来说是一个现实的制约因素。
“Claude 模型支持高达 100 万 Token 的上下文,该平台包括用于提示词迭代的 Workbench、用于跨测试用例测试提示词质量的评估工具,以及从自然语言描述创建系统提示词的提示词生成器。”—— OpenAI vs Anthropic vs Google 成本比较,LLMGateway.io,2026 年
智能体与评估工作流的实际情况
对于构建客户支持自动化的典型团队,Console 工作流如下:工程师打开 Workbench 并用通俗易懂的语言描述用例。Prompt Generator 会生成一个结构化的系统提示词,包含角色定义、任务指令、输出格式和边缘情况处理。工程师创建测试用例——部分从真实的客服工单中手动提取,部分由 Claude 自动生成——并批量运行它们。领域专家(客户服务经理,而非工程师)在 Evaluate 选项卡中对响应进行评分。工程师迭代提示词版本,重新运行完整的测试套件,并可以并排查看两个版本以衡量改进情况。当提示词达到生产就绪状态时,点击“Get Code”即可输出可复制粘贴的 API 调用代码。
Shareable Prompts 功能(2025 年 3 月)允许组织构建集中的提示词库。产品经理(PM)、QA 专家和工程师可以在无需代码访问权限的情况下协作进行提示词迭代。版本历史记录会被追踪,因此如果某次更改导致性能下降,团队可以回滚到早期的提示词版本。
对于智能体部署(2026 年 4 月),工作流进一步延伸:团队在 Console UI 中定义智能体工具和约束,部署到 Managed Agents 基础设施,并通过仪表板监控智能体会话。智能体在隔离的沙盒中运行,每个沙盒都有一个用于多会话状态的持久化文件系统。2026 年 4 月 23 日推出的持久化记忆测试版让智能体能够跨独立会话记住上下文——这对于需要智能体回忆先前交互的客户关系工作流非常有用。
Anthropic Console 是为谁构建的
每个构建 Claude API 集成的开发者都必然会使用 Console——没有其他方法可以获取 API 密钥。除了这种强制性使用之外,Workbench 和 Eval 框架对于进行系统化提示词工程的团队最有价值:编写、测试和迭代需要在生产环境中可靠运行的系统提示词。需要非技术利益相关者参与质量审查的组织,将从 Evaluate 选项卡的人工评分 UI 中获益最多。
希望运行智能体工作负载而无需管理自身基础设施的企业团队,现在可以通过 Managed Agents 获得清晰的路径,尽管在 $0.08/小时加上 Token 成本的定价下,从经济角度来看,这更适合中等容量的生产智能体,而不是高吞吐量的管道。
Anthropic Console 不是什么
Console 不是模型无关的。每一个功能——Workbench、Eval、Skills、Managed Agents——都是专为 Claude 设计的。在这里优化的提示词可能需要针对 GPT 或 Gemini 进行调整,并且没有多供应商提示词管理功能。需要比较供应商或保持可移植性的开发者应考虑使用 Helicone、LangSmith 或 Langfuse 等第三方工具。
Console 不提供针对 Claude 4.x 的微调。对于需要超越系统提示词和少样本(few-shot)示例所能实现的自定义模型行为的团队,无法直接通过 Anthropic 获得旗舰模型的微调路径。
速率限制和配额管理一直是一个被记录在案的摩擦点。自 2026 年初以来,开发者报告称达到 API 速率限制的速度比预期要快,尤其是在 Claude Code 集成中。2026 年 4 月的 Opus 4.7 分词器(tokenizer)更改,与早期的 Claude 模型相比,每次请求消耗的 Token 增加了 1.0-1.35 倍,这让一些团队遭遇了成本上的意外,而这些在发布时并未明确传达。
如果您的用例需要以下内容,请跳过 Anthropic Console:微调的自定义模型(使用 OpenAI Platform);来自同一供应商的第一方嵌入、TTS 或图像生成(使用 OpenAI Platform);模型无关的提示词管理(使用 LangSmith 或 Helicone);或者在 Gemini 2.5 Flash 的 10 倍价格优势至关重要的情况下,以最低成本实现批量 Token 吞吐量(使用 Google AI Studio)。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
相关文章
与 Anthropic Console 相关的指南和文章。
Claude Code Dreaming (Memory Consolidation): 2026 Setup Guide
Cut Your AI Agent Token Bill 5x: The Claude Code Efficiency Patterns (2026)

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Google vs OpenAI vs Anthropic Agents: The May 2026 Platform Showdown
