Groq 是一款 AI 推理引擎,利用定制芯片以极高的速度运行开放权重模型。它能帮助开发者构建实时语音代理和快速的数据管道。该平台不提供像 GPT-4o 这样的专有模型,并且对其免费套餐施加了严格的速率限制。
什么是 Groq?
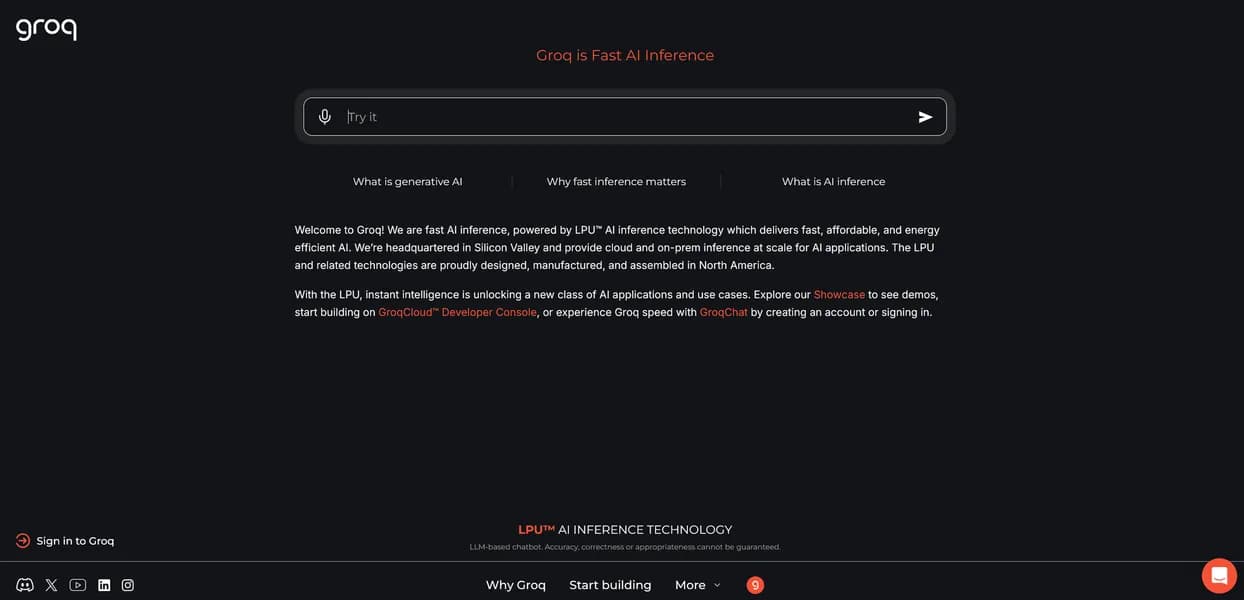
Groq 是一款以极高速度运行开放权重模型的 AI 推理引擎。它用专为语言生成打造的定制芯片取代了传统的图形处理单元。这种硬件被称为语言处理单元(Language Processing Unit)。对于 Llama 3.1 和 Mixtral 等模型,您可以获得亚秒级的响应时间。系统按顺序处理 token 以最大化吞吐量。
Groq, Inc. 构建此平台是为了解决生成式 AI 中的延迟问题。标准云提供商很难为实时语音代理提供足够快的文本生成速度。构建交互式聊天机器人的开发者使用 Groq 来消除对话中尴尬的停顿。其 API 结构模仿了 OpenAI,使迁移变得简单。您只需在现有代码中更改基础 URL 和 API 密钥即可。
- 主要用例: 构建需要亚秒级延迟的实时对话式 AI 聊天机器人。
- 最适合: 构建代理工作流和实时翻译应用程序的开发者。
- 定价: $0.01 起(按需付费):根据消耗的 token 数量计费。
核心功能与 Groq 的工作原理
硬件与架构
- LPU 架构: 专为确定性顺序处理设计的专有硬件。这种芯片避免了标准 GPU 中常见的内存瓶颈。仅限于 Groq 数据中心使用。
- 确定性性能: 无论模型负载如何,延迟始终保持一致。即使在高峰时段,您也能获得完全相同的响应时间。受限于用户与服务器之间的网络延迟。
- 速率限制管理: 详细的仪表板可跟踪您每分钟的请求数(RPM)和每天的 token 数(TPD)。您可以实时监控使用量的激增。仅限于基本指标,不提供高级成本预测。
模型支持与集成
- 原生模型托管: 运行 Llama 3.1、Gemma 2 和 Mixtral 8x7B。这些模型可瞬间加载到 LPU 内存中。仅限于开放权重模型。
- OpenAI 兼容性: API 端点与 OpenAI 结构完全一致。您可以使用现有的 OpenAI 库来调用 Groq 模型。仅限于托管模型支持的文本和视觉端点。
- Python 和 Node.js SDK: 用于代码集成的官方库。这些包会自动处理身份验证和重试。官方支持仅限于这两种主要语言。
高级功能
- Whisper 集成: 使用 Whisper Large V3 进行语音转文本处理。系统以近乎即时的周转时间转录音频文件。受限于音频文件上传大小上限。
- 工具使用: 用于外部 API 交互的函数调用。模型可以触发数据库查询或网络搜索。受限于特定模型遵循指令的准确性。
- 视觉功能: 通过 Llama 3.2 Vision 进行多模态图像分析。您可以将图像传递给模型以获取详细描述。仅限于特定的图像格式和分辨率。
Groq 的优缺点
优点
- 在 Llama 3 8B 上每秒生成超过 500 个 token。
- 首个 token 延迟(Time-to-first-token)极低,足以满足实时语音应用的需求。
- 按需付费的定价低于标准 GPU 云提供商。
- 兼容 OpenAI 的 API 结构使迁移变得快速简单。
- 为生产工作负载提供高可靠性,并配有专属企业支持。
缺点
- 模型选择不包括像 GPT-4o 这样的专有选项。
- 免费套餐的速率限制在测试期间会导致频繁的 429 错误。
- 不支持自定义模型权重的微调。
- 与专用的多模态平台相比,视觉功能仍然有限。
谁应该使用 Groq?
- 语音 AI 开发者: 语音代理需要即时响应才能显得自然。Groq 提供了必要的速度来消除尴尬的沉默。
- 高容量数据处理者: 通过 Llama 3.1 处理数百万份文档的团队可以节省资金和时间。高吞吐量可在几分钟内处理海量数据集。
- 实时翻译构建者: 实时翻译语音的应用程序需要低延迟。LPU 架构可以轻松处理这种连续的文本流。
- 全能型企业团队: 需要单一提供商来处理所有 AI 任务的公司应该寻找其他选择。Groq 缺乏专有的前沿模型和微调功能。
Groq 定价与套餐
免费套餐每月费用为 $0。它提供对所有受支持模型的访问,但施加了严格的每分钟请求数和每天 token 数限制。您无需信用卡即可开始使用。
在活跃的开发过程中,您会很快触及这些限制。
(我在测试基本代理循环的十分钟内就触发了速率限制错误)。
开发者套餐采用按需付费模式。价格约为每百万 token $0.01 起,具体取决于特定模型。该套餐提高了生产使用的速率限制。您只需为您消耗的实际计算量付费。其定价结构低于运行标准 NVIDIA 硬件的主要云提供商。
企业套餐需要定制合同。它针对需要专用容量和自定义速率限制的高容量生产工作负载。您将获得有保障的正常运行时间以及来自工程团队的直接技术支持。
Groq 与替代方案的比较
Together AI 提供了更广泛的开放权重模型选择。您可以访问专门的编码模型和旧版本的 Llama。Groq 将其目录限制在少数几个经过优化的模型上以保证速度。Together AI 使用标准 GPU,这意味着对于大多数任务来说推理速度较慢。
Anyscale 提供对开放模型的类似 API 访问,但侧重于自定义微调。您可以在 Anyscale 基础设施上训练自己的模型权重。Groq 仅提供由原始开发者提供的基础模型和指令微调变体。Anyscale 更适合构建高度专业化领域模型的团队。
Perplexity AI 专注于搜索和检索增强生成。它提供带有实时网络引用来源的答案。Groq 为开发者提供原始推理计算能力来构建他们自己的应用程序。如果您使用 Groq,则必须构建自己的检索系统。
速度优先的开发者评价
Groq 为 Llama 3.1 和 Mixtral 提供了目前最快的推理速度。构建实时语音代理或高速数据管道的开发者能立即获得价值。LPU 硬件改变了交互式应用程序的体验。按需付费套餐节省的成本使其成为高容量文本处理的轻松之选。
需要 GPT-4o 或 Claude 3.5 Sonnet 的团队必须寻找其他选择。
如果您需要在运行开放模型之前对其进行微调,请选择 Anyscale。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
相关文章
与 Groq 相关的指南和文章。

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
Build a 70-Language Live Voice Agent With GPT-Realtime-Translate (2026)