
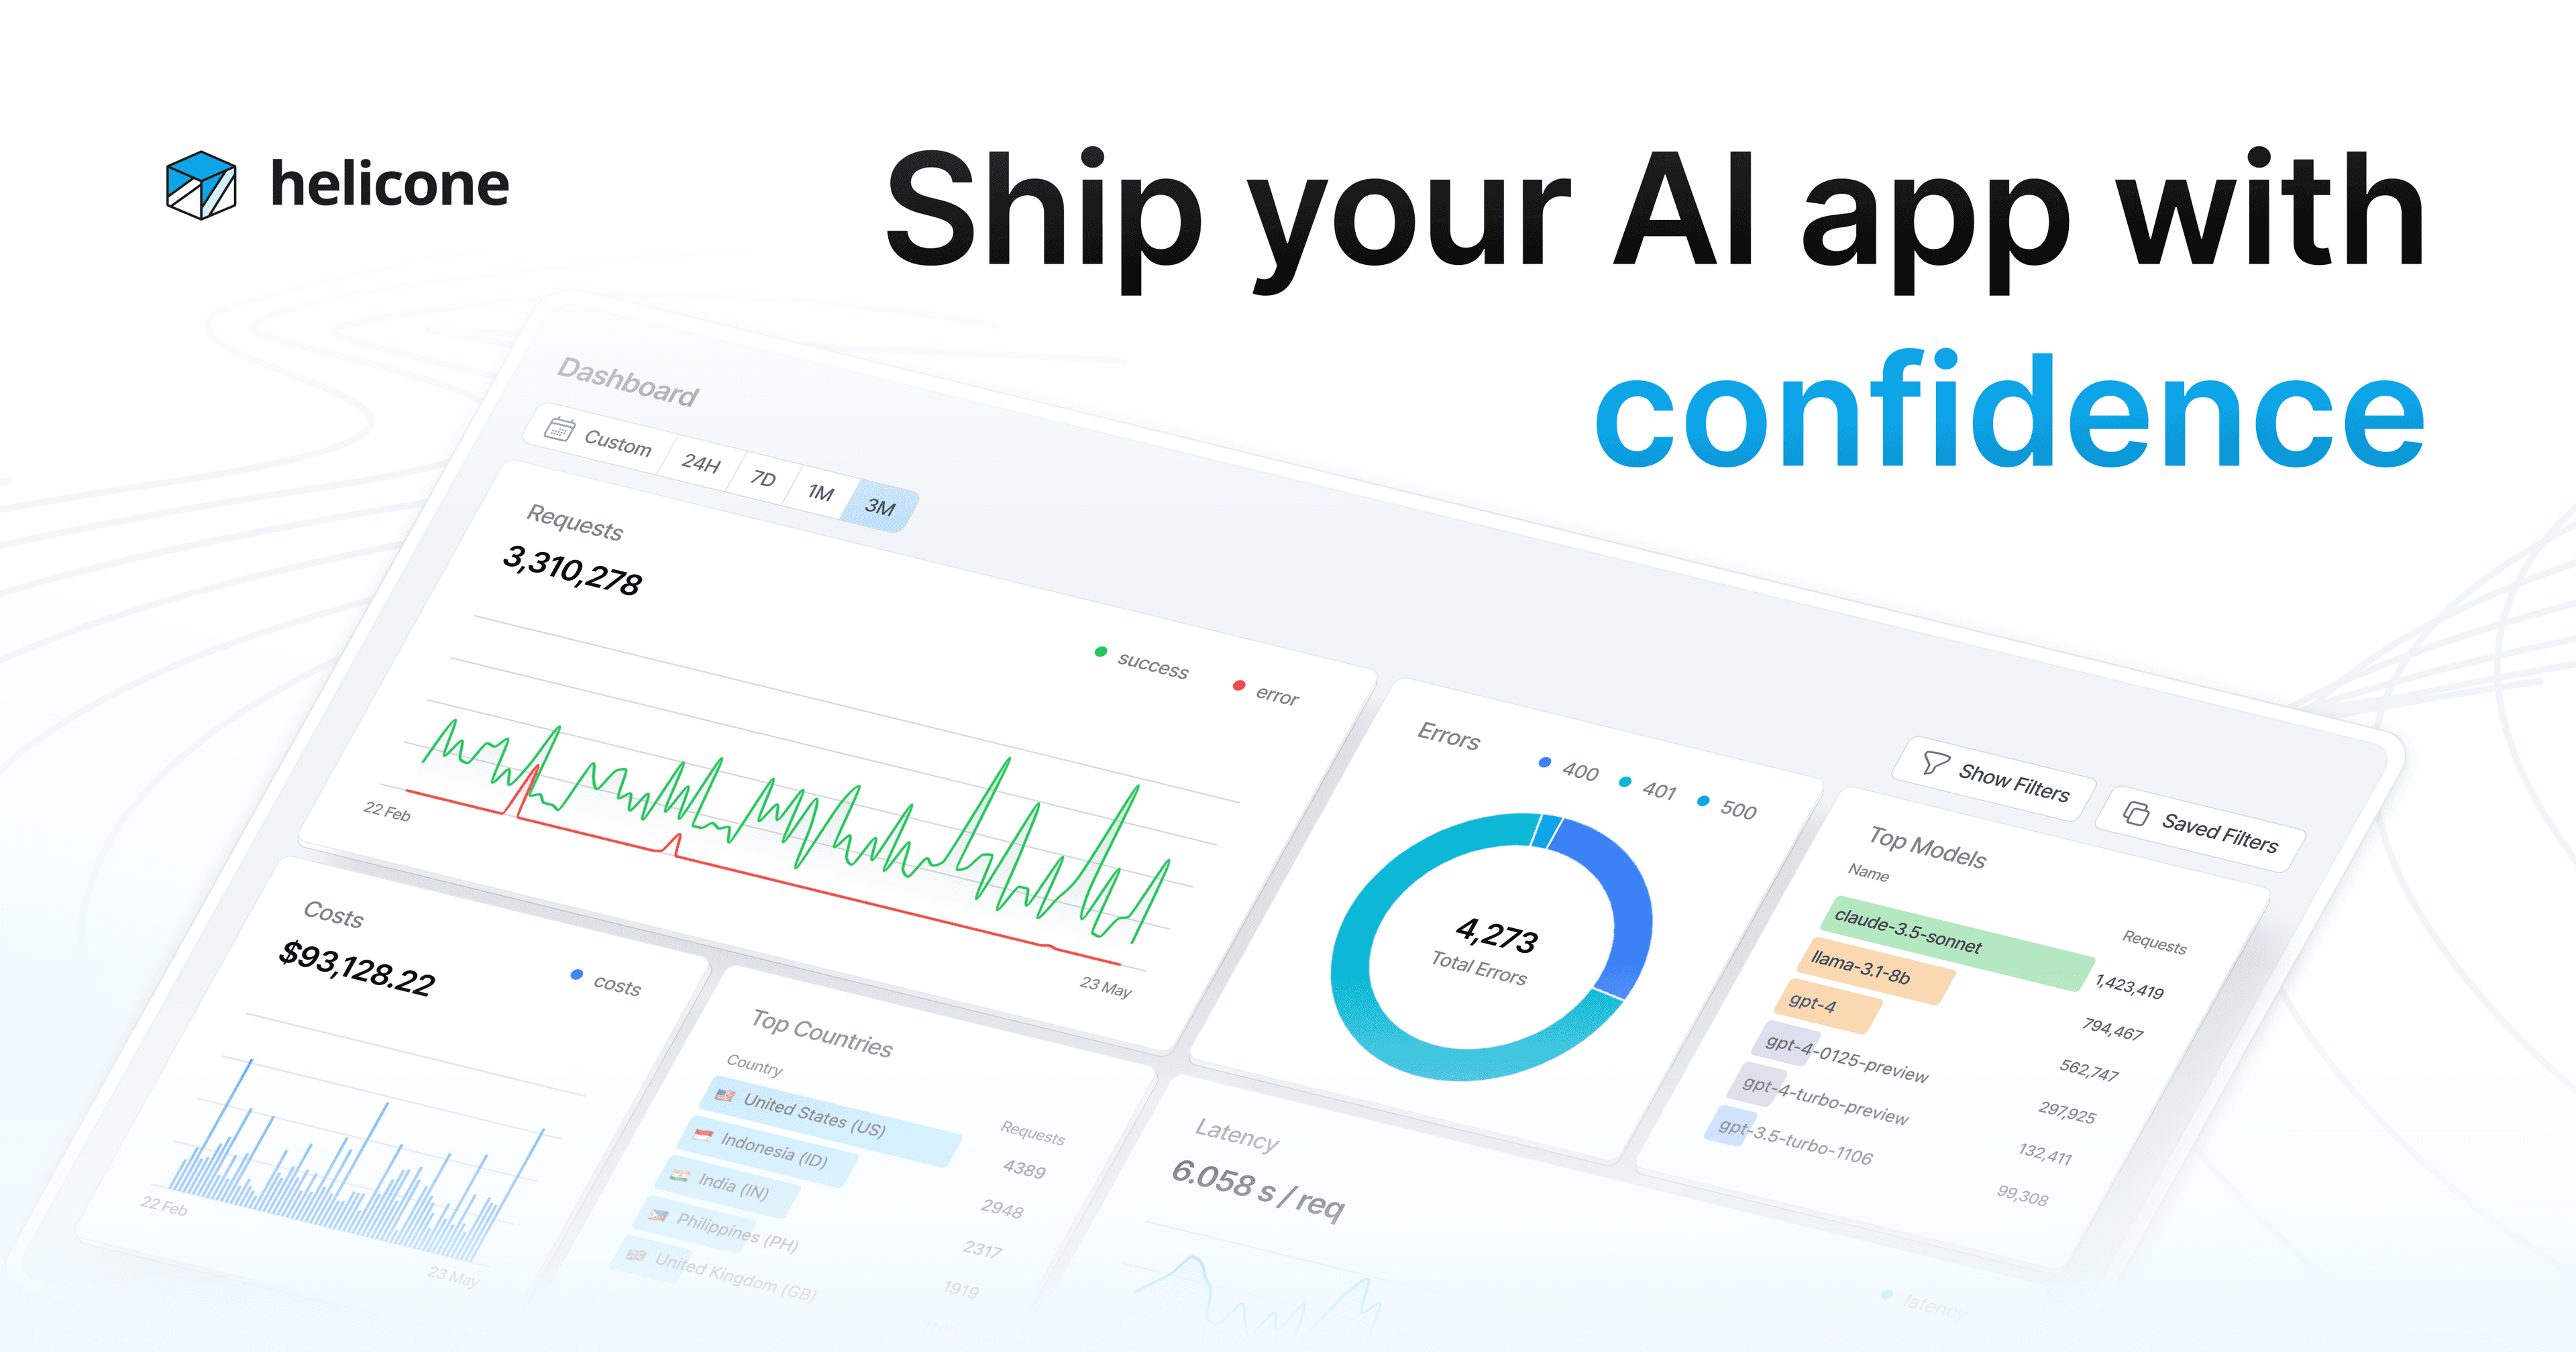
Helicone 是一个来自 YC W23 的开源大语言模型 (LLM) 可观测性平台和 AI 网关。只需替换一个 URL,团队即可在 OpenAI、Anthropic 和 100 多种模型中实现成本跟踪、请求日志记录、语义缓存和提示词管理。在 2026 年 3 月被 Mintlify 收购之前,已有 16,000 家组织使用。
Helicone 是一个开源的 LLM 可观测性平台和 AI 网关,由 Justin Torre 和 Cole Gottdank 构建,于 2023 年通过 Y Combinator 的 W23 批次推出。它解决的核心问题非常实际:当团队开始发布 AI 应用程序时,他们很快就会失去对 LLM 实际运行情况、成本消耗以及故障位置的可见性。Helicone 通过基于代理的架构恢复了这种可见性,将请求路由通过其基于 Cloudflare Workers 的网关,从而自动记录、计时和分析对 OpenAI、Anthropic、Gemini、Mistral 或 DeepSeek 的每一次调用。在 2026 年 3 月 3 日被 Mintlify 收购之前,Helicone 已经在 16,000 个活跃组织中处理了 14.2 万亿个 Token。
该平台的标志性功能是单行代码集成:只需将您的 OpenAI 基础 URL 替换为指向 Helicone 的网关,您的整个应用程序即可立即完成检测,无需封装 SDK。除了基础的日志记录外,Helicone 还提供语义缓存(团队经常报告这能削减 20-40% 的 LLM 成本)、具有自动提供商故障转移功能的 AI 网关路由、提示词版本控制和管理、用于自定义分析查询的 HQL(Helicone 查询语言)、速率限制,以及一个用于在真实生产数据样本上测试提示词变体的 Playground。该平台采用 Apache 2.0 许可证,完全支持通过 Docker 或 Helm 进行自托管。自 2026 年 3 月被 Mintlify 收购以来,Helicone 处于维护模式,继续提供安全补丁、新模型支持和错误修复,但不再开发重大的新功能。
2026 年 4 月的 Helicone 实际功能
Helicone 作为一个透明的 HTTP 代理,位于您的应用程序和任何 LLM 提供商之间。当您调用 openai.baseURL = "https://oai.helicone.ai/v1" 时,请求会穿过 Helicone 的 Cloudflare Workers 边缘网络,记录到 ClickHouse 以供分析,并转发给 OpenAI,在 p50 延迟基准下开销不到 5 毫秒。该平台通过其统一的 AI 网关支持 100 多种模型,包括 OpenAI、Anthropic、Azure OpenAI、Google Gemini、DeepSeek、Mistral、Together AI、OpenRouter 和 Groq。集成支持扩展到 30 多种框架,包括 LangChain、LlamaIndex、Vercel AI SDK 和 LiteLLM。
可观测性仪表板按用户、会话、端点和模型细分显示成本、延迟和质量指标。团队可以使用 HQL 对其请求历史记录编写自定义查询,类似于在 LLM 日志之上进行 SQL 分析。Prompts 功能允许将提示词版本控制与真实的生产数据绑定,并通过网关直接部署新的提示词版本,无需部署代码。Helicone 的 Datasets 功能让团队能够从采样的生产流量中构建评估集,而 Playground 则支持在推广提示词变体之前对其进行实时测试。内置的警报和报告涵盖了成本激增、错误率和延迟异常。
该平台在生态系统中赢得一席之地部分归功于时机:它推出时,记录 LLM 调用还需要构建自定义中间件,而它以极低的摩擦真正解决了这个问题。在被收购时,它是 YC 投资组合公司中最常用的 LLM 可观测性工具,并且在发布当天曾位列 Product Hunt 第一名。
"Helicone 开箱即用,对我们深入调查用户问题非常有帮助" - Brandon Chen,Product Hunt,2024
Helicone 与 Langfuse 和 LangSmith 的定位对比
这三个平台之间的机制差异是架构上的,而非表面上的。Helicone 在网络层进行拦截,位于您的应用程序代码和 LLM 提供商的 API 端点之间。它看到的是单个 HTTP 请求和响应。Langfuse 和 LangSmith 在应用层进行集成,通过 SDK 调用将智能体步骤和工作流逻辑封装在您的代码中。这种区别决定了每个平台实际能观测到的内容。
Langfuse(MIT 许可证,19K+ GitHub 星标,支持自托管)需要显式的 SDK 插桩:开发人员将每个智能体步骤、追踪跨度 (trace span) 和评估钩子封装在 Langfuse SDK 调用中。这需要 1-2 小时的设置时间,但能提供具有嵌套跨度层级的完整多步智能体工作流可见性。Langfuse 可以看到 LLM 调用 B 是由智能体运行 X 内部的工具调用 A 触发的,而 Helicone 的代理如果不进行手动请求头标记则无法捕获这一点。Langfuse 还有一个更成熟的提示词管理和数据集评估系统。自托管选项完全免费;云服务起价为 $50/月,并提供每月 5 万次事件的慷慨免费额度。对于希望在自己的基础设施中自托管可观测性数据的团队来说,Langfuse 是明确的选择。
LangSmith(LangChain 的可观测性产品,Plus 计划 $39/月)与框架紧密耦合。对于已经使用 LangChain 或 LangGraph 的团队,通过两个环境变量即可实现几乎零配置的追踪。LangSmith 原生理解 LangChain 的链式拓扑结构,知道哪个工具触发了哪个 LLM 调用,并自动呈现该上下文。对于不使用 LangChain 的团队,手动插桩需要 2-3 小时,且 LangSmith 会失去其主要优势。2025 年 3 月,LangChain 为 LangSmith 添加了端到端的 OpenTelemetry 支持,在一定程度上减少了供应商锁定。LangSmith 内置的评估工具和每次运行的 Playground 比 Helicone 的同类功能更深入。
Helicone 相对于两者的优势在于设置速度(不到 15 分钟,零应用程序代码更改)和内置的语义缓存,而 Langfuse 和 LangSmith 都不原生提供后者。以 $79/月 的价格提供无限席位,对于成长中的团队来说,Helicone 也比两者更便宜。权衡之处在于:Helicone 看到的是单个 API 调用,而不是工作流拓扑。如果您的应用程序是一个简单的 LLM 调用链,Helicone 能为您提供所需的一切。如果它是一个复杂的多步智能体,您需要了解为什么第 7 步触发了特定的模型调用,那么您需要 Langfuse 或 LangSmith。
"它为我提供了关于使用情况、成本和响应时间的极其有用且详细的洞察" - Ryan Hendrickson,Product Hunt,2024
代理在日常实际使用中的表现
集成体验确实兑现了它的承诺。对于运行 OpenAI 调用的团队,只需在 OpenAI 客户端构造函数中更改一行代码。对于 Anthropic 团队,同样只需替换一个请求头。从那一刻起,每个请求都会出现在 Helicone 仪表板中。成本跟踪是自动的:Helicone 将每个模型和 Token 数量映射到其当前提供商的定价,并向您准确显示每个端点、用户或功能每天的成本。延迟百分位数(p50、p90、p99)按模型和请求类型细分。
语义缓存是大多数团队在描述投资回报率 (ROI) 时提到的功能。Helicone 对每个请求进行嵌入 (embedding),在可配置的相似度阈值内检查缓存中语义相似的先前响应,如果满足阈值则返回缓存的响应。具有高重复工作负载的团队(客户支持机器人、文档问答系统、编码助手)通常报告在启用该功能后的一周内成本降低了 20-40%。配置是通过仪表板完成的,而不是代码。
在生产环境中出现的挫折往往集中在代理架构无法看到的内容上。当一个智能体工作流在七个步骤后失败时,Helicone 仪表板会显示七个单独的 API 调用及其成本和延迟,但不会显示它们是如何连接的,或者哪个上游决策触发了失败。通过 Helicone 调试多步智能体故障需要手动进行会话标记和追踪关联,这抹杀了“无代码更改”的优势。达到这种复杂程度的团队通常会添加 Langfuse 作为第二层,或者完全迁移。
Helicone 适合哪些用户
对于需要快速获得 LLM 可观测性且不想对其代码库进行插桩的团队来说,Helicone 是合适的工具。主要受益者是早期的 AI 产品团队(2-20 名工程师)、运行简单 LLM 管道而不是复杂多步智能体的团队,以及希望在不构建基础设施的情况下获得缓存和分析功能的注重成本的团队。
它特别适合跨多个提供商运行请求的多模型团队。统一的仪表板将 OpenAI、Anthropic 和其他提供商的成本汇总到一个视图中,这很难仅用提供商原生工具来复制。对于快速迭代提示词的初创公司,Playground 和 Datasets 功能让非工程师无需接触代码即可在生产数据样本上运行提示词实验。对于不到 10 人的团队,如果他们只需要回答“我们这个月的 LLM 支出是多少,是哪个功能引起的”,Helicone 可以说是功能过剩的,但绝对绰绰有余。
SOC-2 和 HIPAA 合规性包含在 $799/月 的 Team 计划中,这把需要合规性的小型团队拒之门外。在欧盟有严格数据驻留要求的企业组织可能会发现,即使有 Cloudflare 的边缘网络,代理模型也让人感到不安:每个 LLM 请求(包括用户内容)都会穿过 Helicone 的基础设施。2023 年 3 月的 HN 发布帖明确提出了这些担忧,多位评论者询问了关于欧盟 PII 的问题,以及代理架构是否违反了 OpenAI 的服务条款。Helicone 回答了这两个问题,但处理生产流量的云代理的架构现实仍然是数据敏感型用例需要考虑的因素。
Helicone 不是什么
Helicone 是一个监控层,而不是一个全栈可观测性平台。它不支持带有自动评分、回归检测或评估套件质量测量的提示词评估管道。它的 Scores 功能允许对请求附加手动数字评分,与 Langfuse 或 Braintrust 的评估工具相比,这非常基础。当请求失败或产生不良输出时,Helicone 会记录下来,但没有问题状态机,没有生命周期跟踪,也没有机制来确定反复出现的问题是已解决还是已恶化。
自 2026 年 3 月以来的维护模式状态也是相关的背景信息。今天选择 Helicone 的团队选择的是一个处于收尾阶段的产品:安全补丁和新模型的添加将继续,但产品路线图已经停止。对于具有多年规划、需要其依赖的可观测性平台持续活跃开发的团队来说,这是一个真正的限制。Helicone 团队明确将 LiteLLM 和 Portkey 列为寻求持续活跃开发的团队的替代方案。
开始使用 Helicone
入门路径是该平台最强大的功能。在 helicone.ai 创建一个免费账户,复制您的 Helicone API 密钥,并将您的 OpenAI 客户端的基础 URL 替换为 https://oai.helicone.ai/v1,同时将 Helicone 密钥作为请求头添加。这一个简单的更改就能将所有 OpenAI 流量发送通过 Helicone。对于 Anthropic,指向 https://anthropic.helicone.ai。对于 Azure OpenAI、Google Gemini 等,Helicone 提供了特定于提供商的网关 URL。从开始到记录第一个请求的典型时间不到五分钟。
免费的 Hobby 层每月可处理 10,000 个请求,数据保留 7 天,足以满足开发和轻量级生产使用。$79/月 的 Pro 计划解锁了无限席位、1 个月的数据保留、警报和 HQL 分析查询。文档中提供了使用 Docker 和 Helm 进行自托管的指南,包含完整的五服务技术栈(NextJS web、Cloudflare Worker、Express API、Supabase、ClickHouse、MinIO)。对于需要将数据保留在第三方基础设施之外的团队,自托管是可行的,尽管这需要维护技术栈。位于 github.com/Helicone/helicone 的 GitHub 仓库拥有 5.6K 颗星,其基于 Rust 的 AI 网关组件的基准测试结果显示,在高吞吐量下 p50 开销不到 5 毫秒。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 Helicone 的精选合集。
相关文章
与 Helicone 相关的指南和文章。
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Replace 6 SaaS Subscriptions With 4 n8n AI Agents (2026)
