
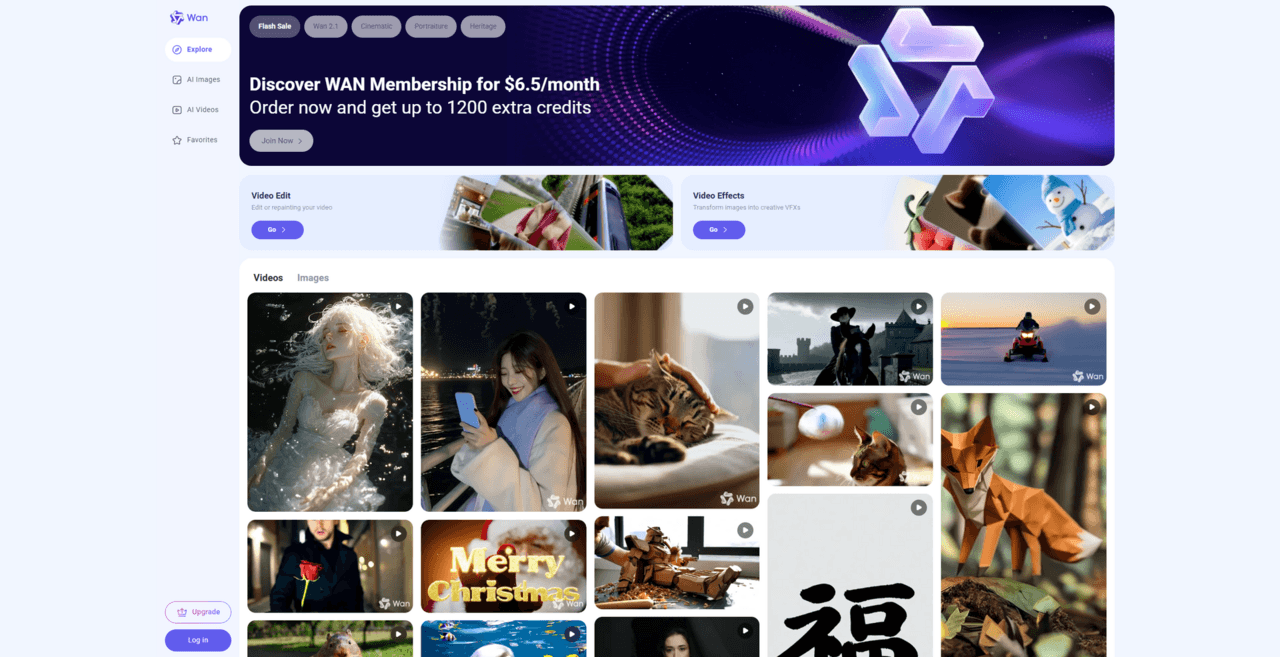
WAN 是 Alibaba 推出的开源权重视频生成系列模型(涵盖 2.1 至 2.7 版本),在 Apache 2.0 许可下提供文生视频、图生视频及编辑功能。该系列在 2025 年 2 月发布时即登顶 VBench 排行榜,并迅速成为自托管 AI 视频创作的首选。
WAN 是由 Alibaba 旗下 DAMO Academy 的 Tongyi Lab 开发的一系列开源权重视频生成模型。该系列于 2025 年 2 月 25 日以 Wan 2.1 版本公开发布,随即登顶开源视频生成领域的 VBench 排行榜,得分超越了此前所有的开源模型,并在零授权成本的情况下媲美多款商业 API。其权重基于 Apache 2.0 协议发布,这意味着任何人都可以下载、运行、微调和重新分发这些模型,用于个人或商业用途,而无需向 Alibaba 支付任何费用。到 2026 年 4 月,该系列已迭代至 2.2、2.5、2.6 和 2.7 版本,每次重大更新都带来了全新功能:电影级运镜控制、原生音频,以及在最新的 2.7 API 中引入的推理优先的“Thinking Mode”(思考模式)。
其核心功能涵盖文生视频 (T2V)、图生视频 (I2V)、首尾帧生视频 (FLF2V)、视频创作与编辑 (VACE)、语音生视频 (S2V) 以及角色动画。旗舰级 14B 参数模型可在 RTX 4090 等消费级 GPU 上生成 480p 和 720p 视频片段,而紧凑的 1.3B 模型仅需 8.19 GB 显存即可运行,使其成为少数能在中端游戏显卡上流畅运行的专业级视频模型之一。自发布以来,围绕该系列已形成了一个繁荣的生态系统,包括各种 LoRA、ComfyUI 工作流以及第三方封装工具(特别是 ComfyUI 集成和专为低显存设备设计的 Wan2GP 封装工具)。
WAN 在 2026 年 4 月的输出表现
Wan 2.1 仍是大多数创作者在本地运行的版本,可生成长达 5 秒、分辨率为 480p 或 720p、帧率为 16 fps 的视频片段。14B T2V 模型能够处理电影级运动、细腻的环境细节以及精确的物理效果。1.3B T2V 则在视觉细节与硬件门槛之间取得了平衡。I2V-14B 变体可将静态图像转化为动态视频,而 FLF2V-14B 模型则能在起始帧和结束帧之间进行插值。2025 年 5 月发布的 VACE(视频全能创作与编辑)在相同权重的基础上,新增了内画 (inpainting)、外画 (outpainting) 以及指令引导编辑功能。
Wan 2.2(2025 年 7 月)引入了首个用于视频扩散的开源混合专家 (Mixture-of-Experts, MoE) 架构:总计 270 亿参数分布在两个专家网络(高噪去噪专家和低噪细化专家)中,每个推理步骤仅激活 140 亿参数。与 2.1 版本相比,图像训练数据增加了 65.6%,视频训练数据增加了 83.2%。新的模型变体增加了语音生视频 (S2V-14B) 和全角色动画 (Animate-14B) 功能,后者能够将单张照片转化为连贯的视频序列。
Wan 2.5(2025 年 9 月)加入了原生音频功能:在生成视频帧的同时,一次性生成同步的对话、音效和环境背景噪音。该模型支持 1080p 输出和 10 秒时长的片段。Wan 2.7(2026 年 4 月 6 日)带来了“Thinking Mode”(思考模式),模型在生成前会显式规划场景构图,从而实现更好的叙事连贯性和更清晰的角色特征。然而,Wan 2.7 以闭源权重的形式发布,仅通过付费 API 提供,价格为每秒 720p 视频 $0.10。这与之前所有版本秉持的开源权重理念有着显著的不同。
对于希望在有限硬件上运行 WAN 的用户,由 deepbeepmeep 开发的社区封装工具 Wan2GP 在某些配置下将显存需求降至 6 GB,增加了 Web UI,支持多种模型(WAN 2.1/2.2、HunyuanVideo、LTX Video、FLUX),并包含基于队列的批处理功能。对于没有 RTX 4090 的用户来说,这是最实用的入门选择。
WAN 与 HunyuanVideo 及 Mochi 1 的对比
HunyuanVideo(Tencent,2024 年 12 月开源发布)基于因果 3D VAE 构建,采用双流 Transformer 架构,拥有 130 亿参数。其架构优势在于多角色场景的连贯性:在正面测试中,包含 3-5 个不同角色的场景在保持个体特征、正确的空间定位和协调运动方面优于 WAN。但代价也是高昂的:HunyuanVideo 生成 720p 视频至少需要 45-60 GB 的 GPU 显存,这使其牢牢定位于数据中心或多 GPU 工作站级别。相比之下,WAN 的 1.3B 模型可以在单张配备 8 GB 显存的 RTX 3060 上运行。对于使用消费级硬件的创作者来说,HunyuanVideo 并非现实的替代方案;而对于运行 A100 集群的工作室而言,其角色保真度足以证明计算成本的合理性。您可以在 HunyuanVideo 的页面 上对比这两种选择。
Mochi 1(Genmo,2024 年 10 月)是一个拥有 100 亿参数的模型,基于非对称扩散 Transformer (AsymmDiT) 构建,其视觉流的参数量几乎是文本流的四倍。它以 30 fps 输出 480p 视频,运动流畅度明显优于 WAN 2.1 的 16 fps。其局限在于硬件门槛:单 GPU 部署大约需要 60 GB 显存。在四个月后 WAN 2.1 发布并占据 VBench 榜首之前,Mochi 1 一直是开源领域的标杆。此后,WAN 2.2 的 MoE 架构进一步拉大了在整体质量上的差距,而 WAN 的 I2V、VACE 和编辑管线赋予了它更广泛的功能面。Mochi 1 仍然是一个值得关注的优秀早期产品,您可以在 Mochi 1 的页面 查看,特别是如果您拥有足够的硬件并追求运动流畅度的话。
与商业服务相比:Runway Gen-3 和 Pika 提供了完善的 Web 界面和更快的生成速度,无需本地设置,但按片段收费。Sora 和 Luma AI 能生成高质量的输出,但受到订阅或积分付费墙的限制。WAN 的核心价值主张恰恰在于它是免费的、可离线运行、支持微调,并且除了您的 GPU 性能上限外,没有任何使用限制。
“Wan 2.1 生成的视频非常出色,很难相信它们是由一款免费的 AI 应用制作的。” - BGR 编辑评论,2025 年 2 月 26 日
“这改变了任何基于 Wan 系列的开源可访问性进行构建或评估的人的考量。” - Tellers.ai,关于 Wan 2.7 闭源权重公告的评论,2026 年 4 月 15 日
使用 WAN 生成视频的真实成本
对于开源权重版本(2.1 至 2.6),向 Alibaba 支付的成本为零。您只需为自己的电费和硬件买单。在未优化的情况下,使用 RTX 4090 以 FP16 精度生成 5 秒的 480p 片段,每个片段大约需要 4 分钟。通过 FP8 量化或运行 8-10 个推理步骤的加速 LoRA,社区基准测试表明,在同一 GPU 上,每个片段的生成时间可降至约 90 秒。在 RTX 4070 Ti (12 GB) 上,1.3B 模型的生成速度相当;而 14B 模型则需要手动量化或使用 GGUF 格式。
对于没有本地 GPU 的用户,可以选择云端租赁方案。RunPod、ThinkDiffusion 和 Spheron 均提供配置了 WAN 的 GPU 实例。RunPod 上的 4090 实例成本约为 $0.74/小时;如果每小时生成 10 个片段,则每个片段的成本约为 $0.07。对于大批量工作而言,这仍然比大多数商业 API 便宜,尽管 Wan 2.7 的 API 费率(每秒 720p 视频 $0.10)对于需要该版本的 Thinking Mode 功能且不想管理基础设施的用户来说,也具有一定的竞争力。
真正的成本障碍在于时间:模型文件大小从 5 GB(1.3B,GGUF 量化版)到 28 GB(14B,完整 FP16 版)不等。在 ComfyUI 或 Wan2GP 中进行首次设置时,需要将模型下载到特定的目录路径,分别配置文本编码器和 VAE,并解决环境依赖问题。没有 Python 经验的用户反馈,初始设置通常需要花费 2-4 小时。完成设置后,生成过程就非常简单了。
WAN 的常见局限与问题
较长片段中的角色一致性: 独立测试在角色一致性方面给 WAN 2.5 打出了 3.0/5 的评分,指出“面部特征和风格在帧与帧之间有明显的偏移”。这会影响任何涉及特定角色贯穿整个片段的提示词:面部发生漂移,衣着出现细微变化,身体比例发生偏移。WAN 2.2 中的 Animate-14B 变体专门解决了肖像动画的问题,但多角色叙事场景仍然不够稳定。
复杂的环境细节: 详细的风景提示词在片段中途会丢失特定元素。例如“倒影湖面上持续的薄雾和柔和的晨间逆光”,可能在开头表现正确,但到了后半段,雾气变薄、倒影改变或光线发生偏移。在密集的环境提示词中,时间一致性弱于单主体或简单背景的提示词。
AMD GPU 性能: ComfyUI 的 GitHub 问题追踪显示,由于显存卸载行为,WAN 2.2 在 AMD/ROCm 显卡上生成第二个片段时,速度有时会比第一个片段慢 4-5 倍。完全重启可以恢复速度。这是一个已知问题,第三方补丁的修复效果参差不齐。
WAN 2.2 中的慢动作伪影: 一些用户报告称,除非明确配置帧率设置,否则 WAN 2.2 默认会生成看起来像慢动作的画面。社区的解决方法是在 ComfyUI 中强制设置步数和 fps,而不是依赖默认值。
非技术用户的设置阻力: WAN 不是一个即开即用的产品。它需要 Python 环境、将模型放置在特定的子目录中,以及了解推理参数。Wan2GP 和第三方云端封装工具解决了这个问题,但它们增加了延迟,有时还会限制可用的模型变体。
最佳用例与避坑指南
在以下情况使用 WAN: 您希望获得最佳的开源视频生成效果,且无需按片段付费。您拥有 RTX 3060 或更好的显卡(或愿意租赁 GPU 算力)。您希望针对自己的素材或风格进行微调。您需要离线生成,不受 API 调用、速率限制或内容政策的约束。您已经在使用 ComfyUI 生态系统,并希望将视频功能加入现有的图像工作流中。您希望获得商业使用权而无需支付使用费。您正在构建一个除了初始生成之外,还需要视频编辑、内画或指令引导修改的管线。
在以下情况跳过 WAN: 您需要一个免设置的 Web 工具,并且不习惯使用命令行环境。您正在制作多角色叙事内容,其中面部一致性至关重要。具有角色记忆系统的商业工具在这方面将优于 WAN 2.1-2.5。您的设备显存低于 6 GB(即使是 Wan2GP 也有最低门槛)。您希望获得 Wan 2.7 的 Thinking Mode 推理质量,但不愿支付 API 费用。如果您的首要任务是尽可能快的迭代速度,Pika 或 Runway 可以在几秒钟内生成片段,而不是几分钟,这对于快速创意草图非常重要。
2025 年 2 月 25 日发布的 Wan 2.1 是开源视频生成领域的一个真正转折点。它不仅缩小了与商业模型的差距;根据 VBench 的评分,它在发布时便领跑排行榜。Squish Effect LoRA(2025 年 3 月)是一个由社区训练的模型,能让任何物体产生逼真的物理变形效果,它成为了 2025 年初被分享最多的 AI 视频演示之一,并展示了微调生态系统在开源权重之上所能创造的潜力。这种社区的创造力——从 LoRA 包到 ComfyUI 工作流模板,再到 Wan2GP 显存优化器——是一个模型在开源领域具有持久生命力的最可靠标志。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 WAN (Wan-Video / Wan2GP) 的精选合集。
相关文章
与 WAN (Wan-Video / Wan2GP) 相关的指南和文章。

AI Video Generator Prompting: The Filmmaker's Real Workflow

Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI

AI Fashion Prompts That Stay Consistent: The Working Formula (2026)

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
Sell AI-Generated Short Films on TikTok Shop, Instagram & YouTube (2026)
