
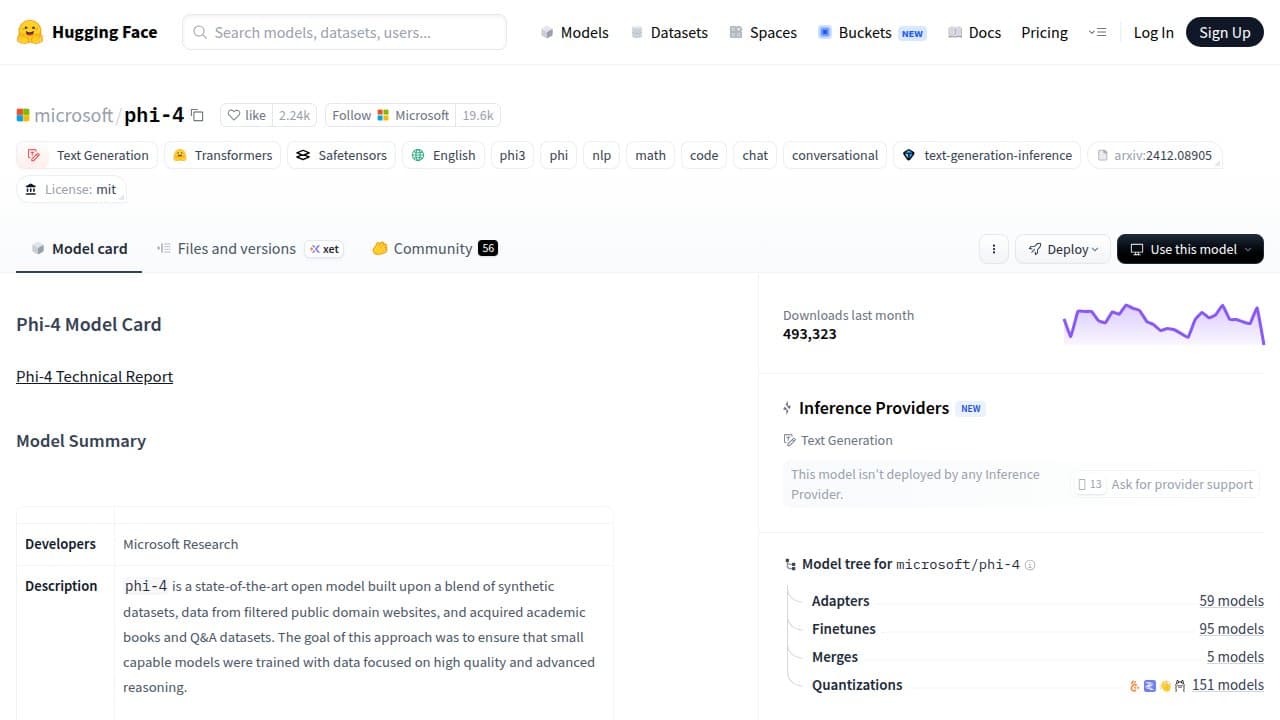
تثبت عائلة Phi من Microsoft أن جودة البيانات تتفوق على الحجم. يتفوق جيل Phi-4 (بـ 14B، وترخيص MIT) على أقرانه في الرياضيات والاستدلال، ويعمل على الأجهزة الاستهلاكية. متاح للتنزيل مجانًا، مع توفر استدلال مستضاف مدفوع على Azure AI Foundry.
عائلة Phi من Microsoft هي سلسلة من النماذج اللغوية الصغيرة المبنية على رهان أساسي واحد: أن بيانات التدريب الاصطناعية المنسقة بعناية يمكن أن تنتج نموذجًا يتفوق على المنافسين الذين يمتلكون معلمات أكثر بكثير. تم تطوير Phi بواسطة Microsoft Research وإصداره بموجب ترخيص MIT، وقد تطور من Phi-1 بحجم 1.3B في عام 2023 إلى جيل Phi-4، والذي يضم اعتبارًا من أوائل عام 2026 إصدارًا مصغرًا بحجم 3.8B، ونموذجًا متعدد الوسائط بحجم 5.6B، ونموذجًا رائدًا بحجم 14B، ونموذج استدلال ورؤية بحجم 15B تم إصداره في مارس 2026. جميع الأوزان متاحة مجانًا على Hugging Face تحت مؤسسة microsoft، وتحمل جميعها ترخيص MIT، مما يعني أن الاستخدام التجاري والضبط الدقيق وإعادة التوزيع غير مقيدة. غادر الباحث الرئيسي وراء رهانات Phi المبكرة، Sebastien Bubeck (نائب رئيس أبحاث الذكاء الاصطناعي التوليدي في Microsoft سابقًا)، إلى OpenAI في أكتوبر 2024، وسلم الراية إلى فريق واصل دفع العائلة إلى الأمام.
تمنح التشكيلة الحالية المطورين خيارات قيمة تناسب مختلف ميزانيات الأجهزة. يتعامل Phi-4 (14B) مع الرياضيات والاستدلال والتعليمات البرمجية على وحدة معالجة رسومات استهلاكية بذاكرة VRAM سعة 8GB عند تكميمه إلى 4-bit. يدعم Phi-4-mini (3.8B) نافذة سياق تبلغ 128K واستدعاء الوظائف، مما يجعله خيارًا حقيقيًا للنشر على الحافة. يعالج Phi-4-multimodal (5.6B) النصوص والصوت والصور، وتصدر قائمة HuggingFace OpenASR بمعدل خطأ في الكلمات بلغ 6.14% اعتبارًا من فبراير 2025. يستخدم كل من Phi-4-reasoning و Phi-4-reasoning-plus (كلاهما 14B) ضبطًا دقيقًا خاضعًا للإشراف على مسارات الاستدلال التي تم إنشاؤها بواسطة o3-mini، مع إضافة متغير plus للتعلم المعزز القائم على النتائج لسلاسل أطول وأكثر دقة. يوسع العضو الأحدث، Phi-4-reasoning-vision-15B (الصادر في 4 مارس 2026)، الاستدلال متعدد الوسائط ليشمل فهم واجهة المستخدم والمشكلات العلمية. جميعها قابلة للنشر عبر Ollama و Hugging Face Transformers و Azure AI Foundry و GitHub Models وبيئات التشغيل المتوافقة مع llama.cpp.
نظرة سريعة على Phi، أبريل 2026
يغطي جيل Phi-4 أربعة أهداف رئيسية للنشر:
Phi-4 (14B): بنية Transformer كثيفة بفك التشفير فقط. ترخيص MIT. سياق 16K. التقييمات: MMLU 84.8، GPQA 56.1، MATH 80.4، HumanEval 82.6. تم تدريبه على 9.8 تريليون رمز مميز بما في ذلك بيانات اصطناعية مكثفة للرياضيات والبرمجة والاستدلال. تم إطلاقه في 12 ديسمبر 2024 كمعاينة بحثية على Azure AI Foundry؛ وتم فتح أوزانه بموجب ترخيص MIT في يناير 2025.
Phi-4-mini (3.8B): انتباه الاستعلام المجمع، مفردات 200K، سياق 128K، استدعاء الوظائف. تم إصداره في 26 فبراير 2025. الخيار الأساسي لعمليات النشر على الحافة وإنترنت الأشياء.
Phi-4-multimodal (5.6B): إدخال النصوص والصوت والصور؛ إخراج النصوص. رائد في التعرف التلقائي على الكلام (ASR) (معدل خطأ في الكلمات 6.14%). تم إصداره في 26 فبراير 2025.
Phi-4-reasoning / Phi-4-reasoning-plus (14B): نماذج سلسلة الاستدلال المدربة على عروض o3-mini. تم إصدارها في أبريل/مايو 2025. تتفوق على DeepSeek-R1-Distill-Llama-70B في العديد من معايير الاستدلال.
Phi-4-reasoning-vision-15B: نموذج استدلال متعدد الوسائط بحجم 15B. ترخيص MIT. تم إصداره في 4 مارس 2026. يتعامل مع الرياضيات والعلوم وفهم واجهة المستخدم مع إدخال الرؤية.
استغرق تدريب Phi-4 مدة 21 يومًا على 1,920 وحدة معالجة رسومات H100-80G. حوالي 8% من بيانات التدريب متعددة اللغات؛ والباقي باللغة الإنجليزية بشكل أساسي. تاريخ قطع البيانات هو يونيو 2024 لنموذج Phi-4 الأساسي؛ وأغسطس 2024 لبعض المتغيرات اللاحقة.
بم يتميز Phi حقًا؟
تؤتي أطروحة البيانات الاصطناعية ثمارها بشكل واضح في المهام المنظمة. يسجل Phi-4 (14B) درجة 80.4 في معيار MATH و 82.6 في HumanEval، وهي أرقام تتفوق على نماذج تفوقه في الحجم بمرتين إلى خمس مرات. بالنسبة للمطورين الذين يقومون بتشغيل نماذج مكممة على أجهزة استهلاكية، يكمن الجاذب الأساسي هنا: نموذج يتناسب مع ذاكرة VRAM سعة 8GB ويتعامل مع مشكلات البرمجة والرياضيات الحقيقية بموثوقية.
"لقد حققت نجاحًا كبيرًا مع Phi-4 12B المكمم و Ollama حتى الآن. إنه بنفس سرعة Llama 3.1 8B ولكن النتائج كانت (بشكل شخصي) ذات جودة أعلى." - accrual، Hacker News، ديسمبر 2024
يعد ترخيص MIT ميزة تنافسية حقيقية. فبينما يحمل Gemma ترخيص Gemma License من Google (مع متطلبات إعداد التقارير على نطاق واسع) ويحمل Llama ترخيص Llama License من Meta (الاستخدام التجاري مسموح به ولكن مع شروط لعمليات النشر ذات الزيارات العالية)، فإن ترخيص MIT الخاص بـ Phi-4 هو الأبسط بين الثلاثة للفرق التي تدمج النماذج في المنتجات التجارية دون أعباء المراجعة القانونية.
يمكن القول إن Phi-4-mini هو النموذج الأكثر تقليلًا من شأنه في العائلة. مع 3.8B معلمة ونافذة سياق 128K واستدعاء موثوق للوظائف، فإنه يناسب حالة استخدام وكيل الحافة التي لا يستطيع نموذج Phi-4 الأساسي تلبيتها (سياق 16K يمثل حدًا صارمًا للمهام المليئة بالمستندات). نشرت Microsoft برنامجًا تعليميًا مخصصًا لبناء وكلاء الذكاء الاصطناعي على أجهزة إنترنت الأشياء باستخدام Phi-4-mini عبر Ollama، وكان استقبال المجتمع إيجابيًا لنمط النشر المحدد هذا.
"تبدو هذه النماذج مذهلة للغاية.. إصدارات Phi-4 تميزه باعتباره المنافس الوحيد تحت ~7B." - refulgentis، Hacker News، مايو 2025 (حول نماذج Phi-4-reasoning)
أين يتعثر Phi، وأنماط الفشل التي يواجهها المستخدمون باستمرار
تعد الفجوة بين درجات المعايير واتباع التعليمات في العالم الحقيقي هي المشكلة الأكثر استمرارًا في Phi. إنها تسبق Phi-4 ولم يتم حلها بالكامل. في اختبار موثق من يناير 2025، قام أحد المطورين بتشغيل Phi-4 عبر 30 لعبة شطرنج حيث كان على النموذج اتباع مطالبة مقيدة. سجل Phi-4 صفر انتصارات وصفر تعادلات، وكسر قواعد المطالبة بعد متوسط 7.7 حركة، وأنشأ رموزًا مميزة أكثر بست مرات تقريبًا من Gemma 2 9B، وارتكب أخطاء أكثر بعشر مرات. استنتج المطور: "انطباعي العام عن النماذج الصغيرة التي تتألق في التقييمات ليس جيدًا عند استخدامها في الحياة الواقعية." يمتد نمط الإسهاب هذا إلى نماذج الاستدلال أيضًا. اختبر Simon Willison نموذج Phi-4-reasoning في مايو 2025 ولاحظ أنه أنشأ 56 جملة من الاستدلال استجابةً لتحية "hi" بسيطة، وهو نمط وصفه بأنه "ميل إلى الإفراط في التفكير."
يعد سقف السياق البالغ 16K في نموذج Phi-4 الأساسي شكوى متكررة. يجسد موضوع نقاش على Hugging Face بعنوان "Limited Context Length - Yarn/Rope?" هذا الإحباط: في الوقت الذي تم فيه شحن Phi-4 بسياق 16K، كان كل من Llama 3.2 و Gemma 3 يقدمان 128K. قام Phi-4-mini لاحقًا بإصلاح ذلك بسياق 128K، لكن سياق النموذج الرائد يظل محدودًا مقارنة بالمنافسة. بالنسبة لأي مهمة تتضمن مستندات طويلة أو قواعد برمجية أو سياقًا متعدد الأدوار، يمثل هذا قيدًا صارمًا.
الاستخدام متعدد اللغات هو نقطة ضعف أخرى. مع حوالي 8% من بيانات التدريب متعددة اللغات، يضعف أداء Phi-4 في المطالبات بغير اللغة الإنجليزية. أبلغ المستخدمون الذين يحتاجون إلى الصينية أو العربية أو لغات أخرى عن حاجتهم إلى الضبط الدقيق أو التبديل إلى Gemma 3، الذي يغطي 140 لغة بشكل أصلي.
أخيرًا، رافق التشكيك في المعايير عائلة Phi منذ Phi-3. اقترح العديد من أعضاء المجتمع أن النماذج تظهر علامات على تلوث بيانات المعايير. عالجت Microsoft هذا الأمر بشكل مباشر في التقرير الفني لـ Phi-4، واصفة إجراءات محسنة لتنقية البيانات، لكن هذا التصور لا يزال قائمًا بين بعض المقيّمين. أشار أحد المعلقين على HN بوضوح في ديسمبر 2024: "تتمتع نماذج Phi دائمًا بدرجات معايير رائعة، لكنها تخيب أملي دائمًا في حالات الاستخدام الواقعية."
مقارنة بين Phi و Llama 3.2 و Gemma 3
Phi-4 (14B, MIT) هو بنية Transformer كثيفة بفك التشفير فقط تم تدريبه بشكل أساسي على بيانات إنجليزية اصطناعية. ميزته الأساسية هي أداء الرياضيات والاستدلال لكل معلمة. قيوده الأساسية هي سياق 16K في النموذج الأساسي والتدريب المحدود متعدد اللغات.
Llama 3.2 (Meta, Llama License) يتوفر بمتغيرات نصية فقط بحجم 1B و 3B ومتغيرات متعددة الوسائط بحجم 11B و 90B. الاختلاف الميكانيكي الرئيسي هو السياق: يدعم Llama 3.2 سياق 128K رمز مميز مقابل 16K في Phi-4. يستخدم Llama 3.2 انتباه الاستعلام المجمع (GQA) الذي يقلل ذاكرة التخزين المؤقت KV إلى 1/8 من البنى التقليدية. النظام البيئي اللاحق لا مثيل له: llama.cpp و vLLM و Ollama و TGI وكل بيئة تشغيل استدلال رئيسية تدعم Llama بشكل أصلي. في MMLU، يستقر Llama 3.2 3B عند حوالي 61.8% مقابل 84.8% لـ Phi-4 بحجم 14B، لكن Llama 3.3 70B يتفوق على Phi-4 في المهام العامة عندما لا تكون ميزانية المعلمات قيدًا.
Gemma 3 (Google DeepMind, Gemma License) مستخلص من بنية Gemini الخاصة بـ Google ويستخدم تصميمًا "رفيعًا وعميقًا" مقابل نهج "واسع وضحل" في Llama. يتوفر Gemma 3 بمتغيرات 1B و 4B و 12B و 27B، جميعها بسياق 128K. تتضمن متغيرات 4B+ إدخالًا أصليًا للصور، وهو ما يفتقر إليه Phi-4-mini تمامًا (فقط نموذج Phi-4-multimodal المنفصل يتعامل مع الرؤية). يغطي Gemma 3 حوالي 140 لغة مقابل مجموعة نصوص Phi-4 الإنجليزية بشكل أساسي. الترخيص ليس MIT: تتطلب شروط Gemma متطلبات إعداد التقارير لعمليات النشر التي تتجاوز 700M مستخدم نشط شهريًا (MAU) وتتضمن شروطًا إضافية غائبة عن MIT. بالنسبة لمعظم الفرق، لا تمثل هذه مشكلة، ولكن من أجل البساطة القانونية على نطاق واسع، يفوز ترخيص MIT الخاص بـ Phi-4.
الملخص العملي: إذا كان طول السياق مهمًا (RAG للمستندات، المحادثات الطويلة)، فاختر Llama 3.2 أو Gemma 3. إذا كان تعدد اللغات مهمًا، فاختر Gemma 3. إذا كانت نقاء ترخيص MIT مهمة وكان الهدف هو الرياضيات/الاستدلال على مساحة صغيرة، فإن Phi-4 هو الخيار الأقوى.
هل تستحق الفئة المدفوعة التكلفة؟
لا يوجد اشتراك مدفوع لـ Phi. النماذج مجانية للتنزيل والتشغيل. الاستدلال المستضاف على Azure AI Foundry يتم الدفع فيه لكل رمز مميز دون التزام بحد أدنى:
Phi-4-mini (مستضاف): $0.000075/1K رمز إدخال، $0.0003/1K رمز إخراج. الخيار الأقل تكلفة في العائلة.
Phi-4 (مستضاف): $0.000125/1K رمز إدخال، $0.0005/1K رمز إخراج.
Phi-4-multimodal (نص/صورة): $0.00008/1K إدخال، $0.00032/1K إخراج.
Phi-4-multimodal (صوت): $0.004/1K إدخال، $0.00032/1K إخراج.
الضبط الدقيق: $0.003/1K رمز تدريب. استضافة النماذج المضبوطة بدقة: $0.80/ساعة.
بالنسبة للفرق التي تستضيف النماذج ذاتيًا، التكلفة صفر باستثناء البنية التحتية. يعمل Phi-4 (14B) المكمم بـ 4-bit على وحدة معالجة رسومات استهلاكية واحدة بذاكرة VRAM سعة 8GB. بالنسبة للفرق التي تريد استدلالًا مُدارًا دون إدارة سعة وحدة معالجة الرسومات، فإن أسعار Azure لكل رمز مميز هي من بين الأدنى في السوق للنماذج في فئة القدرة هذه. القرار واضح: استضف ذاتيًا مجانًا إذا كان لديك الأجهزة والقدرة الهندسية؛ استخدم Azure للبساطة المُدارة بتكلفة منخفضة جدًا.
أفضل حالات الاستخدام (ومتى يجب تجاوزه)
يعد Phi مناسبًا تمامًا لـ:
عمليات نشر وكلاء الحافة وإنترنت الأشياء: تم تصميم Phi-4-mini بحجم 3.8B مع سياق 128K واستدعاء الوظائف لهذا الغرض. نشرت Microsoft برنامجًا تعليميًا مخصصًا لوكلاء الحافة المستندين إلى Ollama.
الرياضيات والاستدلال المنظم: معيار MATH البالغ 80.4 عند 14B هو الرقم الأبرز. بالنسبة لأنظمة التدريس، ومساعدي البرمجة مع الاستدلال الرياضي، والأسئلة والأجوبة العلمية باللغة الإنجليزية، يعد Phi-4 أقوى خيار للنماذج الصغيرة.
عمليات النشر التي تركز على الخصوصية أو المعزولة عن الشبكة: ترخيص MIT، لا توجد متطلبات للقياس عن بُعد، يعمل محليًا بالكامل. تمتلك الفرق في الصناعات الخاضعة للتنظيم (الرعاية الصحية، التمويل) التي لا يمكنها إرسال البيانات إلى واجهات برمجة التطبيقات السحابية مسارًا قابلاً للاستخدام هنا.
البحث والضبط الدقيق: منهجية التدريب الشفافة (الموثقة في التقارير الفنية لـ Microsoft Research) وترخيص MIT يجعلان من Phi نقطة انطلاق طبيعية لمشاريع الضبط الدقيق الأكاديمية والتجارية.
تجاوز Phi عندما:
تحتاج إلى معالجة مستندات طويلة أو قواعد برمجية أو محادثات متعددة الأدوار تتجاوز 16K رمز مميز في النموذج الأساسي (استخدم Gemma 3 أو Llama 3.2 بسياق 128K).
يكون المستخدمون أو المحتوى الخاص بك بغير اللغة الإنجليزية بشكل أساسي (تغطية Gemma 3 لـ 140 لغة أوسع بكثير).
تقوم ببناء مسار وكيل إنتاجي حيث يكون اتباع التعليمات الصارمة والموجزة أمرًا ضروريًا. يعد الإسهاب والفشل العرضي في الالتزام بالتعليمات الموثق من قبل مختبري المجتمع خطرًا حقيقيًا في حلقات الوكلاء المعقدة.
تريد أوسع دعم لمحرك الاستدلال وأكبر مجتمع من المشتقات المضبوطة بدقة (يفوز Llama هنا بهامش كبير).
البدء مع Phi
أسرع مسار هو Ollama: ollama pull phi4 للنموذج الأساسي 14B، أو ollama pull phi4-mini للمتغير 3.8B، وكلاهما متاح بدون حساب. بالنسبة لـ Hugging Face، تتضمن مستودعات microsoft/phi-4 و microsoft/Phi-4-mini-instruct بطاقات النماذج وأمثلة على مسارات transformers. تستخدم النماذج رموزًا مميزة بتنسيق ChatML. بالنسبة لـ Azure AI Foundry، ابحث عن أي متغير Phi-4 في كتالوج النماذج وانشره عبر استدلال مُدار بالدفع لكل رمز مميز دون الحاجة إلى توفير وحدة معالجة الرسومات.
تقييمات المستخدمين
لا توجد تقييمات بعد. كن أول من يشارك تجربته!
سجّل الدخول لكتابة تقييم.
ظهرت في مجموعات
قوائم منتقاة تتضمّن Phi.
مقالات ذات صلة
أدلة ومقالات ذات صلة بـ Phi.

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Run Open Source AI Models Locally: Battle-Tested Guide

Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI
