
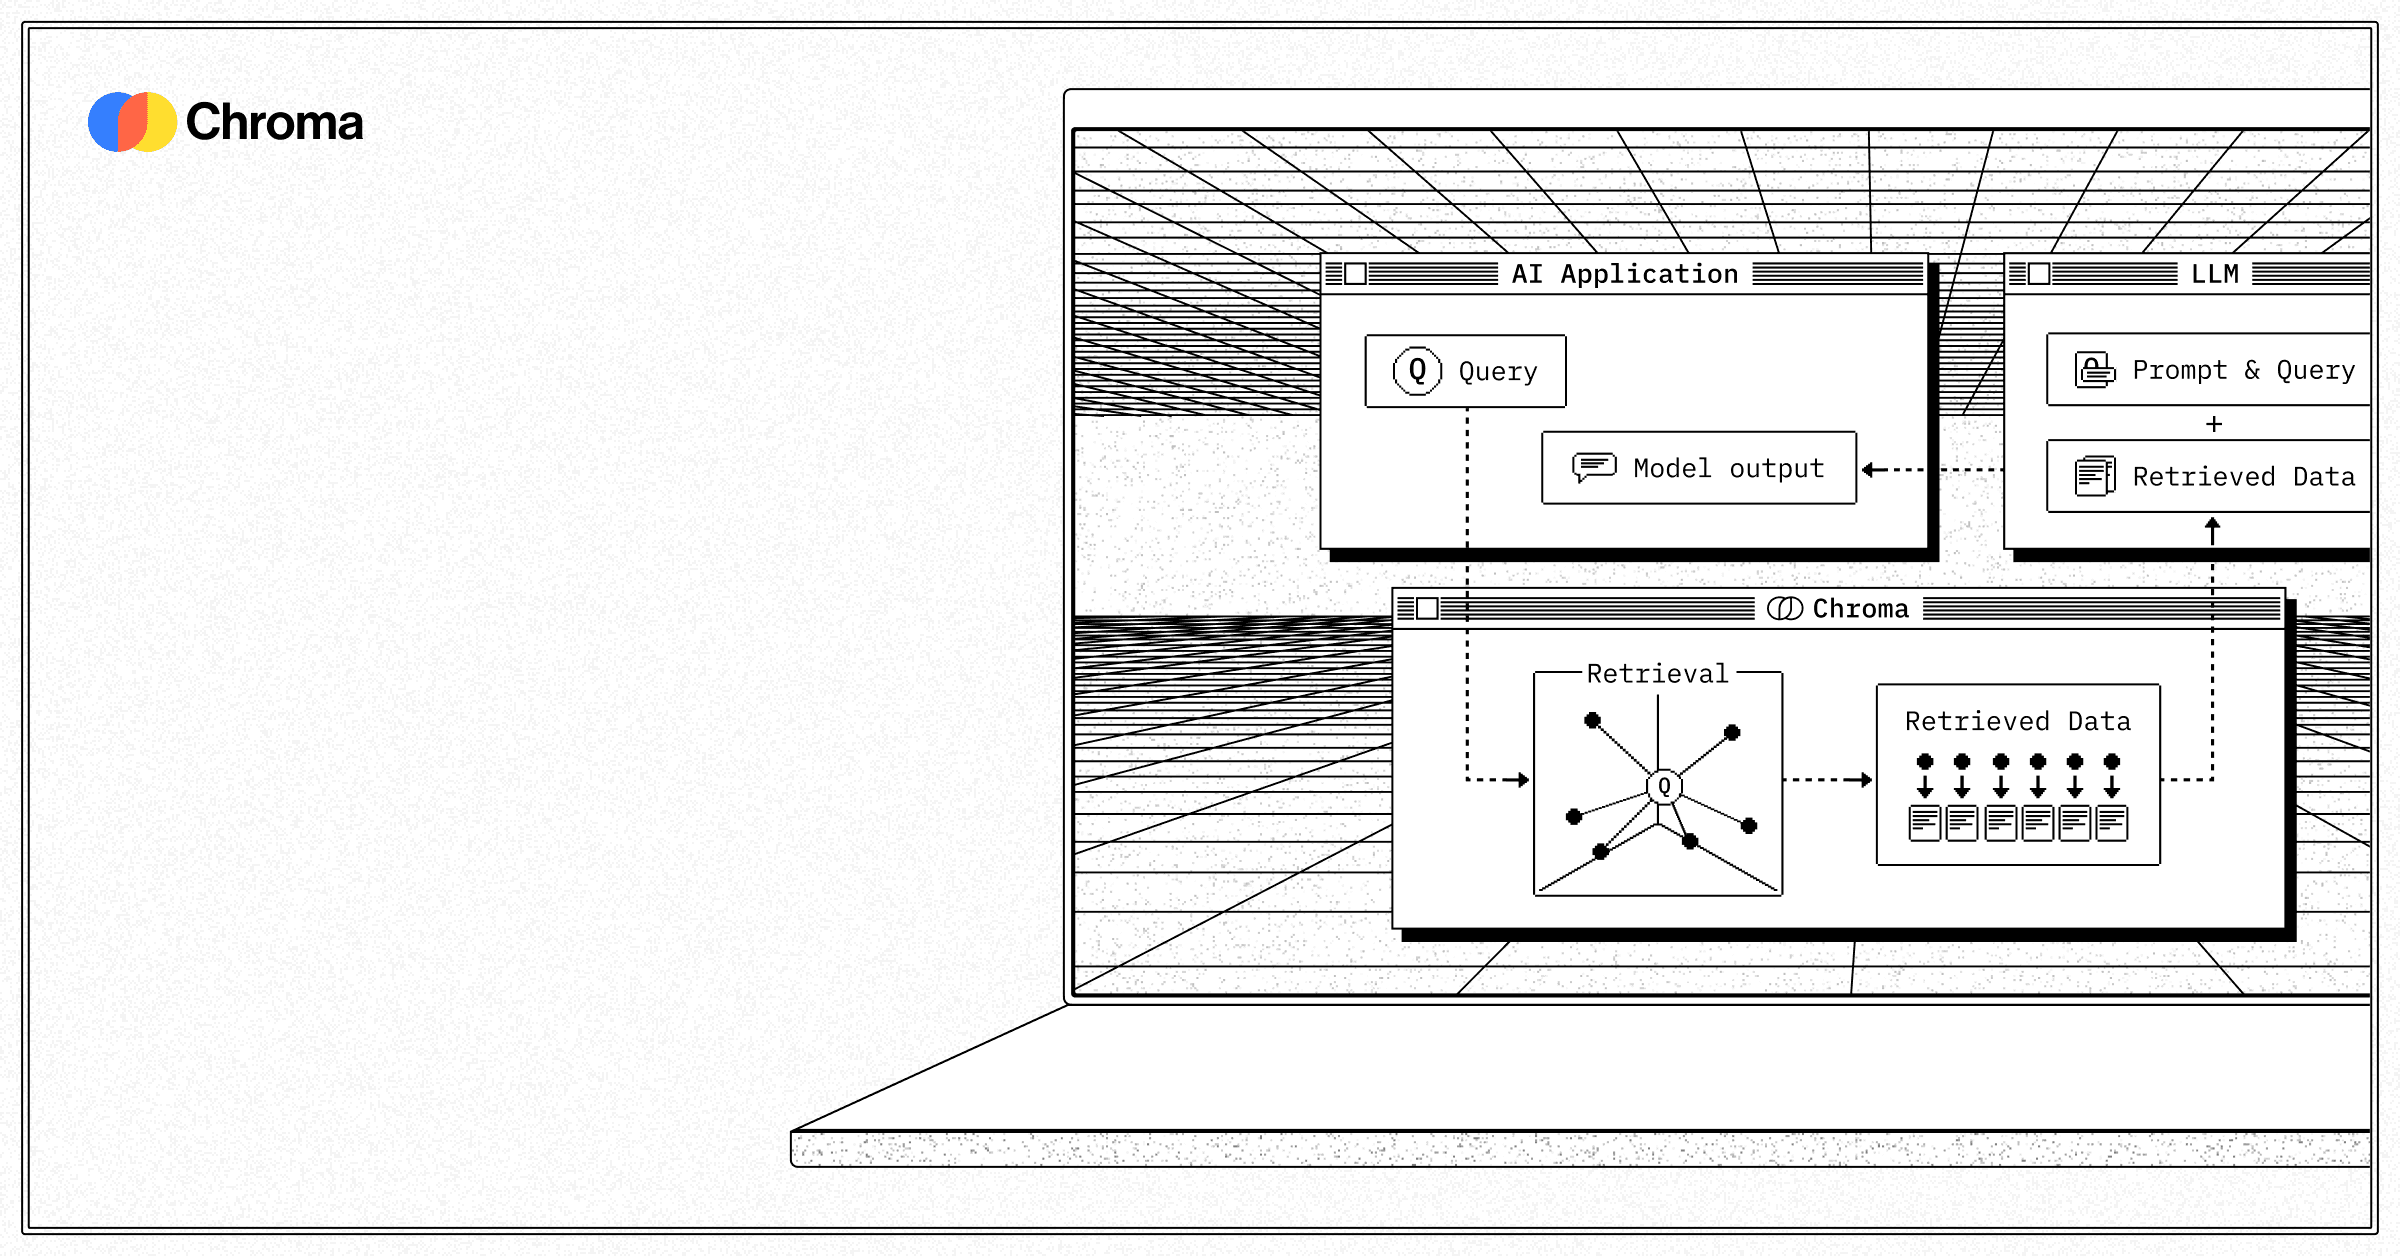
Chroma es la base de datos de embeddings de código abierto a la que los desarrolladores recurren primero al crear pipelines RAG. Con licencia Apache 2.0, se instala con una sola línea y es muy valorada por su API minimalista de cuatro funciones. La escala de producción es una limitación conocida que vale la pena entender antes de comprometerse.
Chroma es una base de datos de embeddings de código abierto creada para desarrolladores de aplicaciones de IA que necesitan almacenar y recuperar embeddings vectoriales sin sobrecarga de infraestructura. Fundada en San Francisco en abril de 2022 por Jeff Huber (CEO) y Anton Troynikov (CTO), la empresa recaudó una ronda semilla de $18M en abril de 2023 y ha creado una de las bases de datos vectoriales más citadas en la comunidad de desarrolladores, con 27.7k estrellas en GitHub hasta abril de 2026. El núcleo tiene licencia Apache 2.0, se instala con un simple pip install chromadb y no requiere un servidor independiente para ejecutarse en modo de desarrollo.
La API consta de cuatro operaciones principales: crear una colección, añadir embeddings, consultar y eliminar. Ese minimalismo deliberado cubre la mayoría de las necesidades de los prototipos RAG. Más allá de la API básica, Chroma admite la búsqueda de similitud de vectores densos, búsqueda de texto completo, recuperación de vectores dispersos (BM25 y SPLADE, añadidos en noviembre de 2025), filtrado de metadatos y búsqueda con expresiones regulares (regex). La reescritura del núcleo en Rust en 2025 ofreció escrituras y consultas de 3 a 5 veces más rápidas con verdadero multiprocesamiento (multithreading). Chroma Cloud, la versión alojada y gestionada, se lanzó con disponibilidad general en agosto de 2025 con precios serverless, cumplimiento SOC 2 Type II y organización de datos en niveles a través de caché en memoria, SSD y almacenamiento de objetos.
Lo que Chroma realmente hace en abril de 2026
Chroma se ejecuta en tres modos dependiendo de la fase en la que te encuentres en un proyecto. En el modo integrado (embedded), se ejecuta dentro de tu proceso de Python o JavaScript sin saltos de red y con cero configuración. En el modo cliente-servidor, chroma run inicia un servidor HTTP local al que puedes acceder desde cualquier lenguaje con un SDK oficial. Chroma Cloud ofrece la versión gestionada con escalado automático y $5 en créditos gratuitos en el plan Starter.
La versión actual (v1.5.8, 16 de abril de 2026) admite colecciones como unidad organizativa principal. Cada colección contiene embeddings junto con sus documentos de origen y metadatos arbitrarios. Las consultas pueden realizarse por vector de embedding, por texto del documento (auto-incrustado), por filtro de metadatos o cualquier combinación de estos. La incorporación de la búsqueda de vectores dispersos en noviembre de 2025 significa que la recuperación híbrida (denso + palabras clave) es ahora una función de primer nivel en lugar de una solución alternativa.
La reescritura del núcleo en Rust en 2025 fue el hito técnico más significativo de Chroma. La implementación original en Python estaba limitada por el Global Interpreter Lock, lo que bloqueaba el verdadero paralelismo. La reescritura en Rust eliminó ese cuello de botella y ofreció mejoras medidas de 3 a 5 veces para escrituras y consultas en 1M de embeddings de 1536 dimensiones de OpenAI. Se añadieron bindings nativos para JavaScript, Ruby y Swift, lo que significa que Chroma ya no es una herramienta exclusiva para Python. Las implementaciones en el navegador impulsadas por WASM también están disponibles a través de los bindings de JS.
Chroma Sync, añadido a finales de 2025, gestiona la ingesta automatizada desde repositorios de GitHub, buckets de S3 y páginas web: rastreo, fragmentación (chunking), creación de embeddings e indexación sin gestión manual de pipelines. Esto está dirigido a equipos que desean una capa de datos gestionada para RAG, no solo un backend de almacenamiento.
Dónde se sitúa Chroma frente a Qdrant y pgvector
Tres herramientas dominan las conversaciones de los desarrolladores sobre dónde colocar los embeddings: Chroma, Qdrant y pgvector. Ocupan posiciones significativamente diferentes.
Qdrant está escrito en Rust desde cero (no es una reescritura, es nativo desde el primer día) y fue diseñado específicamente para la búsqueda vectorial filtrada a escala de producción. Su indexación HNSW con filtrado de carga útil (payload) permite combinar la coincidencia de similitud y las restricciones de metadatos (rangos numéricos, coincidencias de texto, coordenadas geográficas) manteniendo tiempos de consulta inferiores a 5ms a escala. Qdrant admite la agrupación en clústeres de múltiples nodos distribuidos como una característica de primer nivel y maneja cargas de trabajo vectoriales a escala de miles de millones en producción. La reescritura en Rust de Chroma reduce la brecha de rendimiento bruto, pero la arquitectura distribuida de Qdrant es estructural. Una colección de Chroma es fundamentalmente de un solo nodo. Los clústeres de Qdrant no lo son.
pgvector es una extensión de PostgreSQL, no una base de datos independiente. Los vectores, documentos y datos de la aplicación comparten la misma tabla, la misma transacción y las mismas consultas SQL. Los equipos que ya ejecutan Postgres (la mayoría de los stacks de backend) añaden pgvector sin nuevas credenciales, pipelines de sincronización ni infraestructura que monitorizar. pgvector escala cómodamente a 5M de vectores en una instancia estándar de Postgres y proporciona garantías ACID por defecto. La contrapartida: pgvector no tiene modo integrado en memoria, requiere un servidor Postgres en ejecución incluso en desarrollo y carece de la API nativa de Python de Chroma para equipos que aún no dominan SQL.
El árbol de decisiones práctico al que llegan la mayoría de los equipos: usar Chroma para desarrollo local y prototipos, evaluar pgvector si su backend ya ejecuta Postgres, y pasar a Qdrant (o Weaviate, Pinecone) si necesitan distribución en producción o indexación a escala de miles de millones. El cookbook de la comunidad de Chroma tiene una guía literal de "Camino a Producción" que recomienda abiertamente considerar alternativas a escala, lo cual es inusualmente honesto para la propia documentación de un proveedor.
"ChromaDB es en general una opción decente si tienes un hardware potente y necesitas construir un prototipo rápidamente. Pero si planeas pasar a producción, tiene sentido cambiar a soluciones más maduras." - Olexander Hryhor, Arquitecto de Soluciones en AltexSoft, 2025
Cómo es el flujo de trabajo de desarrollo diario
El flujo de trabajo típico de Chroma comienza en una terminal. Instalar, importar, crear un cliente, crear una colección, añadir documentos con sus embeddings, consultar por texto. Un pipeline de recuperación RAG funcional se puede lograr en cinco a diez líneas de Python, a menudo en menos de quince minutos en una máquina nueva. No hay servidor que iniciar en modo integrado, ni clave de API que configurar, ni esquema que definir por adelantado.
Tanto LangChain como LlamaIndex tratan a Chroma como una integración de primer nivel. Configurar Chroma como un almacén de vectores en cualquiera de los frameworks requiere una sola línea de código. Esta es la razón por la que Chroma aparece en la mayoría de los tutoriales de RAG: la barrera para obtener una demostración funcional es más baja que cualquier alternativa.
Donde surge la fricción es en la transición al uso real. Pasar del modo integrado al modo cliente-servidor requiere ejecutar un proceso separado. Pasar a Chroma Cloud requiere actualizar la inicialización del cliente y gestionar las claves de API. Ninguno de los dos es complicado, pero ambos requieren un trabajo que sorprende a los desarrolladores que asumieron que "simplemente escalaría".
La experiencia de ingesta para grandes conjuntos de datos recibió críticas en el lanzamiento de Chroma Cloud en Hacker News en agosto de 2025. Un desarrollador informó que indexar 1.2M de documentos tomó días y fue frágil. El equipo reconoció esto y citó a Chroma Sync como la respuesta estructurada, pero los usuarios que necesiten cargar masivamente decenas de millones de documentos deberían probar el tiempo de ingesta antes de comprometerse con la plataforma.
"La razón principal por la que elegí ChromaDB fue que te permite jugar con los resultados. Te da más margen para trabajar en tu pipeline y experimentos." - Ismail Aslan, Ingeniero de Machine Learning en AltexSoft, 2025
Para quién está creado Chroma
Chroma está creado para desarrolladores en las etapas iniciales y medias de una aplicación de IA. Específicamente: ingenieros de ML que prototipan pipelines de recuperación y desean intercambiar modelos de embeddings sin rediseñar la infraestructura. Científicos de datos que construyen pruebas de concepto RAG para la revisión de las partes interesadas. Desarrolladores de aplicaciones que integran búsqueda semántica y no desean aprovisionar ni gestionar un servicio de base de datos independiente. Equipos en el ecosistema de LangChain o LlamaIndex que desean un backend local sin configuración.
Chroma Cloud amplía el objetivo a pequeñas implementaciones de producción con concurrencia moderada y colecciones de menos de unos pocos millones de vectores. El plan Team de $250/mes incluye cumplimiento SOC 2 y soporte por Slack, lo que cubre las necesidades de muchos productos SaaS en etapa inicial.
La comunidad describe a Chroma como "el SQLite del mundo vectorial", lo cual es preciso en ambos sentidos: rápido de adoptar, ampliamente utilizado en desarrollo, pero con límites documentados que envían el tráfico de producción serio a otros lugares.
Lo que Chroma no es
Chroma no es una base de datos distribuida. La versión de código abierto es de un solo nodo. No hay replicación integrada ni alta disponibilidad. Si la máquina que ejecuta Chroma se cae, el servicio se cae. Esto está bien para el desarrollo y es aceptable para pequeñas herramientas internas. Es una brecha significativa para los sistemas de producción que requieren un tiempo de actividad del 99.9%+.
Chroma no proporciona aislamiento multi-inquilino (multi-tenancy) en la versión de código abierto. Construir un producto SaaS donde los datos de diferentes clientes deben estar aislados requiere colecciones separadas por inquilino (manejable a pequeña escala, doloroso con cientos de inquilinos) o una arquitectura de base de datos diferente.
Chroma no admite la búsqueda vectorial acelerada por GPU. Toda la indexación y recuperación se basa en la CPU. Para cargas de trabajo de cientos de millones de vectores o que requieren latencia de sub-milisegundos con alta concurrencia, la búsqueda exclusiva por CPU se convierte en el cuello de botella.
Los equipos que priorizan Azure se enfrentan a fricciones adicionales: Chroma no tiene integración nativa con Azure. La implementación en Azure requiere contenedores Docker en lugar de soporte de servicio gestionado de primera mano. Los equipos profundamente invertidos en el ecosistema de Azure pueden encontrar que Azure AI Search o Cosmos DB son más fáciles de operar.
También vale la pena señalar el cronograma de lanzamiento de Chroma Cloud. Chroma Cloud se prometió para finales de 2023 y estuvo disponible de forma general en agosto de 2025, con aproximadamente dos años de retraso. El producto llegó con características sólidas, pero el retraso fue lo suficientemente largo como para que muchos desarrolladores que necesitaban alojamiento gestionado ya se hubieran mudado a Pinecone o Weaviate. Si el retraso afecta tu decisión depende de cuán central sea Chroma Cloud para tu arquitectura frente a la opción autoalojada.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen Chroma.
Artículos relacionados
Guías y artículos relacionados con Chroma.

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Coding Ate Enterprise AI (2026): The $4B Use Case, Anthropic’s Share, and Seat vs API Math

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
