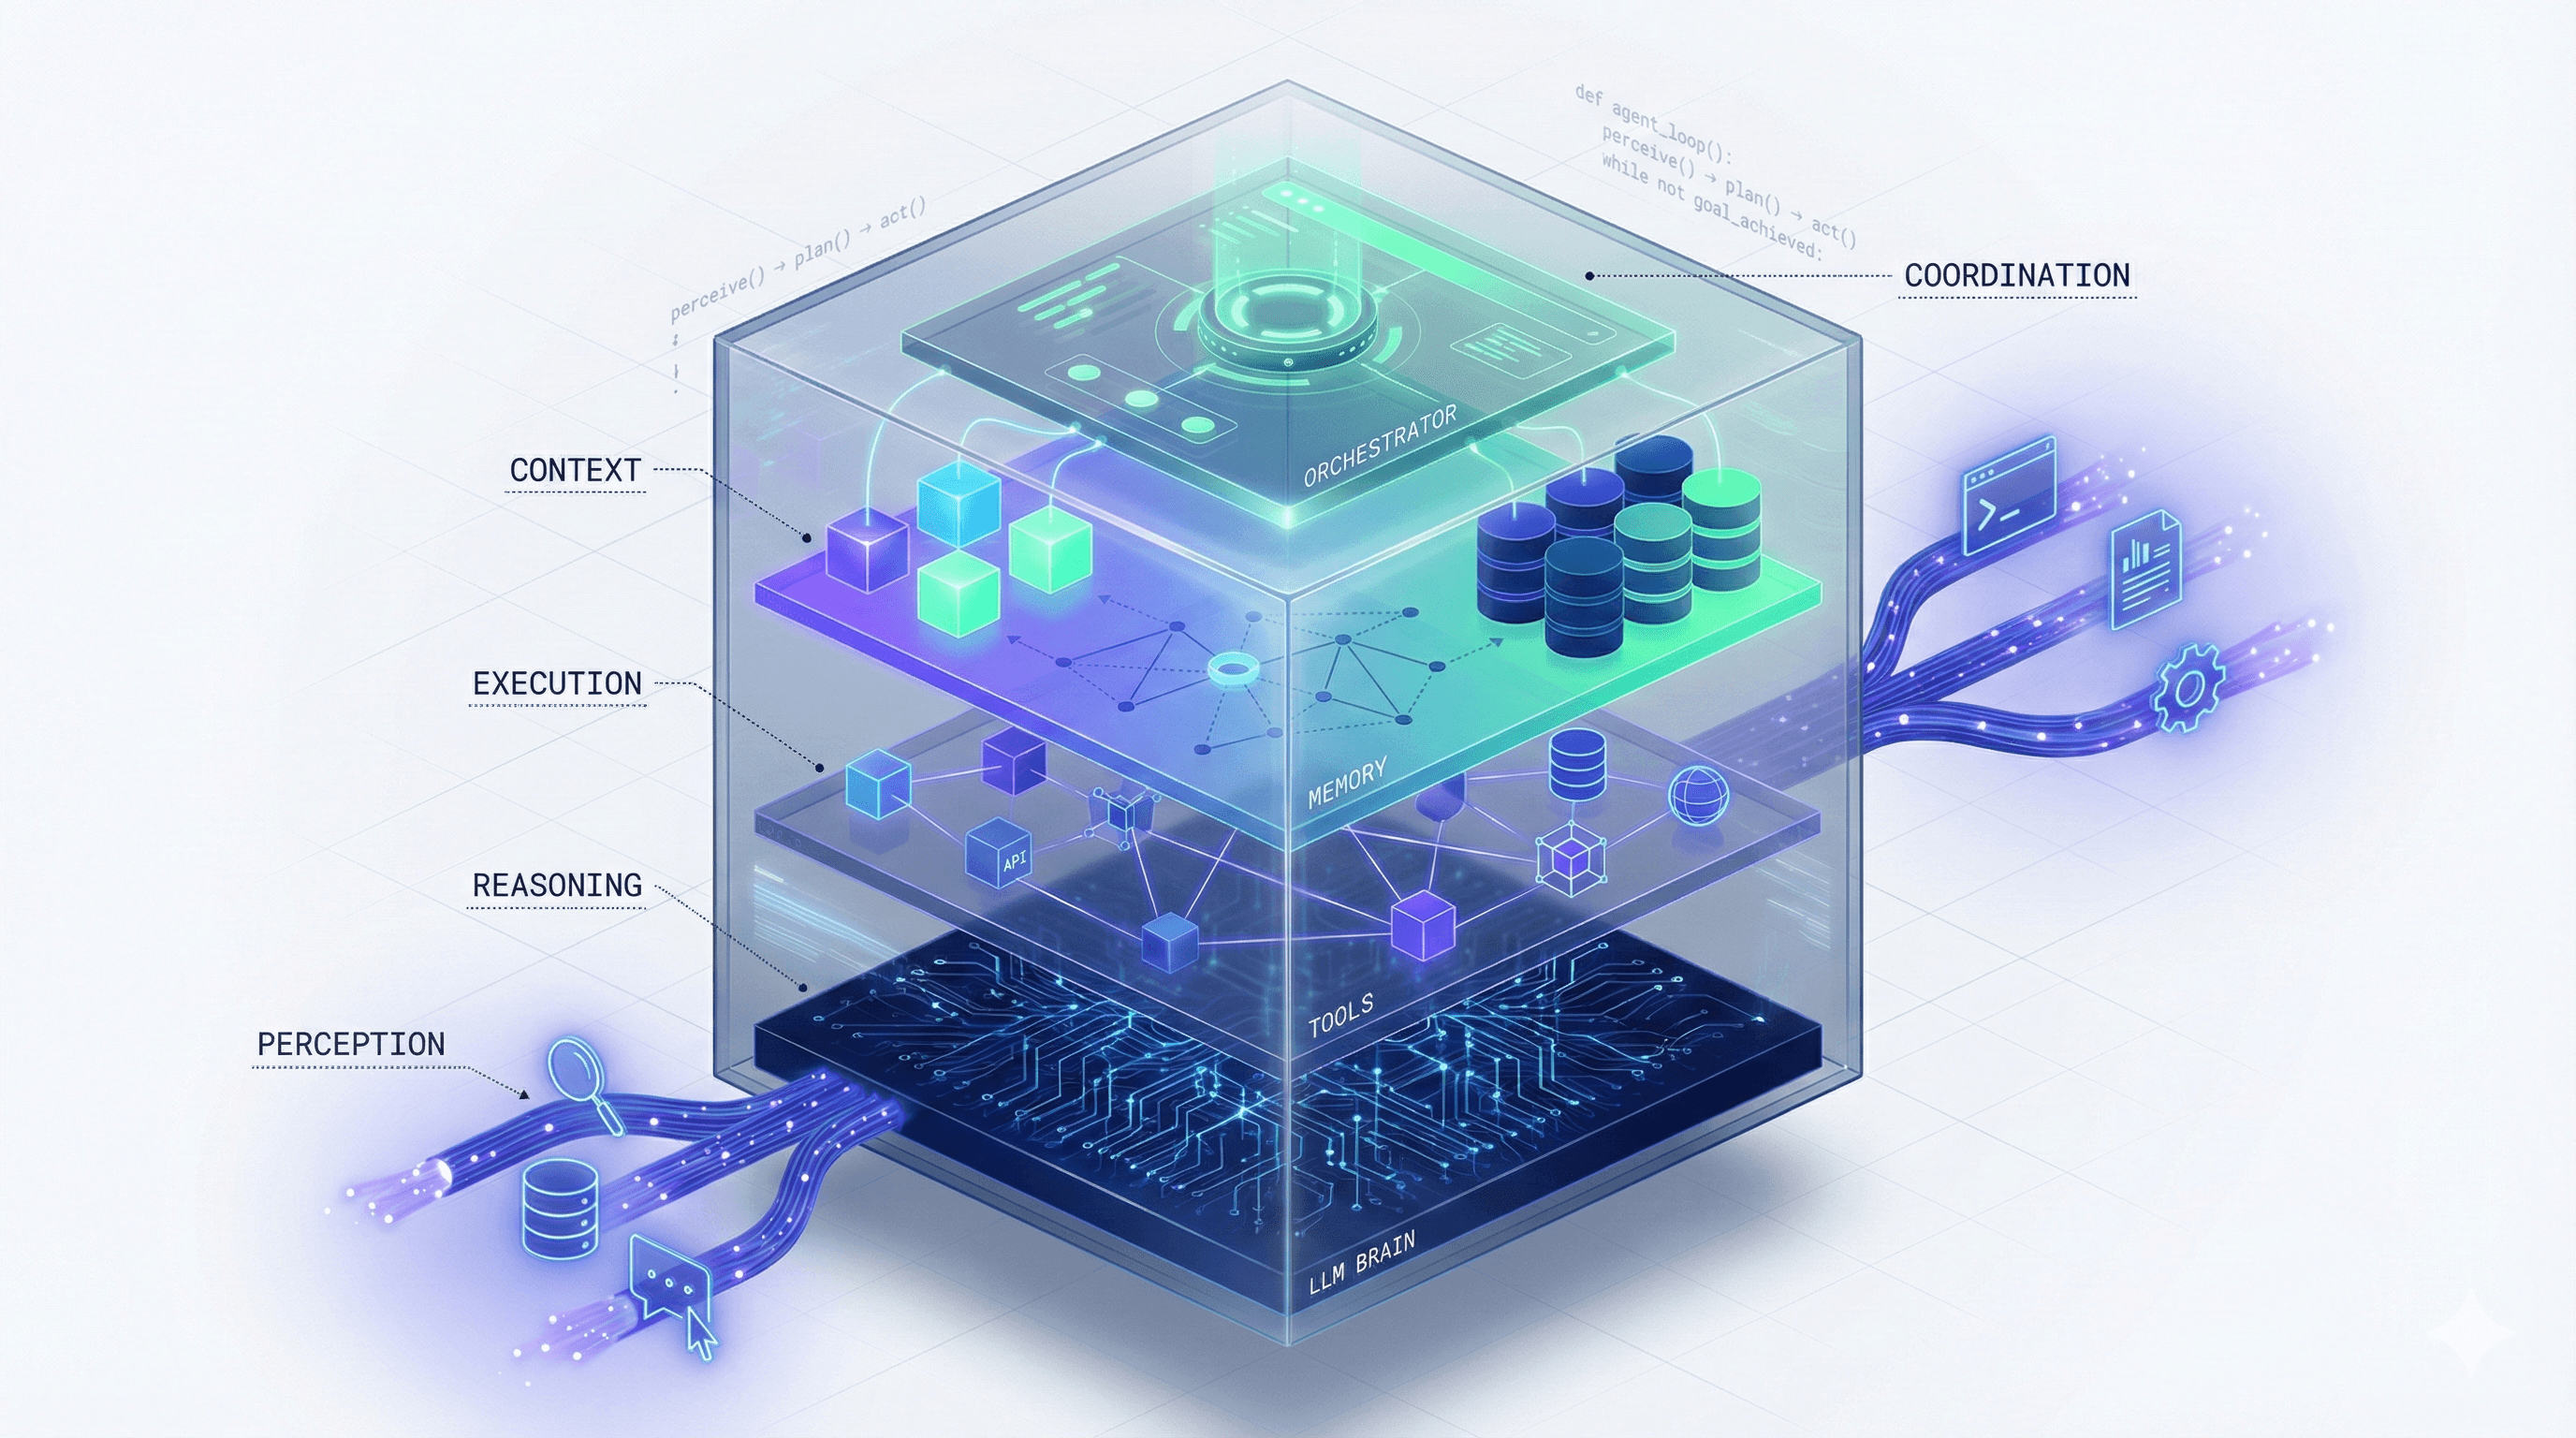

SWE-Agent est un agent d'ingénierie logicielle autonome et open source de Princeton University qui utilise une interface Agent-Computer Interface personnalisée pour résoudre des tickets GitHub, corriger des bugs et relever des défis de cybersécurité. Gratuit, sous licence MIT et agnostique en matière de modèles.
SWE-Agent est un agent d'ingénierie logicielle autonome conçu par des chercheurs de Princeton University et Stanford University. Lancé en 2024 et présenté à NeurIPS 2024, l'outil prend l'URL d'un ticket GitHub et tente d'écrire un correctif pour le résoudre, en utilisant le modèle de langage de votre choix. Le projet est maintenu par John Yang, Carlos Jimenez, Kilian Lieret et Ofir Press au sein du groupe Princeton NLP. Il est gratuit, sous licence MIT et s'exécute entièrement sur votre propre infrastructure.
L'idée fondatrice de l'agent est l'Agent-Computer Interface (ACI), une couche d'abstraction spécialement conçue qui remplace l'accès brut au shell par des commandes structurées, optimisées pour la façon dont les modèles de langage traitent l'information. La consultation, la recherche et l'édition de fichiers sont présentées comme des opérations concises et délimitées plutôt que comme des appels de terminal ouverts. Le même modèle GPT-4 obtient un score environ deux fois supérieur sur SWE-bench lorsqu'il est équipé des outils ACI par rapport à un accès bash brut, une découverte détaillée dans la publication de NeurIPS 2024. Au-delà de la résolution de tickets, SWE-Agent inclut le mode EnIGMA pour les tâches de cybersécurité offensive et prend en charge le traitement par lots, la configuration complète basée sur YAML et le runtime SWE-ReX pour l'exécution cloud parallélisée. La variante mini-SWE-agent du projet, d'environ 100 lignes de Python, obtient un score de plus de 74% sur SWE-bench Verified en utilisant un modèle de pointe moderne.
Ce que fait réellement SWE-Agent en mai 2026
Fondamentalement, SWE-Agent accepte l'URL d'un ticket GitHub et une clé API de modèle, puis exécute une boucle autonome qui lit le dépôt, reproduit le bug, modifie le code et teste le correctif. La boucle de l'agent est pilotée par l'ACI : chaque consultation de fichier est délimitée pour éviter le dépassement de contexte, les modifications passent par un linter qui annule automatiquement la syntaxe erronée, et l'état de l'agent (fichier actuel, position du curseur) est suivi par le runtime plutôt que déduit de l'historique de la conversation.
La version stable actuelle est la v1.1.0 (22 mai 2025), qui a introduit la génération de trajectoires SWE-smith et le modèle à poids ouverts SWE-agent-LM-32b. L'architecture prend en charge n'importe quel LLM via litellm, y compris OpenAI, Anthropic, Google et les modèles locaux. L'exécution parallèle est gérée par SWE-ReX, qui peut router les exécutions en bac à sable vers des backends Docker, AWS, Modal ou Fargate. Chaque exécution produit un fichier de trajectoire structuré adapté à la relecture pour la recherche, au fine-tuning ou à l'audit.
EnIGMA, introduit dans la v0.7.0 (septembre 2024), est un mode distinct pour les défis de cybersécurité de type capture-the-flag. Il ajoute des Interactive Agent Tools et un résumeur pour gérer les longues sorties de terminal des scripts d'exploitation, obtenant une amélioration de 3.3x par rapport aux agents précédents sur le benchmark NYU CTF. EnIGMA a été présenté dans une publication distincte à ICML 2025.
Le projet mini-SWE-agent, lancé mi-2025, adopte la philosophie inverse : tout réduire à un seul outil bash et à une simple boucle ReAct. Il atteint plus de 74% sur SWE-bench Verified en utilisant Gemini ou Claude, égalant les performances de l'agent complet avec 100x moins de code. Pour les nouveaux utilisateurs qui souhaitent des résultats sans configuration YAML, l'équipe de Princeton recommande désormais de commencer par mini-SWE-agent plutôt que par le framework complet.
"L'idée selon laquelle bash est tout ce dont un LLM moderne a besoin pour résoudre des tâches de codage est très gratifiante. Très instructif et inspirant pour commencer à bidouiller." - scottyeager, Hacker News, juillet 2025
Où se situe SWE-Agent par rapport à OpenHands et Aider
Trois agents de codage open source dominent les classements de recherche : SWE-Agent, OpenHands et Aider. Ils partagent une mission commune mais diffèrent mécaniquement dans presque toutes les dimensions.
SWE-Agent vs OpenHands : OpenHands s'exécute dans des conteneurs Docker avec une architecture de flux d'événements : l'agent produit des actions, l'environnement les exécute et renvoie des observations, et la boucle continue. Chaque session bénéficie d'un accès SSH, d'un noyau Jupyter pour l'exécution Python et d'une interface BrowserGym pour l'automatisation web. La délégation multi-agents est native : un agent parent peut créer des sous-agents pour des sous-tâches spécifiques et intégrer leurs résultats. OpenHands propose également une interface web soignée et une extension VSCode. SWE-Agent n'a rien de tout cela. Il fonctionne uniquement en CLI, n'a pas d'interface web et son support multi-agents est expérimental. Ce que SWE-Agent possède et qui manque à OpenHands, c'est le mode de cybersécurité d'EnIGMA, une surface de configuration YAML plus approfondie pour les chercheurs et le moteur d'exécution parallèle SWE-ReX. OpenHands convient aux équipes qui souhaitent un développeur autonome polyvalent. SWE-Agent convient aux chercheurs et aux développeurs qui souhaitent contrôler chaque partie de la boucle de l'agent.
SWE-Agent vs Aider : Aider est orienté git : chaque modification devient un commit nommé et auto-validé dans l'historique de votre dépôt. Aider s'exécute de manière interactive depuis le terminal, excelle dans les échanges collaboratifs avec un développeur et utilise environ 4.2x moins de tokens par tâche car il reste superficiel sur le contexte du dépôt. SWE-Agent s'exécute de manière non interactive en mode autonome, génère des trajectoires structurées et a un plafond SWE-bench beaucoup plus élevé car l'ACI permet une exploration plus approfondie du dépôt. Aider est préférable pour les sessions de codage itératives en binôme. SWE-Agent est préférable pour la résolution de tickets entièrement automatisée et asynchrone, sans développeur dans la boucle. Aucun des deux n'a de mode de cybersécurité ; cela reste exclusif à la variante EnIGMA de SWE-Agent.
Dans un contexte commercial, SWE-Agent et OpenHands sont tous deux nettement moins chers que Devin (gratuit contre facturation par ACU) tout en l'égalant ou en le dépassant sur les performances des benchmarks. Cursor et Cline occupent une niche différente, celle de la complétion et du chat intégrés à l'IDE plutôt que de la résolution autonome de tickets, ils complètent donc SWE-Agent plutôt que de le concurrencer directement.
"SWE-bench ne teste la résolution de tickets que dans des dépôts Python, ce qui limite sa valeur prédictive pour des scénarios réels impliquant d'autres langages et types de tâches." - ToolHalla AI, analyse comparative, 2026
À quoi ressemble la réalité de la boucle de l'agent
L'exécution de SWE-Agent suit un modèle cohérent. Vous l'installez via pip install sweagent, définissez votre clé API LLM dans les variables d'environnement et invoquez la CLI avec l'URL d'un ticket GitHub et le modèle de votre choix. L'agent clone le dépôt dans un bac à sable, lit le ticket, explore les fichiers pertinents via des commandes ACI, effectue des modifications ciblées et tente d'exécuter la suite de tests. L'exécution produit un fichier de correctif (patch) et un journal de trajectoire.
La conception de l'ACI est ce qui sépare une exécution réussie d'un échec. Sur les dépôts avec des tickets clairs et bien spécifiés et une couverture de tests Python, l'agent résout une fraction significative des problèmes sans intervention humaine. Sur des tickets ambigus ("ça a planté sur ma machine"), l'agent échoue proprement ou produit un correctif plausible mais incomplet. Le benchmark SWE-bench-Live, qui teste des tickets véritablement nouveaux sans contamination du jeu de données, montre SWE-Agent et OpenHands à environ 18-20%, un écart qui donne à réfléchir par rapport aux chiffres de plus de 70% sur les benchmarks sélectionnés. L'utilisation réelle en production nécessite un examen humain de chaque correctif proposé.
La version 1.0 de SWE-Agent de février 2025 a introduit SWE-ReX, qui a rendu l'évaluation parallèle pratique. Les chercheurs peuvent désormais exécuter des centaines de tentatives de résolution de tickets simultanément sur des backends Modal ou AWS. Pour les équipes évaluant la qualité des agents à grande échelle, cela élimine le goulot d'étranglement du temps d'exécution qui rendait l'exécution séquentielle d'origine peu pratique pour les grands backlogs.
Le coût des tokens est une incertitude récurrente. SWE-Agent n'affiche pas d'estimations de coût par exécution avant le lancement. Le coût dépend entièrement du choix du modèle, de la complexité du ticket et du nombre de tours ACI effectués par l'agent. Les utilisateurs expérimentés signalent une moyenne de plusieurs centaines de milliers de tokens par ticket complexe en utilisant Claude ou GPT-4o, ce qui se traduit par $1-5 par ticket aux tarifs API actuels. Pour le traitement par lots, l'équipe recommande les API batch au niveau du fournisseur pour réduire les coûts de 50%.
La mise à niveau v1.0 a également introduit des changements majeurs qui ont pris certains utilisateurs au dépourvu. Le champ messages dans les données de trajectoire a été renommé en query, les bundles d'outils ont été renommés et la structure des sous-commandes CLI a considérablement changé. Les équipes exécutant SWE-Agent dans le cadre de pipelines d'évaluation ont dû mettre à jour leurs outils. L'équipe a documenté les changements dans les notes de migration, mais ce remaniement a représenté un coût réel pour quiconque ne suivait pas le dépôt de près. La discipline en matière de versions est plus importante avec SWE-Agent qu'avec la plupart des outils open source, car le rythme de recherche est rapide et l'équipe privilégie l'amélioration des benchmarks à la stabilité de l'API.
À qui s'adresse SWE-Agent
SWE-Agent a d'abord été conçu pour les chercheurs. Le système de configuration YAML, la journalisation des trajectoires, la prise en charge de bundles d'outils personnalisés et son héritage de publications académiques pointent tous vers un outil qui s'attend à ce que ses utilisateurs lisent la documentation et modifient le code source. Les 19,100 étoiles GitHub et les citations d'IBM, NVIDIA, Meta, Nebius et Anyscale reflètent ce public. Il est largement adopté dans les laboratoires de recherche en ML comme la référence à battre pour les nouvelles conceptions d'agents.
Au-delà de la recherche, SWE-Agent convient aux développeurs solos et aux petites équipes qui souhaitent un tri autonome des tickets. Le flux de travail est le suivant : fournir à l'agent un backlog de tickets GitHub étiquetés, examiner les correctifs qu'il génère, fusionner ceux qui passent l'intégration continue (CI). Ce n'est pas une solution clé en main, cela nécessite une familiarité avec votre suite de tests et un examen minutieux, mais c'est un véritable flux de travail qui, selon les équipes, permet d'économiser des heures par semaine sur des corrections de bugs bien spécifiées.
EnIGMA ouvre un segment d'utilisateurs distinct : les chercheurs en sécurité et les compétiteurs de CTF. L'amélioration de 3.3x sur les défis NYU CTF et les résultats CyBench en font l'un des outils de test d'intrusion automatisés gratuits les plus performants. Les équipes de sécurité des universités et des entreprises axées sur la recherche en sont les principaux adeptes.
Ce que SWE-Agent n'est pas
SWE-Agent n'est pas un produit pour les utilisateurs non techniques. Il n'y a pas d'interface web hébergée, pas d'installation en un clic pour les non-développeurs, et pas de support client au-delà des tickets GitHub et de la communauté Discord. Si vos critères d'évaluation incluent une interface soignée, tournez-vous plutôt vers OpenHands.
Ce n'est pas un assistant de codage persistant. Contrairement au mode interactif d'Aider ou aux outils basés sur un IDE comme Cursor, SWE-Agent n'a pas de mémoire entre les exécutions. L'agent repart de zéro à chaque invocation. Les utilisateurs qui s'attendent à ce qu'il accumule des connaissances sur leur base de code au fil des sessions seront déçus. Des solutions de contournement existent (fournir le contexte du projet dans la configuration YAML), mais elles sont manuelles.
Ce n'est pas un substitut au jugement du développeur sur la qualité des correctifs. Les performances de SWE-bench Verified approchant les 80% sont impressionnantes, mais ces benchmarks sont sélectionnés. Les dépôts du monde réel avec une couverture de tests partielle, des spécifications ambiguës et des dépendances inter-langages font considérablement chuter les performances. Chaque correctif de SWE-Agent qui part en production doit passer votre pipeline CI et faire l'objet d'une revue de code humaine.
Ce n'est pas un produit commercial avec des SLA de fournisseur, un support d'entreprise ou des certifications de conformité. Pour les équipes qui ont besoin d'une disponibilité garantie, de pistes d'audit ou d'une intégration SSO, le niveau entreprise de Devin ou une alternative gérée est plus approprié.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant SWE-Agent.
Articles associés
Guides et articles en lien avec SWE-Agent.

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
SWE-bench Pro Explained: Why the Benchmark Changed (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC