LlamaIndex 是由 LlamaIndex, Inc. 开发的开源数据框架,用于在私有数据上构建 RAG 应用程序。它包含 300 多个数据连接器、内置的分层分块(hierarchical chunking)功能,以及用于企业级文档解析的 LlamaParse。开源核心免费;LlamaCloud 起价为 $50/mo。
LlamaIndex 是由 LlamaIndex, Inc. 构建的开源数据框架,专为将私有数据源连接到大型语言模型的开发者而设计。该项目最初由 Jerry Liu 和 Simon Liu 于 2022 年底以 GPT Index 的名称发布,截至 2026 年 4 月,已在 GitHub 上获得了近 49,000 颗星,每月包下载量达到 2500 万次。核心库采用 MIT 许可证,可免费用于商业用途。该公司的商业层 LlamaCloud 在开源框架之上增加了托管解析、提取和索引服务,其中 LlamaParse 是其用于文档理解的旗舰付费产品。
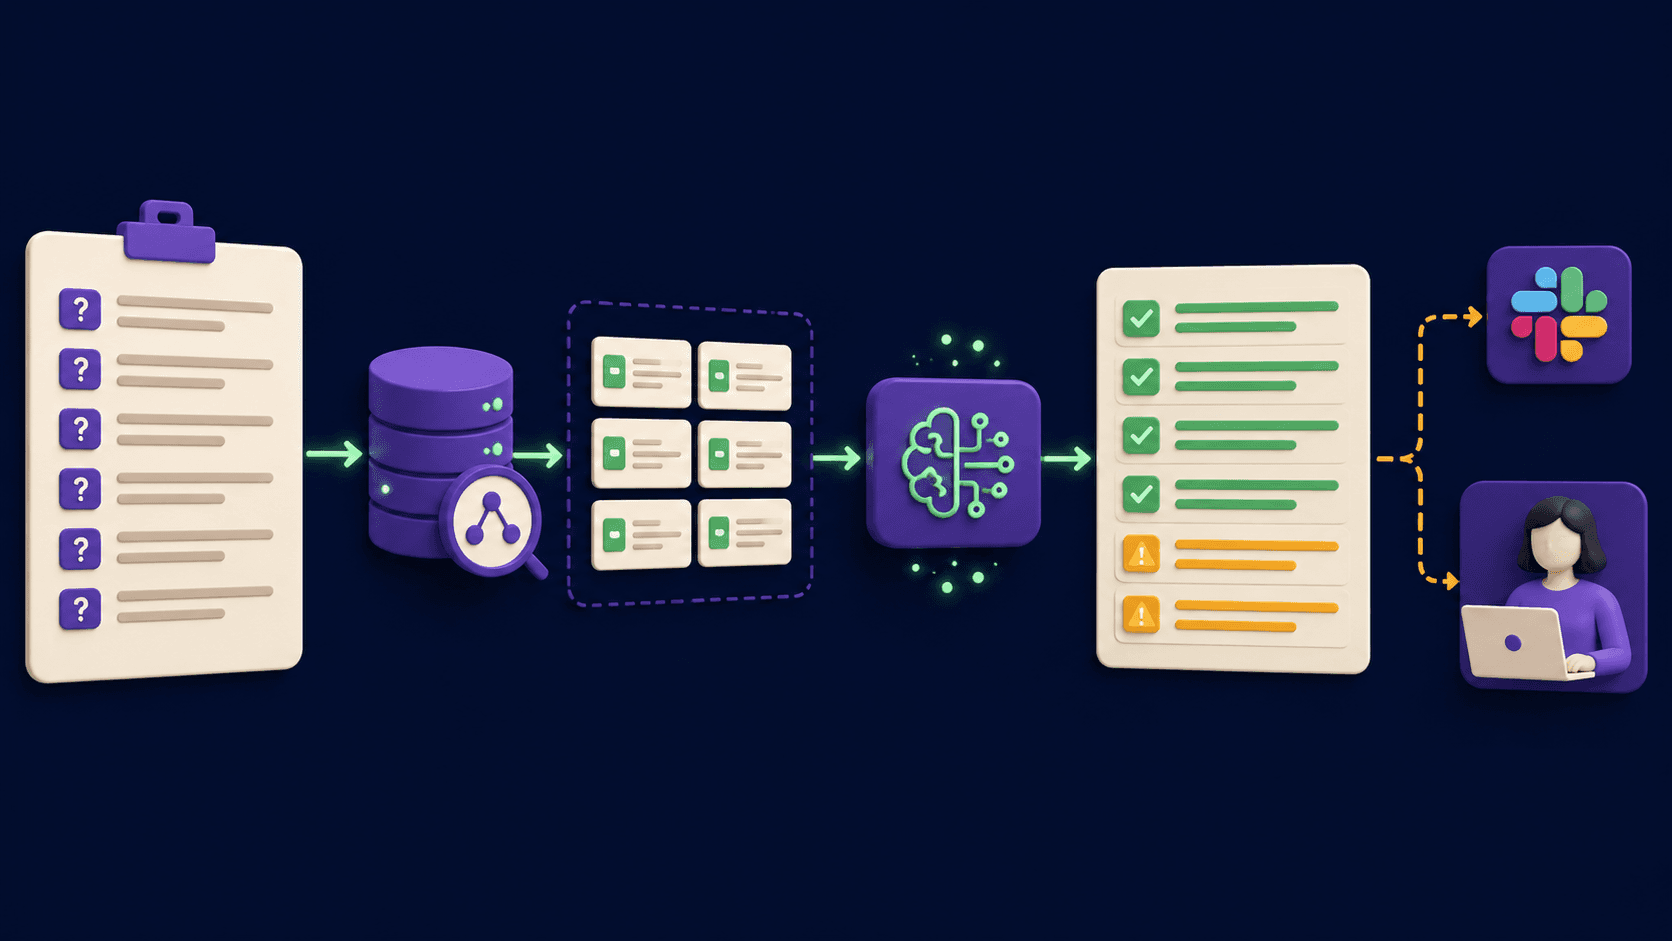
该框架围绕五个抽象层进行组织:数据连接器(通过 LlamaHub 支持 300 多个数据源)、用于分块策略的节点解析器(node parsers)、索引(向量、摘要、关键字、知识图谱)、用于检索到响应管道的查询引擎,以及用于异步代理编排的 Workflows。内置功能包括分层分块、结合向量相似度与 BM25 关键字匹配的混合搜索、针对多文档查询的子问题分解,以及一个内置的 RAG 评估器(无需独立的观测平台即可衡量忠实度和相关性)。LlamaParse 能够处理复杂的文档布局,包括嵌套表格、多列 PDF、图表和手写笔记,它使用由 VLM 驱动的代理将内容路由到专门的解析模型。
LlamaIndex 在 2026 年 4 月的实际功能
该框架已经大幅扩展,超越了其最初的 RAG 管道定位。当前版本(v0.14.21,2026 年 4 月 21 日)包含了 Workflows,这是一个基于事件传递而非有向图构建的完整异步代理编排系统。于 2025 年推出的 LlamaAgents 支持一键部署文档处理代理,并提供用于发票处理、合同审查和索赔处理的现成模板,所有这些都构建在 Workflows 库之上。
2025 年 12 月 18 日发布的 LlamaParse v2 将解析重组为四个层级:Fast(每页 1 个积分,以文本为主的文档)、Cost-effective(每页 3 个积分,通用)、Agentic(每页 10 个积分,包含混合内容的复杂布局)和 Agentic Plus(每页 45 个积分,最高精度)。v2 版本将 Agentic Plus 的成本降低了 50%,并增加了版本锁定(version pinning)功能,以便生产管道锁定特定的解析行为,不会因自动更新而中断。2025 年发布的其他工具包括 LlamaSheets(将电子表格转换为 AI 就绪数据)、LlamaSplit(从捆绑文件中自动分离文档)以及 LlamaExtract Table Row Mode(用于从结构化文档中提取重复实体)。
在 2025 年 3 月宣布 A 轮融资后,LlamaCloud 获得了 SOC 2 Type 2 认证,并符合 GDPR/HIPAA 标准。它可作为 SaaS 或本地(VPC)部署。在全面可用(GA)阶段披露的客户包括 Rakuten、Carlyle、Salesforce 和 KPMG。该公司报告称已处理 10 亿份文档,并拥有 300,000 名 LlamaParse 用户。
LlamaIndex 与 LangChain 和 Haystack 的对比
LlamaIndex vs. LangChain: 两者的架构在基本工作单元上存在分歧。LlamaIndex 将检索视为主要抽象:数据连接器、分块策略、索引和查询引擎都是一等对象。LangChain 将代理视为主要抽象,而检索只是其中一个组件,需要与文本拆分器、向量存储、检索器和重排器手动连接。实际结果是,在 LangChain 中构建基础 RAG 管道所需的代码比在 LlamaIndex 中多约 30-40%,并且 LangChain 中相当于 LlamaIndex 分层分块的功能需要手动组装组件。在生产基准测试中,LlamaIndex 每次查询的框架开销约为 6ms 和 1.6K token;而 LangGraph 约为 14ms 和 2.4K token。然而,LangChain 在社区规模、教程和职位发布方面占据主导地位,并且 LangSmith 提供了 LlamaIndex 原生缺乏的第一方可观测性(它依赖于 Langfuse 或 Phoenix 等第三方工具)。许多生产团队最终会同时使用两者:LlamaIndex 作为检索层,LangGraph 作为编排层。
LlamaIndex vs. Haystack: Haystack(由 deepset 开发)使用显式的模块化管道模型,其中预处理被分解为命名组件:转换器、清理器、拆分器、检索器和重排器,每个组件都是代码中可见的管道阶段。这使得复杂的文档处理工作流在企业环境中更容易审计和维护。Haystack 还提供了一个可视化管道构建器(Haystack Studio),而 LlamaIndex 没有同类工具。权衡之处在于:LlamaParse 是一项专有的、由 VLM 驱动的文档解析服务,在处理复杂布局、表格和图表方面优于 Haystack 的开源组件栈(Apache Tika、Unstructured.io)。对于简单的文档搜索管道,Haystack 的显式管道模型在清晰度上胜出;而对于文档解析质量是瓶颈的应用程序,LlamaIndex 的数据优先方法和 LlamaParse 的准确性则是其差异化优势。在基准测试中,两者的框架开销几乎相同(Haystack 约 5.9ms/1.57K token;LlamaIndex 约 6ms/1.6K token)。
RAG 管道的日常实际体验
对于刚开始使用 LlamaIndex 的开发者来说,前 30 分钟的体验确实非常快。安装核心包、将 SimpleDirectoryReader 指向一个 PDF 文件夹、创建一个 VectorStoreIndex 并运行查询引擎,只需不到 20 行 Python 代码。第一个演示就能顺利运行。但当从演示走向生产环境时,摩擦便开始了。
2024 年 2 月的 v0.10 迁移是 LlamaIndex 历史上最具破坏性的时刻。团队将单一的 llama-index 包拆分为 llama-index-core 加上数百个单独版本化的集成包,弃用了 ServiceContext(一个广泛使用的配置对象),并重写了分块抽象。Notebook、教程和社区代码都在 ImportError 处崩溃。GitHub issue #10747(“破坏性更改使得难以使用 llama_index”)变成了一个充满沮丧开发者的长帖。虽然迁移工具提供了一些帮助,但日程紧迫的团队还是耗费了大量的实际调试时间。
“我可能再也不会用它了,因为它不稳定,接口不断变化,文档经常过时,而且抽象过于复杂。文档已经完全更改了 3 次。这太令人气愤了。”——匿名开发者,GitHub Issues #10747,2024
自 v0.10 以来,稳定性有所提高。当前的 v0.14 分支没有引发类似的抱怨。但文档滞后的问题依然存在:发布节奏快,示例老化迅速,遵循三个月前教程的初学者经常会遇到错误,需要交叉参考更新日志或 Discord。一旦开发者对核心抽象有足够的理解,能够在出现问题时阅读源代码,使用 LlamaIndex 就会变得舒适得多。
LlamaParse 是这款商业产品确立其地位的地方。对于干净、格式良好的 PDF(包括法律合同、财务文件和技术文档),其准确性非常高。在 2025 年 2 月的 Hacker News 帖子中,社区的反响是积极的:
“在质量比数量更重要的地方,我怀疑没有多少工具能接近 Llamaparse。”——BenGosub,Hacker News,2025 年 2 月 7 日
同一帖子中指出的注意事项是:LlamaParse 登陆页面上的演示使用的是干净的数字渲染文件。在低质量扫描件、收据照片和手写文档上的实际性能则存在较大差异,该公司也承认,处理“不仅仅是表格的长尾问题”(包括字体、页眉、图表和表单字段)是一项持续的挑战。
LlamaIndex 适合哪些人
LlamaIndex 最适合构建核心问题是从私有数据中进行结构化检索的应用程序的 Python 或 TypeScript 开发者:企业知识库、文档问答、多源数据代理以及合同或报告处理管道。在金融、法律、医疗保健或研究领域处理繁重文档工作流的团队,将从 LlamaParse 和 LlamaExtract 中获益最多,而无需构建自定义解析逻辑。对于希望获得一个开箱即用地处理分块、索引和混合检索的、具有主见的数据优先框架的开发者来说,在以 RAG 为中心的用例中,它能以比 LangChain 更少的样板代码实现相同的目标。
该开源框架也非常适合本地 LLM 设置。Ollama 和 llama.cpp 集成使开发者能够使用本地托管的模型运行完整的管道,将所有数据保留在本地,完全不需要 LlamaCloud。这使得 LlamaIndex 即使在免费层也适用于敏感数据环境。
LlamaIndex 不是什么
LlamaIndex 不是一个无代码产品。它没有可视化界面,没有拖放式管道构建器,也没有用户可以在没有开发者设置的情况下打开的聊天界面。非技术用户无法直接使用它。
对于主要需求是复杂的代理编排而非数据检索的团队来说,它不是最佳选择。如果应用程序从根本上讲是关于多步推理、工具使用、记忆以及基于 Web API 的代理循环,而不是以文档为主的私有数据,那么 LangChain/LangGraph 更广泛的生态系统和第一方可观测性(LangSmith)是更好的起点。同样,如果团队需要一个用于 IT 托管工作流的可视化企业管道构建器,Haystack Studio 能更直接地满足该需求。
大规模使用 LlamaParse 的成本会迅速增加。在 Agentic 层级(每页 10 个积分,每页 $0.0125),每月处理 100,000 页需要花费 $1,250 的解析积分,这还不包括 $500 的 Pro 计划订阅费。在对嘈杂文档进行大批量处理之前,应先进行成本计算。
最后,对于仍在使用 v0.9 或更早版本的团队,迁移到当前的 v0.14 分支需要付出深思熟虑的努力。v0.10 中的架构更改不向后兼容。在依赖假设当前包结构的社区示例之前,请为迁移预留时间。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 LlamaIndex 的精选合集。
相关文章
与 LlamaIndex 相关的指南和文章。

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)