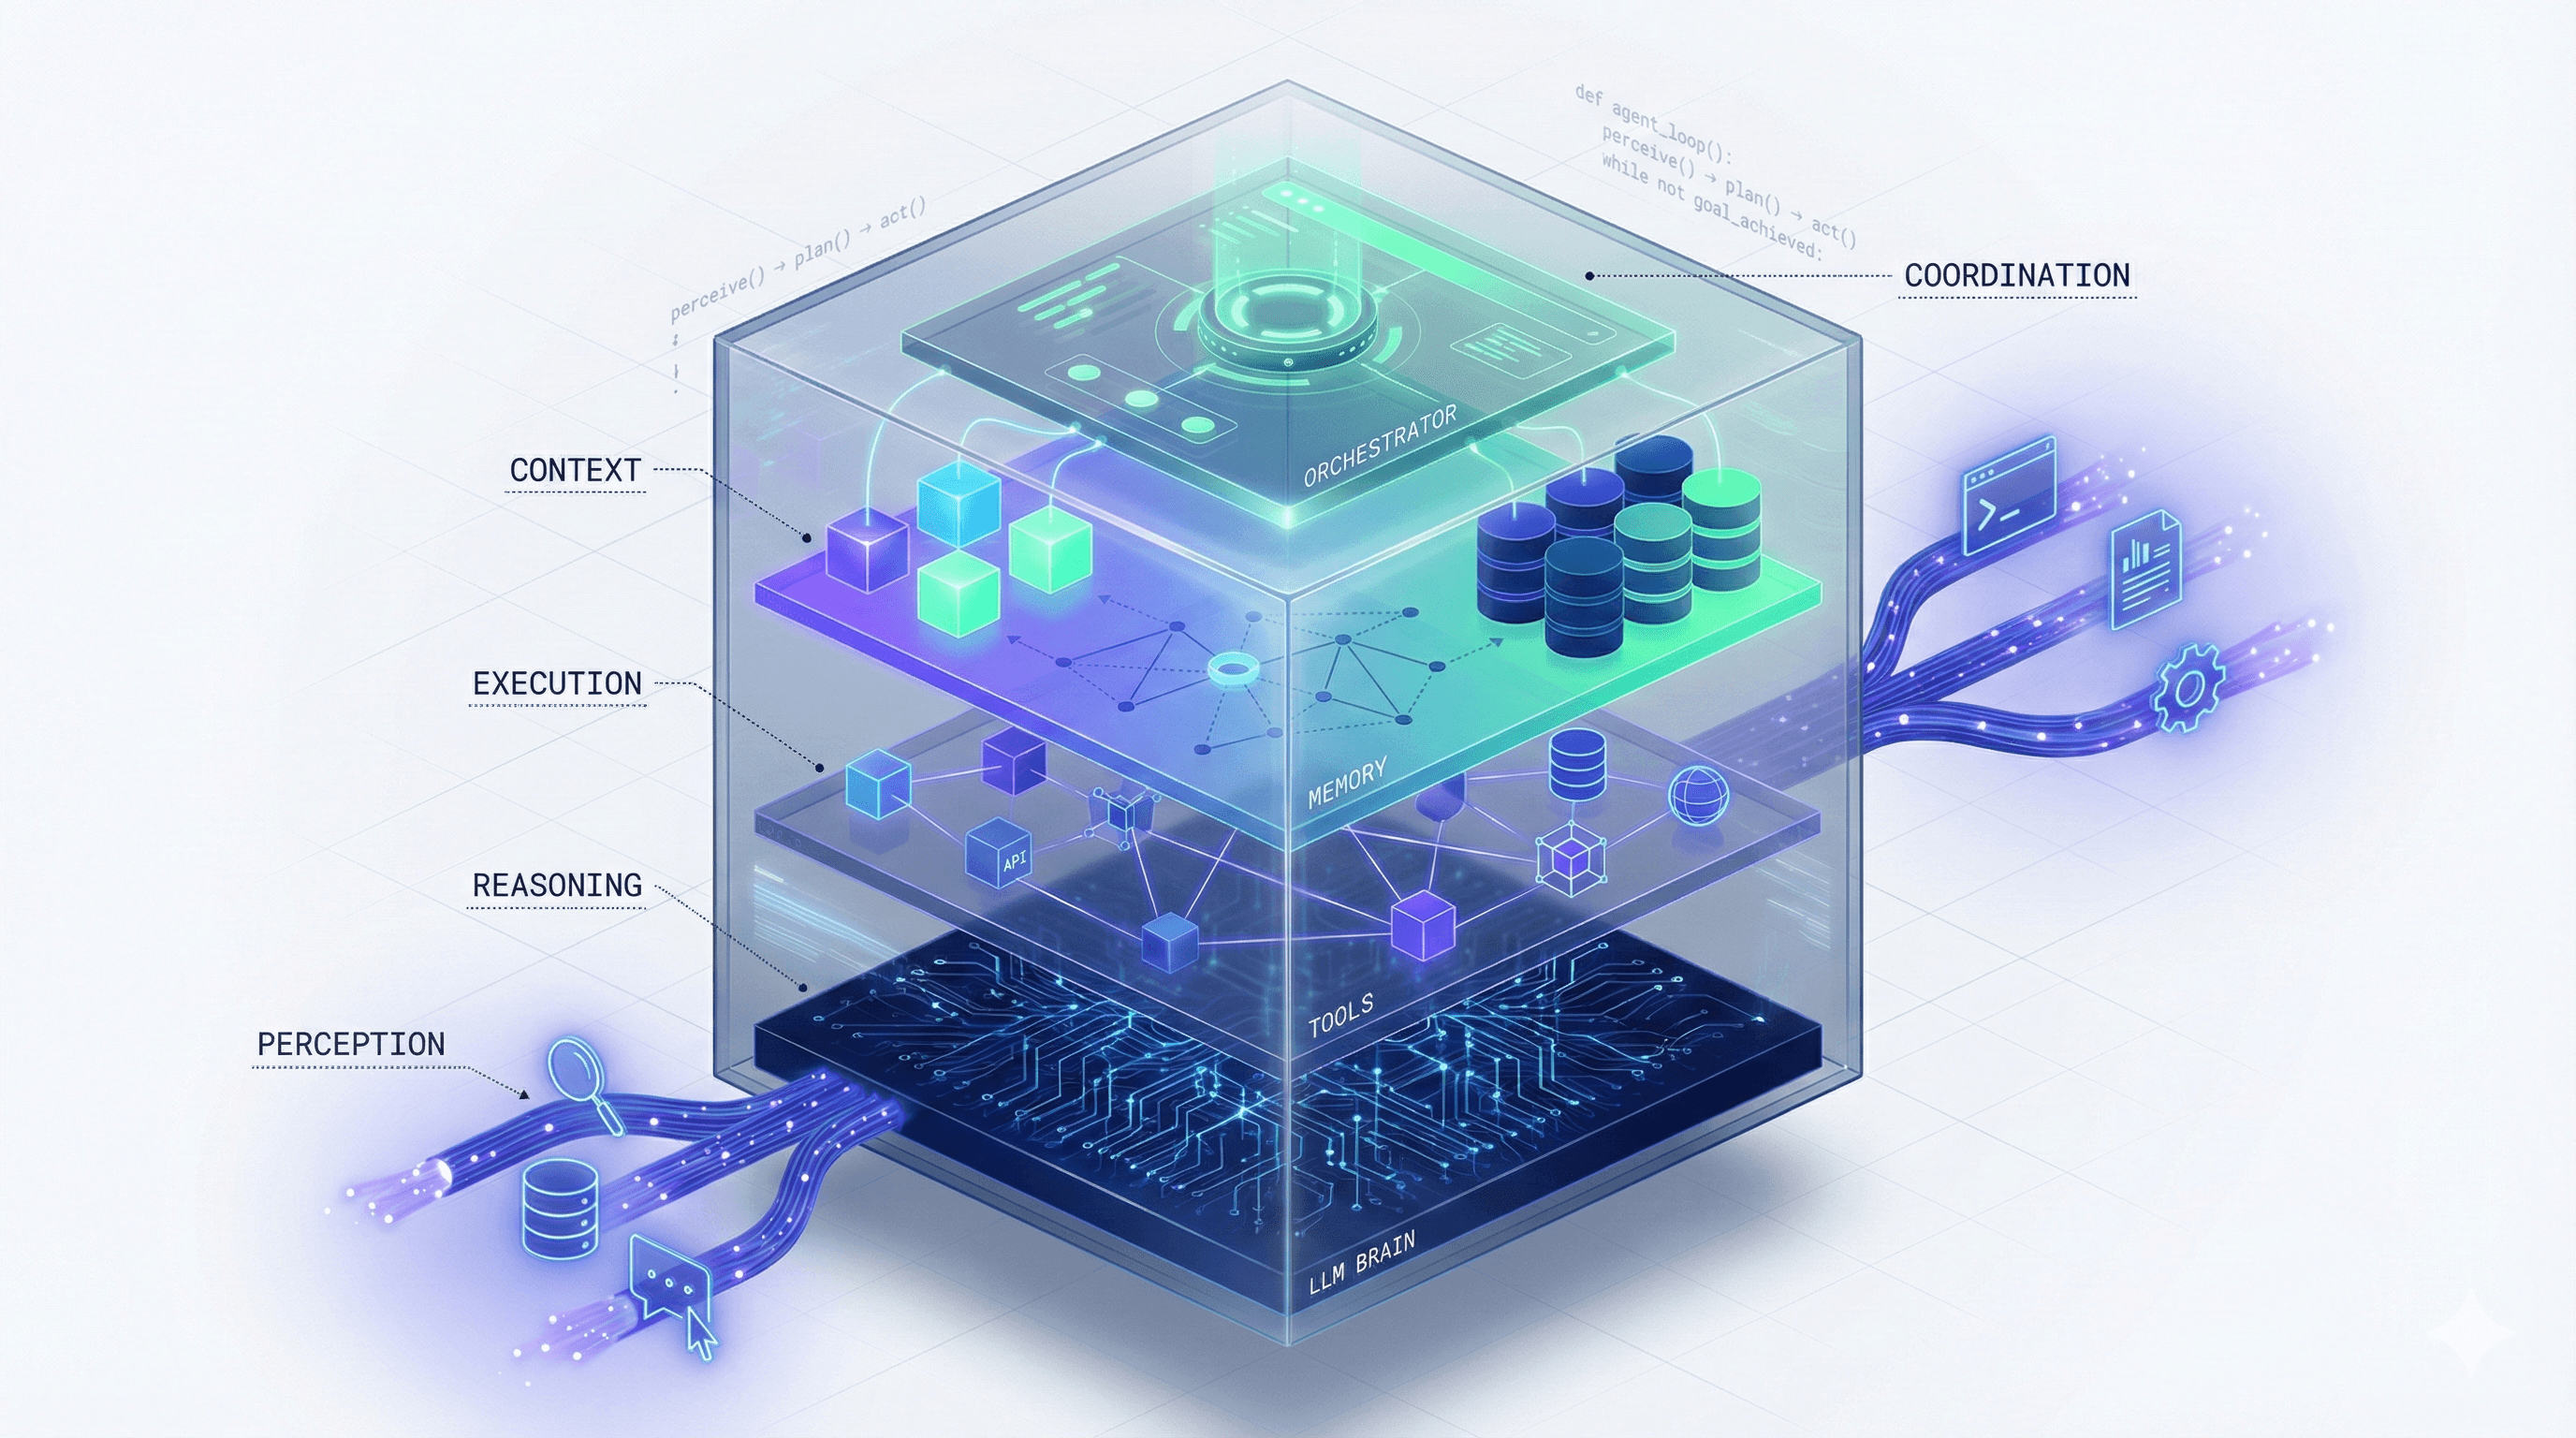

SWE-Agent 是一款来自普林斯顿大学的开源自主软件工程智能体,它使用自定义的智能体-计算机接口(Agent-Computer Interface)来解决 GitHub issue、修复 bug 并应对网络安全挑战。免费、采用 MIT 许可证、与模型无关。
SWE-Agent 是一款由普林斯顿大学(Princeton University)和斯坦福大学(Stanford University)的研究人员构建的自主软件工程智能体。该工具于 2024 年发布并在 NeurIPS 2024 上亮相,它能够接收 GitHub issue 的 URL,并尝试使用您提供的任何语言模型编写补丁来解决该问题。该项目由普林斯顿 NLP 组的 John Yang、Carlos Jimenez、Kilian Lieret 和 Ofir Press 维护。它完全免费,采用 MIT 许可证,并且完全在您自己的基础设施上运行。
该智能体的核心理念是智能体-计算机接口(Agent-Computer Interface,简称 ACI),这是一个专门构建的抽象层,用针对语言模型信息处理方式优化过的结构化命令取代了原始的 shell 访问。文件查看、搜索和编辑被呈现为简洁、有边界的操作,而不是开放式的终端调用。正如 NeurIPS 2024 论文中详细指出的那样,在提供 ACI 工具而非原始 bash 的情况下,同一个 GPT-4 模型在 SWE-bench 上的得分大约翻了一番。除了解决 issue 之外,SWE-Agent 还包含用于攻击性网络安全任务的 EnIGMA 模式,并支持批处理、基于 YAML 的全量配置以及用于并行化云端执行的 SWE-ReX 运行时。该项目的 mini-SWE-agent 变体仅包含约 100 行 Python 代码,但在使用现代前沿模型时,其在 SWE-bench Verified 上的得分超过了 74%。
SWE-Agent 在 2026 年 5 月的实际表现
在核心层面,SWE-Agent 接收一个 GitHub issue URL 和一个模型 API 密钥,然后运行一个自主循环来读取代码库、复现 bug、编辑代码并测试修复方案。智能体循环由 ACI 驱动:每次文件查看都受到边界限制以防止上下文溢出,编辑操作会通过一个自动回滚错误语法的代码检查器(linter),并且智能体的状态(当前文件、光标位置)由运行时跟踪,而不是从对话历史中推断。
当前的稳定版本是 v1.1.0(2025 年 5 月 22 日),该版本引入了 SWE-smith 轨迹生成和 SWE-agent-LM-32b 开放权重模型。其架构通过 litellm 支持任何 LLM,包括 OpenAI、Anthropic、Google 以及本地模型。并行执行由 SWE-ReX 处理,它可以将沙盒运行路由到 Docker、AWS、Modal 或 Fargate 后端。每次运行都会生成一个结构化的轨迹文件,适用于研究回放、微调或审计。
EnIGMA 于 v0.7.0(2024 年 9 月)引入,是专门针对夺旗赛(CTF)网络安全挑战的独立模式。它增加了交互式智能体工具(Interactive Agent Tools)和一个用于处理漏洞利用脚本长终端输出的摘要器,在 NYU CTF 基准测试中实现了比以往智能体高出 3.3 倍的性能提升。EnIGMA 作为一篇独立论文在 ICML 2025 上发表。
于 2025 年中发布的 mini-SWE-agent 项目则采取了截然相反的理念:将一切精简为一个单一的 bash 工具和一个简单的 ReAct 循环。在使用 Gemini 或 Claude 时,它在 SWE-bench Verified 上取得了超过 74% 的成绩,以减少了 100 倍的代码量达到了与完整版智能体相媲美的性能。对于希望无需 YAML 配置即可获得结果的新用户,普林斯顿团队现在建议从 mini-SWE-agent 开始,而不是使用完整的框架。
“现代 LLM 只需要 bash 就能解决编码任务,这一洞察非常具有验证意义。对于开始动手实践来说,这极具指导性和启发性。” - scottyeager,Hacker News,2025 年 7 月
SWE-Agent 与 OpenHands 和 Aider 的定位对比
三大开源编码智能体主导着研究排行榜:SWE-Agent、OpenHands 和 Aider。它们有着共同的使命,但在机制的几乎每个维度上都存在差异。
SWE-Agent vs OpenHands:OpenHands 在 Docker 容器内运行,采用事件流架构:智能体生成动作(Actions),环境执行它们并返回观察结果(Observations),循环往复。每个会话都拥有 SSH 访问权限、用于 Python 执行的 Jupyter 内核以及用于 Web 自动化的 BrowserGym 接口。多智能体委派是原生的:父智能体可以为特定子任务启动子智能体并整合它们的结果。OpenHands 还附带了精美的 Web UI 和 VSCode 扩展。SWE-Agent 则没有这些。它仅支持 CLI,没有 Web UI,其多智能体支持也处于实验阶段。SWE-Agent 拥有而 OpenHands 缺乏的是 EnIGMA 的网络安全模式、为研究人员提供的更深层次的 YAML 配置界面,以及 SWE-ReX 并行执行引擎。OpenHands 适合需要通用型自主开发者的团队。SWE-Agent 则适合希望控制智能体循环每个环节的研究人员和开发者。
SWE-Agent vs Aider:Aider 采用 git 优先的理念:每次编辑都会成为代码库历史中自动提交的命名 commit。Aider 从终端交互式运行,擅长与开发者进行协作式的来回沟通,并且由于它在代码库上下文中保持较浅的深度,每个任务使用的 token 数量大约减少了 4.2 倍。SWE-Agent 在自主模式下非交互式运行,生成结构化轨迹,并且由于 ACI 允许更深层次的代码库遍历,因此具有更高的 SWE-bench 上限。Aider 更适合结对的迭代式编码会话。SWE-Agent 更适合完全自动化、异步的 issue 解决,无需开发者介入。两者都没有网络安全模式;这仍然是 SWE-Agent 的 EnIGMA 变体所独有的。
在商业背景下,SWE-Agent 和 OpenHands 在价格上都显著低于 Devin(免费 vs 按 ACU 计费),同时在基准测试性能上与之匹敌甚至超越。Cursor 和 Cline 占据了不同的细分市场,它们侧重于 IDE 集成的代码补全和聊天,而不是自主解决 issue,因此它们与 SWE-Agent 更多是互补关系,而非直接竞争。
“SWE-bench 仅测试 Python 代码库中的 issue 解决能力,这限制了其对跨语言和任务类型的真实场景的预测价值。” - ToolHalla AI,比较分析,2026 年
智能体循环的真实运作情况
运行 SWE-Agent 遵循一致的模式。您通过 pip install sweagent 进行安装,在环境变量中设置您的 LLM API 密钥,并使用 GitHub issue URL 和您选择的模型调用 CLI。智能体会将代码库克隆到沙盒中,读取 issue,通过 ACI 命令探索相关文件,进行针对性编辑,并尝试运行测试套件。运行结束后会生成一个补丁文件和一份轨迹日志。
ACI 的设计是区分运行成功与否的关键。在具有清晰、明确的 issue 和 Python 测试覆盖率的代码库上,智能体可以在无需人工干预的情况下解决相当一部分问题。对于模棱两可的 issue(“它在我的机器上崩溃了”),智能体要么干净利落地失败,要么生成一个看似合理但不完整的补丁。SWE-bench-Live 基准测试(测试没有数据集污染的真正全新 issue)显示,SWE-Agent 和 OpenHands 的得分都在 18-20% 左右,这与精选基准测试中 70%+ 的数字形成了令人清醒的差距。在实际生产环境中使用时,需要人工审查每一个提议的补丁。
2025 年 2 月发布的 SWE-Agent 1.0 引入了 SWE-ReX,使得并行评估变得切实可行。研究人员现在可以跨 Modal 或 AWS 后端同时运行数百次 issue 解决尝试。对于大规模评估智能体质量的团队来说,这消除了挂钟时间(wall-clock time)的瓶颈,而这种瓶颈曾使得最初的顺序执行在面对大量积压任务时变得不切实际。
Token 成本是一个反复出现的不确定因素。SWE-Agent 在执行前不会显示单次运行的成本估算。成本完全取决于模型选择、issue 复杂性以及智能体执行的 ACI 轮数。经验丰富的用户报告称,使用 Claude 或 GPT-4o 处理复杂的 issue 平均需要消耗几十万个 token,按当前的 API 费率计算,每个 issue 的成本约为 1-5 美元。对于批处理,团队建议使用提供商级别的批处理 API,以将成本降低 50%。
v1.0 升级还引入了一些让部分用户措手不及的破坏性变更。轨迹数据中的 messages 字段被重命名为 query,工具包(tool bundles)被重命名,CLI 子命令结构也发生了重大变化。将 SWE-Agent 作为评估流水线一部分运行的团队需要更新他们的工具。团队在迁移说明中记录了这些变更,但对于没有密切关注代码库的人来说,这种变动带来了真实的成本。对于 SWE-Agent 来说,版本纪律比大多数开源工具更重要,因为研究步伐很快,而且团队将基准测试的改进置于 API 稳定性之上。
SWE-Agent 是为谁构建的
SWE-Agent 首先是为研究人员构建的。YAML 配置系统、轨迹日志记录、对自定义工具包的支持以及学术论文的血统,都表明这是一款期望其用户阅读文档并修改源码的工具。19,100 颗 GitHub star 以及来自 IBM、NVIDIA、Meta、Nebius 和 Anyscale 的引用反映了这一受众群体。它在机器学习研究实验室中被广泛采用,作为衡量新智能体设计的基准线。
除了研究之外,SWE-Agent 也适合希望进行自主 issue 分流的独立开发者和小型团队。其工作流是:向智能体提供积压的已标记 GitHub issue,审查它生成的补丁,合并那些通过 CI 的补丁。这并非开箱即用,它需要您熟悉自己的测试套件并进行仔细审查,但这是一个真实的工作流,据团队报告,在明确说明的 bug 修复上,它每周能节省数小时的时间。
EnIGMA 开辟了一个独特的用户群体:安全研究人员和 CTF 参赛者。在 NYU CTF 挑战和 CyBench 结果上 3.3 倍的提升,使其成为目前较强的免费自动化渗透测试工具之一。大学和研究型公司的安全团队是这里的主要采用者。
SWE-Agent 不是什么
SWE-Agent 不是面向非技术用户的产品。它没有托管的 Web UI,没有面向非开发者的单次点击安装,除了 GitHub issue 和 Discord 社区之外也没有客户支持。如果您的评估标准包括精美的界面,请考虑查看 OpenHands。
它不是一个持久的编码助手。与 Aider 的交互模式或像 Cursor 这样基于 IDE 的工具不同,SWE-Agent 在两次运行之间没有记忆。智能体在每次调用时都会重新开始。期望它在多个会话中积累关于代码库知识的用户将会感到失望。虽然存在变通方法(在 YAML 配置中提供项目上下文),但这些都是手动操作的。
它不能替代开发者对补丁质量的判断。在 SWE-bench Verified 上接近 80% 的性能令人印象深刻,但这些基准测试是经过精心挑选的。具有部分测试覆盖率、模棱两可的规范以及跨语言依赖关系的真实世界代码库会大幅降低其性能。每一个进入生产环境的 SWE-Agent 补丁都应该通过您的 CI 流水线并接受人工代码审查。
它不是一个带有供应商 SLA、企业支持或合规认证的商业产品。对于需要保证正常运行时间、审计跟踪或 SSO 集成的团队来说,Devin 的企业层级或托管替代方案更为合适。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 SWE-Agent 的精选合集。
相关文章
与 SWE-Agent 相关的指南和文章。

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
SWE-bench Pro Explained: Why the Benchmark Changed (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC