LiteLLM هي بوابة ذكاء اصطناعي مفتوحة المصدر من تطوير BerriAI (YC W23) تقوم بترجمة واجهات برمجة التطبيقات (APIs) لأكثر من 100 مزود للنماذج اللغوية الكبيرة (LLM) إلى نقطة نهاية واحدة متوافقة مع OpenAI. يمكنك استضافة الخادم الوكيل (proxy server) ذاتياً لتوجيه الطلبات عبر OpenAI و Anthropic و Bedrock وغيرها، مع ميزات مدمجة لتتبع النفقات، وتحديد معدل الطلبات، والتوجيه الاحتياطي.
LiteLLM هي بوابة ذكاء اصطناعي مفتوحة المصدر وحزمة تطوير برمجيات (SDK) للغة Python من تطوير BerriAI، وهي شركة مدعومة من Y Combinator (دفعة شتاء 2023) أسسها Krrish Dholakia و Ishaan Jaffer. تحل الأداة مشكلة محددة وملموسة: فمع إضافة فرق العمل لمزيد من مزودي النماذج اللغوية الكبيرة (LLM) إلى حزمتهم التقنية، يقدم كل مزود تنسيقاً خاصاً لواجهة برمجة التطبيقات (API)، ونموذج مصادقة، وسلوكاً مختلفاً للأخطاء. تقف LiteLLM كواجهة أمام كل هؤلاء المزودين وتترجم كل طلب إلى تنسيق OpenAI، بحيث لا يحتاج كود التطبيق أبداً إلى معرفة المزود الذي يتواصل معه. بحلول أبريل 2026، حصد المشروع 45,400 نجمة على GitHub، وأكثر من 1,000 مساهم، وأفاد بتقديم مليار طلب عبر بنيته التحتية للخادم الوكيل.
تتوفر الأداة في وضعين. تتيح لك حزمة Python SDK استدعاء litellm.completion() مباشرة في الكود وتتولى ترجمة التنسيق، وإعادة المحاولة، والتوجيه الاحتياطي تلقائياً عبر أكثر من 100 مزود بما في ذلك OpenAI و Anthropic و Google Vertex AI و AWS Bedrock و Azure OpenAI و Cohere و Mistral و HuggingFace و NVIDIA NIM و Ollama و vLLM. أما وضع الخادم الوكيل (Proxy Server) فهو بوابة HTTP ذاتية الاستضافة يمكنك نشرها عبر Docker: حيث يمكن لأي عميل OpenAI SDK حالي الاتصال بها دون تغييرات في الكود، ويتولى الخادم الوكيل التوجيه، وإدارة مفاتيح API الافتراضية، وحدود الميزانية لكل فريق، وتحديد معدل الطلبات، وتكاملات المراقبة مع أدوات مثل Langfuse و Arize Phoenix. كلا الوضعين مرخصان بموجب MIT ومجانيان للاستخدام. تتوفر ميزات حوكمة المؤسسات، بما في ذلك تسجيل الدخول الموحد (SSO)، والتحكم في الوصول القائم على الدور (RBAC)، وسجلات التدقيق، في الباقات المدفوعة التي تبدأ من $250 شهرياً.
ما الذي تفعله LiteLLM فعلياً في أبريل 2026
الوظيفة الأساسية هي ترجمة المزود. عندما يرسل تطبيقك طلباً بتنسيق Anthropic عبر LiteLLM، تقوم المكتبة بإعادة كتابة حقول الإدخال والإخراج لتتطابق مع ما يتوقعه النموذج المستهدف، وتوحد رموز الأخطاء عبر المزودين، وتعيد استجابة بتنسيق OpenAI بغض النظر عن النموذج الذي تعامل مع الطلب. عادةً ما تتم إضافة المزودين الجدد في غضون يوم واحد من الإصدار العام لواجهة برمجة التطبيقات الخاصة بهم، وهو ما مكن LiteLLM من مواكبة التوسع السريع للصناعة لتدعم أكثر من 100 نقطة نهاية.
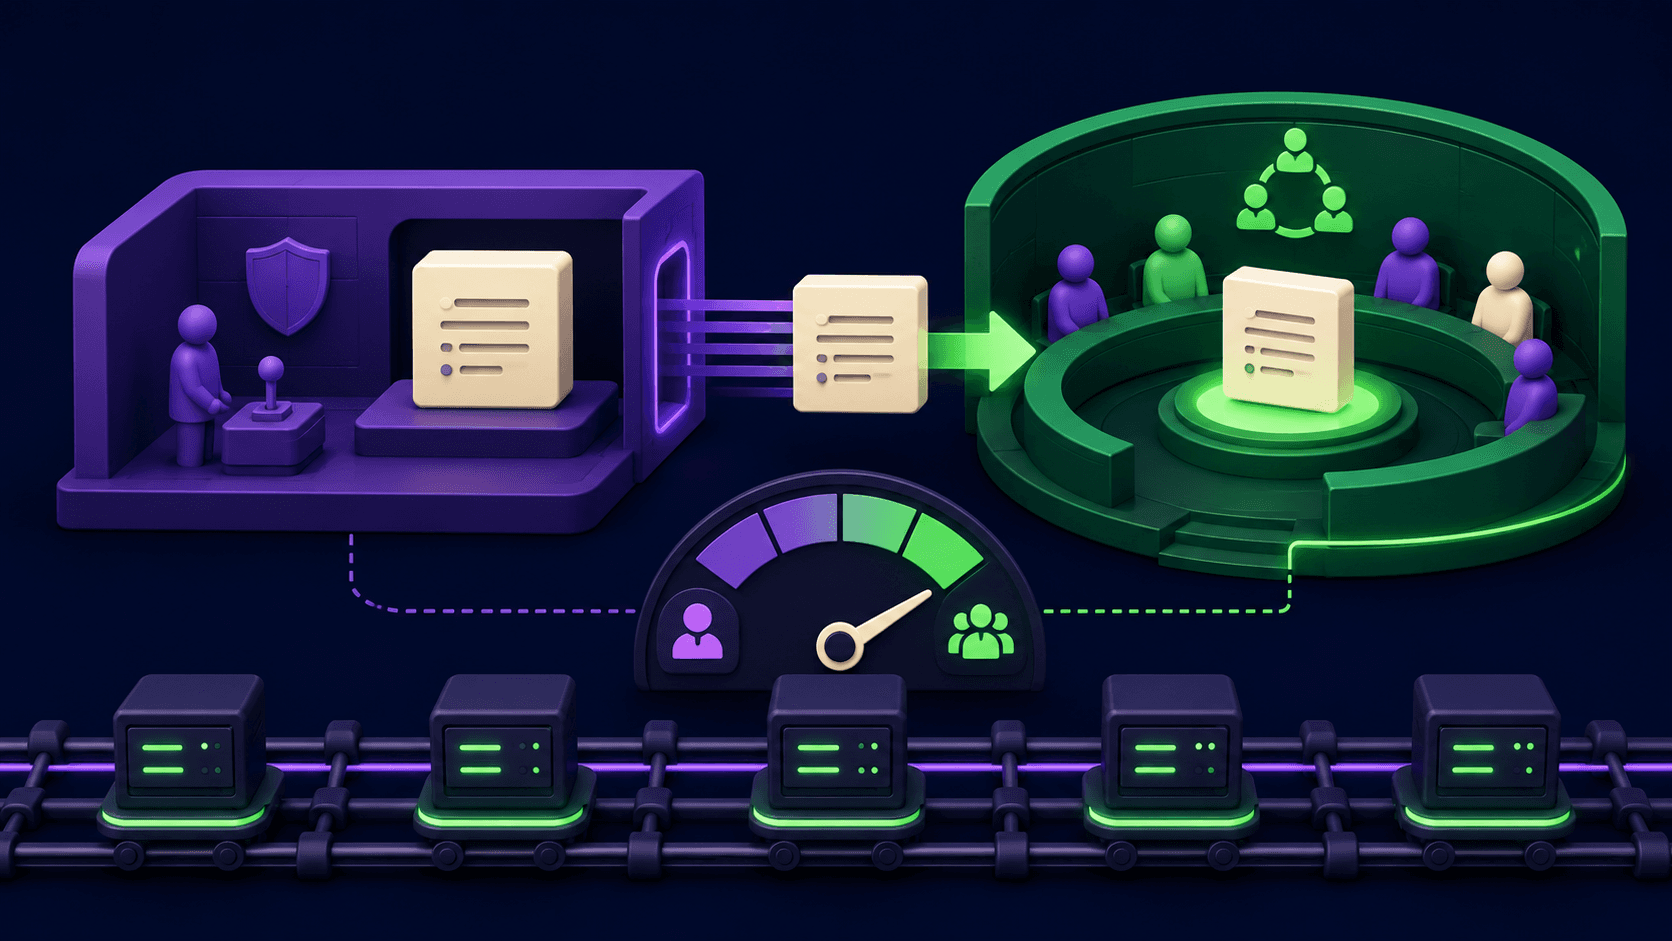
يوسع الخادم الوكيل هذه الإمكانيات بإدارة وصول على مستوى الإنتاج. تقوم الفرق بتكوينه باستخدام ملف YAML يحدد مجموعات النماذج، والميزانيات لكل مفتاح، وقواعد التوجيه. يمكن لفريق المنصة إصدار مفاتيح API افتراضية للفرق الفردية مع حدود إنفاق صارمة، وقوائم نماذج مسموح بها، وحدود للطلبات في الدقيقة (RPM) يتم فرضها على مستوى الخادم الوكيل. عندما يكون النموذج الأساسي غير متاح أو مقيداً بمعدل الطلبات، ينتقل الخادم الوكيل تلقائياً إلى بديل تم تكوينه مسبقاً. تعمل موازنة الحمل على توزيع الطلبات عبر مثيلات متعددة لنفس المزود. يحدث كل هذا دون أن يعرف التطبيق أي شيء عن منطق التوجيه.
تتكامل المراقبة (Observability) خارجياً بدلاً من أن تكون مدمجة بشكل أصلي. تقوم LiteLLM بتوجيه السجلات إلى Langfuse أو Arize Phoenix أو Prometheus أو OpenTelemetry. بعد ذلك، تقوم الفرق بتصور توزيع التكاليف حسب الفريق أو المفتاح أو المستخدم في منصة المراقبة التي يختارونها. توفر واجهة مستخدم الخادم الوكيل لوحة تحكم أساسية للإنفاق، ولكن إعدادات المراقبة في بيئات الإنتاج عادةً ما تربطها بأدوات خارجية للتنبيهات والاحتفاظ بالبيانات على المدى الطويل.
"فكرة وجود خادم وكيل للنماذج اللغوية الكبيرة (LLM proxy) جذابة للغاية. يمكن أن تساعد الفرق على الاختيار ديناميكياً بين النماذج المحلية والسحابية دون إعادة هيكلة بنيتهم التحتية." -- jmorgan (مبتكر Ollama)، Hacker News، ديسمبر 2023
غالباً ما تكون حزمة Python SDK هي الطريقة التي يتعرف بها المطورون لأول مرة على LiteLLM. الواجهة عبارة عن غلاف بسيط: قم بتثبيت الحزمة، وتعيين مفاتيح API للمزود كمتغيرات بيئة، واستدعاء litellm.completion(model="gpt-4o", messages=[..]). التبديل إلى Claude يتطلب تغييراً في حقل واحد فقط في سلسلة النموذج. تتعامل الحزمة مع البث (streaming)، والاستدعاءات غير المتزامنة (async)، وحساب الرموز (tokens)، وتتبع التكلفة لكل طلب. يمكن للمطورين الذين يبنون باستخدام LangChain أو LlamaIndex إدراج LiteLLM كعميل النموذج الأساسي للحصول على توجيه متعدد المزودين دون المساس بطبقة إطار العمل العليا.
موقع LiteLLM مقارنة بـ OpenRouter و Portkey
تهيمن ثلاث أدوات على نقاشات بوابات النماذج اللغوية الكبيرة (LLM): LiteLLM و OpenRouter و Portkey. تتخذ هذه الأدوات رهانات معمارية مختلفة جذرياً، ويعتمد الاختيار الصحيح على فلسفة البنية التحتية الخاصة بك بدلاً من قوائم الميزات.
OpenRouter هو سوق مغلق ومستضاف. تقوم بالتسجيل، وتحصل على مفتاح API واحد، وتصل إلى أكثر من 300 نموذج بما في ذلك النماذج المحسنة مجتمعياً عبر خوادم OpenRouter. يضيف OpenRouter رسوماً بنسبة 5.5% على شراء الأرصدة ويأخذ حصة من الإيرادات مع مزودي النماذج المدرجين في سوقه. تتدفق جميع بياناتك عبر البنية التحتية لـ OpenRouter، مما يعني عدم وجود أعباء نشر ولكن لا يوجد تحكم في توجيه البيانات. بالنسبة للنماذج الأولية السريعة والمشاريع الشخصية، يعد OpenRouter أسرع مسار للوصول إلى نماذج متعددة. عند إنفاق $10,000 شهرياً على النماذج اللغوية الكبيرة، فإنك تدفع لـ OpenRouter رسوماً بقيمة $550. لا يمكنك استضافته ذاتياً، أو تدقيق الكود الخاص به، أو نشره في بيئة معزولة عن الشبكة (air-gapped). يعمل بشكل أفضل للمطورين الذين يريدون الوصول إلى النماذج، وليس التحكم في البنية التحتية.
Portkey هي بوابة مغلقة ومدارة تعمل على شبكة الحافة (edge network) الخاصة بـ Portkey. يتم تسعيرها بناءً على السجلات المسجلة (حوالي $49 شهرياً لباقة Pro، والتي تغطي 100 ألف إلى 3 ملايين طلب)، مما يعني أن التكلفة تتناسب مع استخدام المراقبة بدلاً من حجم الرموز (tokens). ما يميز Portkey هو المراقبة المدمجة على مستوى الإنتاج: سجلات الطلبات التفصيلية، وتتبع زمن الوصول، وتوزيع التكاليف، والتخزين المؤقت الدلالي (semantic caching)، ومقاييس الحماية (guardrails) المضمنة في الخدمة المدارة دون الحاجة إلى تكاملات خارجية. يتيح التخزين المؤقت الدلالي، الغائب بشكل ملحوظ عن الإصدار مفتوح المصدر من LiteLLM، لـ Portkey تقديم استجابات مخزنة مؤقتاً للاستعلامات المتشابهة دلالياً (وليس المتطابقة فقط)، مما يمكن أن يقلل التكاليف بشكل كبير على نطاق واسع. مثل OpenRouter، لا يمكن استضافة Portkey ذاتياً وتتدفق البيانات عبر بنيتها التحتية.
LiteLLM تتخذ رهاناً معاكساً: أنت تمتلك البنية التحتية والبيانات. ترخيص MIT يعني أنه يمكنك تدقيق الكود، ونشره في البيئات الخاضعة للوائح التنظيمية، وتشغيله في إعدادات معزولة عن الشبكة حيث لا يمكن للبيانات أن تلمس خادماً لجهة خارجية أبداً. لا تخرج أي بيانات من شبكتك باستثناء الاستدعاءات المباشرة لمزودي النماذج اللغوية الكبيرة (LLM) الذين قمت بتكوينهم صراحةً. المقابل لذلك هو العبء التشغيلي. يتطلب تشغيل مثيل LiteLLM في بيئة الإنتاج إدارة PostgreSQL و Redis وترحيل قواعد البيانات والنسخ الاحتياطي وتجميع الاتصالات (connection pooling). تتراوح تكاليف البنية التحتية لإعداد إنتاج واقعي بين $2,000 و $2,300 شهرياً قبل احتساب تكلفة عمالة DevOps. تصبح LiteLLM الفائز الواضح من حيث التكلفة مقارنة بـ OpenRouter بمجرد أن يتجاوز الإنفاق على النماذج اللغوية الكبيرة حوالي $10,000 شهرياً، ولكن فقط إذا كان فريقك يمتلك القدرة على صيانة الحزمة التقنية.
"تبديل المزودين هو تغيير في سطر واحد من الكود. هذا هو الوعد الأساسي، وبالنسبة لمعظم المزودين، فإنه يفي به بالفعل." -- مراجع على aicoolies.com، 2025
غالباً ما يستخدم المطورون الذين يستخدمون OpenRouter جنباً إلى جنب مع LiteLLM أداة OpenRouter للوصول إلى النماذج المجتمعية والتجريبية بينما يوجهون حركة مرور الإنتاج عبر مثيل LiteLLM مستضاف ذاتياً للامتثال. الأداتان لا تستبعد إحداهما الأخرى: يمكن لـ LiteLLM العمل كوكيل لـ OpenRouter كأحد مزوديها المكونين. بالنسبة للفرق التي تستخدم بالفعل Helicone للمراقبة، يمكن أن تتعايش LiteLLM كطبقة توجيه بينما تتولى Helicone عملية التسجيل.
كيف يبدو الواقع اليومي للخادم الوكيل
الإعداد سريع. يعمل المثيل المحلي في أقل من عشر دقائق: قم بالتثبيت عبر pip، وأنشئ ملف تكوين YAML يسرد نماذجك وبيانات اعتماد المزود الخاصة بها، وقم بتشغيل litellm --config config.yaml، وأي عميل متوافق مع OpenAI يتصل بـ localhost:4000 سيتم توجيهه الآن عبر الخادم الوكيل. تضيف إعدادات Docker Compose كلاً من Postgres و Redis في عشر دقائق أخرى من أجل الاستمرارية والتخزين المؤقت.
تكوين YAML هو المكان الذي تقضي فيه الفرق معظم وقتها. تحدد مجموعات النماذج سلاسل التوجيه الاحتياطي. تتحكم إعدادات الموجه (Router) فيما إذا كانت موازنة الحمل تعتمد على التوزيع الدائري (round-robin)، أو الأقل انشغالاً (least-busy)، أو الموزونة بزمن الوصول (latency-weighted). يتم إصدار مفاتيح الميزانية لكل فريق مع حدود صارمة وتنبيهات مرنة. بالنسبة لفريق المنصة الذي يوحد الوصول إلى النماذج اللغوية الكبيرة عبر الشركة، يصبح هذا التكوين وثيقة السياسة المركزية لجميع نفقات الذكاء الاصطناعي.
في الأحجام المعتدلة (أقل من 100,000 طلب يومياً)، يكون الخادم الوكيل شفافاً إلى حد كبير. العبء الإضافي لزمن الوصول لمعظم الاستدعاءات يكون في حده الأدنى. يعمل التوجيه الاحتياطي، وفرض الميزانية، ومنطق إعادة المحاولة الخاص بالمزود دون تدخل.
في الأحجام الكبيرة، تصبح قاعدة البيانات نقطة الاختناق. تكتب LiteLLM سجلات الطلبات إلى PostgreSQL بشكل متزامن في مسار الطلب. بعد تجاوز مليون صف سجل متراكم، تعترف الوثائق نفسها بأن أوقات استجابة واجهة برمجة التطبيقات (API) قد تتدهور. أبلغت الفرق عن طلبات مخزنة مؤقتاً مع أوقات استجابة للتخزين المؤقت تبلغ مللي ثانية واحدة، ومع ذلك تعيد أزمنة وصول من البداية إلى النهاية تزيد عن 10 ثوانٍ بسبب العبء الإضافي لتسلسل الكتابة في قاعدة البيانات. الحل التشغيلي البديل هو تعطيل التسجيل التفصيلي أو تقسيم قاعدة البيانات (sharding)، مما يبطل الغرض من تتبع النفقات المدمج. دفع هذا القيد المعماري بعض الفرق ذات الإنتاجية العالية نحو بدائل مبنية على بيئات تشغيل أسرع (ظهرت خوادم وكيلة مبنية على Go مثل Bifrost خصيصاً لمعالجة هذا الأمر).
يمكن لوكلاء الذكاء الاصطناعي المبنيين باستخدام AnythingLLM أو أطر عمل الوكلاء الأخرى التوجيه إلى خادم وكيل LiteLLM كخلفية للنموذج الخاص بهم، مما يمنح فرق المنصة رؤية مركزية حول إنفاق النماذج اللغوية الكبيرة الصادر عن الوكلاء دون الحاجة إلى إدارة مفاتيح API لكل وكيل على حدة.
لمن تم بناء LiteLLM
تعمل LiteLLM بشكل أفضل لفرق هندسة المنصات والواجهات الخلفية التي تدير الوصول إلى النماذج اللغوية الكبيرة لفرق داخلية متعددة، أو تتعامل مع بيانات خاضعة للوائح التنظيمية لا يمكن أن تتدفق عبر بنية تحتية لجهات خارجية، أو تدير إنفاقاً كافياً على النماذج اللغوية الكبيرة يبرر تكلفة الاستضافة الذاتية. الشركات التي تبني منتجات ذكاء اصطناعي على مزودين متعددين من أجل المرونة (Claude كأساسي، و GPT-4o كاحتياطي، و Bedrock كخيار مطلوب للمؤسسات) تستفيد بأقصى قدر من منطق التوجيه والاحتياط الخاص بالبوابة.
يستخدم مهندسو الذكاء الاصطناعي الذين يقومون ببناء نماذج أولية عبر نماذج مختلفة حزمة Python SDK كطبقة "جرب قبل أن تلتزم": قم بالبناء على واجهة litellm.completion() وبدّل المزودين دون المساس بمنطق التطبيق. هذا مفيد حقاً خلال المراحل المبكرة من المنتج، عندما يكون النموذج المناسب لمهمة ما لا يزال قيد التقييم.
تقدر المؤسسات في قطاعات الرعاية الصحية أو التمويل أو الصناعات الأخرى الخاضعة للوائح التنظيمية خيار النشر المعزول عن الشبكة (air-gapped) والقدرة على تدقيق قاعدة الكود بالكامل للامتثال. يعني نموذج الاستضافة الذاتية أنه يمكنك أن تثبت للمدققين أن بيانات المطالبات (prompts) الحساسة لا تلمس أبداً خادماً لجهة خارجية.
ما لا تقدمه LiteLLM
لا تعد LiteLLM خياراً جيداً للأفراد أو المطورين المستقلين أو الفرق الصغيرة. العبء الإضافي للبنية التحتية، والاعتماد على PostgreSQL و Redis، ونموذج تكوين YAML، وعبء الصيانة التشغيلية، كلها مصممة لفرق الهندسة التي تمتلك قدرات DevOps. المطور الذي يريد فقط استدعاء Claude و GPT-4o من نفس قاعدة الكود سيستفيد بشكل أفضل من حزمة Python SDK وحدها (بدون الخادم الوكيل) أو من خيار OpenRouter المستضاف الذي لا يتطلب أي إعداد.
تجاوز LiteLLM إذا كنت بحاجة إلى تخزين مؤقت دلالي (semantic caching) مدمج دون عمل تكامل إضافي. التخزين المؤقت بتنسيق OpenAI (التطابق التام) يعمل؛ أما إزالة التكرار للاستعلامات المتشابهة دلالياً فيتطلب منك ربط طبقة خارجية بنفسك. بالنسبة للفرق التي تكون المراقبة فيها هي المطلب الأساسي، فإن الحزمة المدارة من Portkey تقدم قيمة أكبر مقابل المال في الأحجام المنخفضة إلى المعتدلة.
تعد حادثة سلسلة التوريد في PyPI في مارس 2026 سياقاً مهماً لأي فريق يقيم حزمة Python الخاصة بـ LiteLLM. تم اختراق الإصدارين 1.82.7 و 1.82.8 من قبل مجموعة التهديد "TeamPCP" عبر ماسح أمان Trivy مسموم في مسار CI/CD الخاص بـ BerriAI. الحزم الخبيثة، التي حصدت مفاتيح SSH، وبيانات الاعتماد السحابية، ورموز Kubernetes، كانت نشطة لمدة 40 دقيقة تقريباً في 24 مارس 2026 قبل أن تقوم PyPI بعزلها. كانت استجابة BerriAI شفافة: نشر Krrish Dholakia و Ishaan Jaffer جدولاً زمنياً عاماً، واستعانوا بفريق Mandiant من Google للتحليل الجنائي، وقاموا بتدوير جميع بيانات الاعتماد، وأصدروا نسخاً نظيفة من خلال مسار CI/CD محصن. لم يتأثر العملاء الذين يقومون بتشغيل صورة Docker الرسمية. يجب على الفرق التي تقوم بالتثبيت من PyPI مباشرة تثبيت الإصدار v1.83.0 أو أحدث والتحقق من مسار الإصدار قبل الترقية.
كما أن LiteLLM لا تستضيف النماذج. إنها طبقة توجيه وترجمة، وليست مزود حوسبة. يمكن للفرق التي تقوم بتشغيل الاستدلال المحلي عبر Ollama أو vLLM توجيه LiteLLM إلى تلك الخوادم، ولكن LiteLLM نفسها لا تمتلك بنية تحتية لوحدات معالجة الرسومات (GPU).
تقييمات المستخدمين
لا توجد تقييمات بعد. كن أول من يشارك تجربته!
سجّل الدخول لكتابة تقييم.
ظهرت في مجموعات
قوائم منتقاة تتضمّن LiteLLM.
مقالات ذات صلة
أدلة ومقالات ذات صلة بـ LiteLLM.

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing