
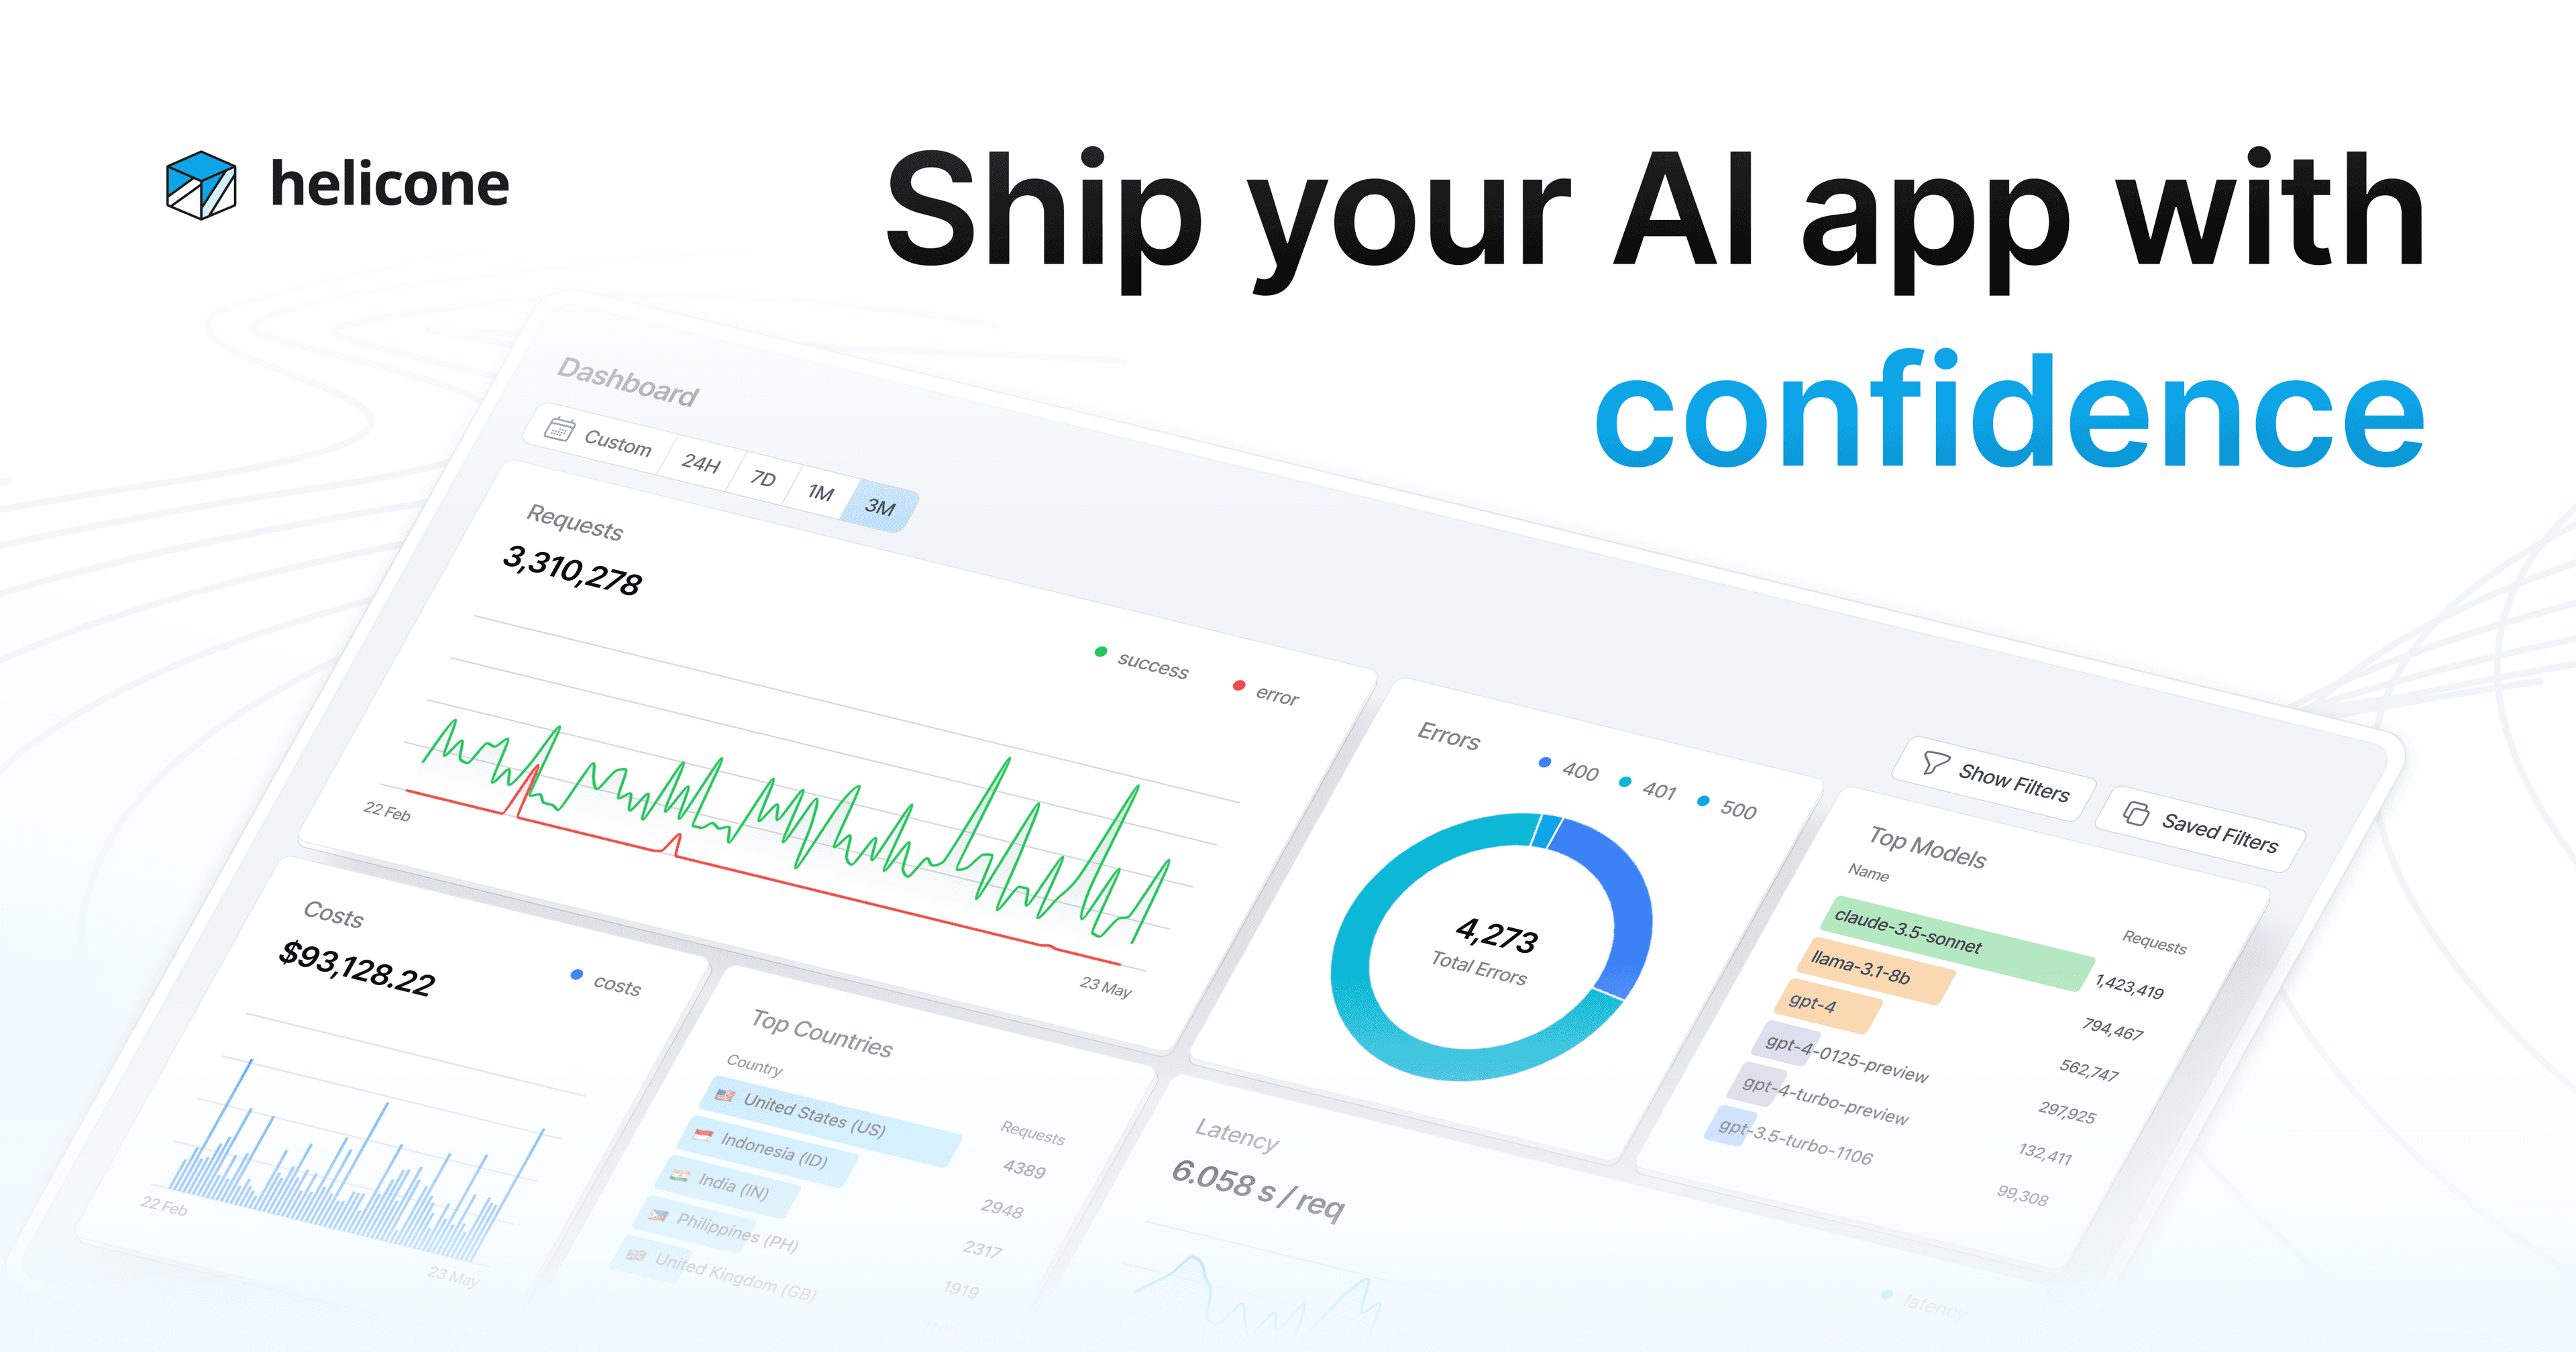
Helicone es una plataforma de observabilidad de LLM de código abierto y puerta de enlace de IA (AI gateway) de YC W23. Con solo cambiar una URL, los equipos obtienen seguimiento de costos, registro de solicitudes, almacenamiento en caché semántico y gestión de prompts en OpenAI, Anthropic y más de 100 modelos. Utilizada por 16,000 organizaciones antes de su adquisición por Mintlify en marzo de 2026.
Helicone es una plataforma de observabilidad de LLM de código abierto y puerta de enlace de IA creada por Justin Torre y Cole Gottdank, lanzada en el lote W23 de Y Combinator en 2023. El problema central que resuelve es muy práctico: cuando los equipos comienzan a lanzar aplicaciones de IA, rápidamente pierden visibilidad sobre lo que realmente hacen sus LLM, cuánto cuestan y dónde fallan. Helicone restaura esa visibilidad a través de una arquitectura basada en proxy, enrutando las solicitudes a través de su puerta de enlace basada en Cloudflare Workers para que cada llamada a OpenAI, Anthropic, Gemini, Mistral o DeepSeek se registre, cronometre y analice automáticamente. Antes de que la empresa fuera adquirida por Mintlify el 3 de marzo de 2026, Helicone había procesado 14.2 billones de tokens en 16,000 organizaciones activas.
La característica principal de la plataforma es su integración en una sola línea: cambie su URL base de OpenAI para que apunte a la puerta de enlace de Helicone y toda su aplicación se instrumentará al instante, sin necesidad de envolver SDKs. Más allá del registro básico, Helicone ofrece almacenamiento en caché semántico (que, según los equipos, reduce regularmente los costos de LLM entre un 20 y un 40 %), enrutamiento de AI Gateway con conmutación por error automática del proveedor, control de versiones y gestión de prompts, HQL (Helicone Query Language) para consultas analíticas personalizadas, limitación de velocidad y un entorno de pruebas (playground) para evaluar variantes de prompts con muestras de datos de producción reales. La plataforma tiene licencia Apache 2.0 y es totalmente autoalojable a través de Docker o Helm. Desde su adquisición por Mintlify en marzo de 2026, Helicone opera en modo de mantenimiento con parches de seguridad continuos, soporte para nuevos modelos y corrección de errores, pero sin el desarrollo de nuevas funciones importantes.
Lo que realmente hace Helicone en abril de 2026
Helicone funciona como un proxy HTTP transparente que se sitúa entre su aplicación y cualquier proveedor de LLM. Cuando llama a openai.baseURL = "https://oai.helicone.ai/v1", la solicitud pasa a través de la red perimetral de Cloudflare Workers de Helicone, se registra en ClickHouse para su análisis y se reenvía a OpenAI con una sobrecarga inferior a 5 ms en el punto de referencia de latencia p50. La plataforma es compatible con más de 100 modelos a través de su AI Gateway unificado, incluyendo OpenAI, Anthropic, Azure OpenAI, Google Gemini, DeepSeek, Mistral, Together AI, OpenRouter y Groq. El soporte de integración se extiende a más de 30 frameworks, incluyendo LangChain, LlamaIndex, el Vercel AI SDK y LiteLLM.
El panel de observabilidad muestra métricas de costos, latencia y calidad desglosadas por usuario, sesión, endpoint y modelo. Los equipos utilizan HQL para escribir consultas personalizadas sobre su historial de solicitudes, de forma similar a los análisis SQL sobre sus registros de LLM. La función Prompts permite el control de versiones de prompts vinculado a datos de producción reales, con la implementación de nuevas versiones directamente a través de la puerta de enlace sin necesidad de implementar código. La función Datasets de Helicone permite a los equipos crear conjuntos de evaluación a partir de tráfico de producción muestreado, mientras que el Playground admite pruebas en vivo de variantes de prompts antes de promoverlas. Las alertas e informes integrados cubren picos de costos, tasas de error y anomalías de latencia.
La plataforma se ganó su lugar en el ecosistema en parte gracias a su sincronización: se lanzó cuando el registro de llamadas a LLM requería la creación de middleware personalizado, y realmente resolvió ese problema con una fricción mínima. En el momento de su adquisición, era la herramienta de observabilidad de LLM más utilizada entre las empresas del portafolio de YC y había sido la número 1 en Product Hunt el día de su lanzamiento.
"Helicone simplemente funciona desde el primer momento, es realmente útil para nosotros al investigar los problemas de los usuarios" - Brandon Chen, Product Hunt, 2024
Dónde se sitúa Helicone frente a Langfuse y LangSmith
La diferencia mecánica entre estas tres plataformas es arquitectónica, no cosmética. Helicone intercepta en la capa de red, situándose entre el código de su aplicación y el endpoint de la API del proveedor de LLM. Ve las solicitudes y respuestas HTTP individuales. Langfuse y LangSmith se integran en la capa de aplicación, envolviendo los pasos del agente y la lógica del flujo de trabajo dentro de su código con llamadas al SDK. Esta distinción determina lo que cada plataforma puede observar realmente.
Langfuse (licencia MIT, más de 19K estrellas en GitHub, autoalojable) requiere instrumentación explícita del SDK: los desarrolladores envuelven cada paso del agente, el intervalo de seguimiento (trace span) y el gancho de evaluación en llamadas al SDK de Langfuse. Esto toma de 1 a 2 horas de configuración, pero brinda una visibilidad completa del flujo de trabajo del agente de múltiples pasos con jerarquías de intervalos anidados. Langfuse ve que la llamada al LLM B fue activada por la llamada a la herramienta A dentro de la ejecución del agente X, algo que el proxy de Helicone no puede capturar sin el etiquetado manual de encabezados. Langfuse también tiene un sistema de gestión de prompts y evaluación de conjuntos de datos más maduro. La opción autoalojada es totalmente gratuita; la versión en la nube comienza en $50/mes con un generoso nivel gratuito de 50K eventos/mes. Para los equipos que desean autoalojar sus datos de observabilidad en su propia infraestructura, Langfuse es la opción clara.
LangSmith (el producto de observabilidad de LangChain, $39/mes en el plan Plus) está acoplado al framework. Para los equipos que ya utilizan LangChain o LangGraph, el seguimiento requiere una configuración casi nula a través de dos variables de entorno. LangSmith comprende la topología de la cadena de LangChain de forma nativa, sabe qué herramienta activó qué llamada al LLM y muestra ese contexto automáticamente. Para los equipos que no utilizan LangChain, la instrumentación manual lleva de 2 a 3 horas y LangSmith pierde su principal ventaja. En marzo de 2025, LangChain agregó soporte de OpenTelemetry de extremo a extremo a LangSmith, reduciendo un poco la dependencia del proveedor. El arnés de evaluación integrado de LangSmith y el entorno de pruebas por ejecución son más profundos que las funciones equivalentes de Helicone.
Las ventajas de Helicone sobre ambos son la velocidad de configuración (menos de 15 minutos, cero cambios en el código de la aplicación) y el almacenamiento en caché semántico integrado, que ni Langfuse ni LangSmith ofrecen de forma nativa. A $79/mes para usuarios ilimitados, Helicone también es más económico que ambos para equipos en crecimiento. La contrapartida: Helicone ve llamadas a la API individuales, no la topología del flujo de trabajo. Si su aplicación es una cadena simple de llamadas a LLM, Helicone le brinda todo lo que necesita. Si se trata de un agente complejo de múltiples pasos en el que necesita comprender por qué el paso 7 activó una llamada a un modelo en particular, necesita Langfuse o LangSmith.
"Me brinda información extremadamente útil y detallada sobre el uso, los costos y los tiempos de respuesta" - Ryan Hendrickson, Product Hunt, 2024
Cómo es la realidad del proxy en el día a día
La experiencia de integración realmente cumple su promesa. Para un equipo que ejecuta llamadas a OpenAI, el cambio es una línea en el constructor del cliente de OpenAI. Para un equipo de Anthropic, de manera similar, es un cambio de encabezado. A partir de ese momento, cada solicitud aparece en el panel de Helicone. El seguimiento de costos es automático: Helicone mapea cada modelo y recuento de tokens a los precios actuales de su proveedor y le muestra exactamente cuánto cuesta cada endpoint, usuario o función por día. Los percentiles de latencia (p50, p90, p99) se desglosan por modelo y tipo de solicitud.
El almacenamiento en caché semántico es la característica que la mayoría de los equipos citan al describir el ROI. Helicone incrusta cada solicitud, verifica en la caché si hay respuestas anteriores semánticamente similares dentro de un umbral de similitud configurable y devuelve la respuesta en caché si se cumple el umbral. Los equipos con cargas de trabajo de alta repetición (bots de atención al cliente, sistemas de preguntas y respuestas de documentos, asistentes de codificación) comúnmente reportan reducciones de costos del 20 al 40 % dentro de una semana de habilitarlo. La configuración se realiza a través del panel, no mediante código.
Las frustraciones que surgen en producción tienden a agruparse en torno a lo que la arquitectura del proxy no puede ver. Cuando un flujo de trabajo de agentes falla después de siete pasos, el panel de Helicone muestra siete llamadas a la API individuales con sus costos y latencias, pero no cómo están conectadas o qué decisión previa desencadenó la falla. La depuración de fallas de agentes de múltiples pasos a través de Helicone requiere el etiquetado manual de sesiones y la correlación de seguimientos, lo que elimina la ventaja de "sin cambios de código". Los equipos que alcanzan esta complejidad suelen agregar Langfuse como una segunda capa o migrar por completo.
Para quién está diseñado Helicone
Helicone es la herramienta adecuada para los equipos que necesitan observabilidad de LLM rápidamente y no desean instrumentar su código base. Los principales beneficiarios son los equipos de productos de IA en etapa inicial (de 2 a 20 ingenieros), los equipos que ejecutan canalizaciones de LLM simples en lugar de agentes complejos de múltiples pasos y los equipos conscientes de los costos que desean almacenamiento en caché y análisis sin tener que construir infraestructura.
Funciona especialmente bien para entornos multimodelo que ejecutan solicitudes en varios proveedores. El panel unificado agrega los costos de OpenAI, Anthropic y otros proveedores en una sola vista, lo cual es más difícil de replicar solo con herramientas nativas del proveedor. Para las startups que iteran rápidamente en los prompts, las funciones Playground y Datasets permiten a los no ingenieros ejecutar experimentos de prompts con muestras de datos de producción sin tocar el código. Para equipos de menos de 10 personas que solo necesitan responder "cuál es nuestro gasto en LLM este mes y qué función lo está causando", Helicone es posiblemente excesivo pero completamente adecuado.
El cumplimiento de SOC-2 e HIPAA está en el plan Team a $799/mes, lo que deja fuera a los equipos más pequeños que necesitan cumplimiento. Las organizaciones empresariales con estrictos requisitos de residencia de datos en la UE pueden encontrar incómodo el modelo de proxy incluso con la red perimetral de Cloudflare: cada solicitud de LLM, incluido el contenido del usuario, pasa a través de la infraestructura de Helicone. El hilo de lanzamiento en HN en marzo de 2023 sacó a la luz estas preocupaciones explícitamente, con múltiples comentaristas preguntando sobre la PII de la UE y si la arquitectura del proxy violaba los términos de servicio de OpenAI. Helicone abordó ambas preguntas, pero la realidad arquitectónica de un proxy en la nube que maneja tráfico de producción sigue siendo una consideración para los casos de uso sensibles a los datos.
Lo que Helicone no es
Helicone es una capa de monitoreo, no una plataforma de observabilidad full-stack. No admite canalizaciones de evaluación de prompts con puntuación automatizada, detección de regresiones o medición de la calidad de la suite de evaluación. Su función Scores permite adjuntar calificaciones numéricas manuales a las solicitudes, lo cual es básico en comparación con los arneses de evaluación de Langfuse o Braintrust. Cuando una solicitud falla o produce un mal resultado, Helicone lo registra, pero no hay una máquina de estado de problemas, ni seguimiento del ciclo de vida, ni un mecanismo para determinar si un problema recurrente se resolvió o retrocedió.
El estado de modo de mantenimiento desde marzo de 2026 también es un contexto relevante. Los equipos que eligen Helicone hoy están eligiendo un producto en fase de cierre: los parches de seguridad y las adiciones de nuevos modelos continuarán, pero la hoja de ruta del producto se detuvo. Para los equipos con un horizonte de varios años que necesitan un desarrollo activo de la plataforma de observabilidad de la que dependen, esta es una limitación real. El equipo de Helicone nombró explícitamente a LiteLLM y Portkey como alternativas para los equipos que buscan un desarrollo activo continuo.
Primeros pasos con Helicone
El proceso de incorporación (onboarding) es la característica más fuerte de la plataforma. Cree una cuenta gratuita en helicone.ai, copie su clave API de Helicone y cambie la URL base de su cliente de OpenAI a https://oai.helicone.ai/v1 con la clave de Helicone agregada como encabezado. Ese único cambio envía todo el tráfico de OpenAI a través de Helicone. Para Anthropic, apunte a https://anthropic.helicone.ai. Para Azure OpenAI, Google Gemini y otros, Helicone proporciona URL de puerta de enlace específicas del proveedor. El tiempo típico hasta la primera solicitud registrada es de menos de cinco minutos.
El nivel gratuito Hobby maneja 10,000 solicitudes/mes con retención de 7 días, suficiente para desarrollo y uso ligero en producción. El plan Pro a $79/mes desbloquea usuarios ilimitados, retención de 1 mes, alertas y consultas analíticas HQL. El autoalojamiento está documentado para Docker y Helm con la pila completa de cinco servicios (web NextJS, Cloudflare Worker, API Express, Supabase, ClickHouse, MinIO). Para los equipos que necesitan mantener los datos fuera de la infraestructura de terceros, el autoalojamiento es viable, aunque requiere mantener la pila. El repositorio de GitHub en github.com/Helicone/helicone tiene 5.6K estrellas y un componente de AI gateway basado en Rust con resultados de referencia que muestran una sobrecarga p50 inferior a 5 ms con alto rendimiento.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen Helicone.
Artículos relacionados
Guías y artículos relacionados con Helicone.
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC

Nous Hermes 4: The Self-Hosted Open-Weight Agent Brain (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Replace 6 SaaS Subscriptions With 4 n8n AI Agents (2026)
