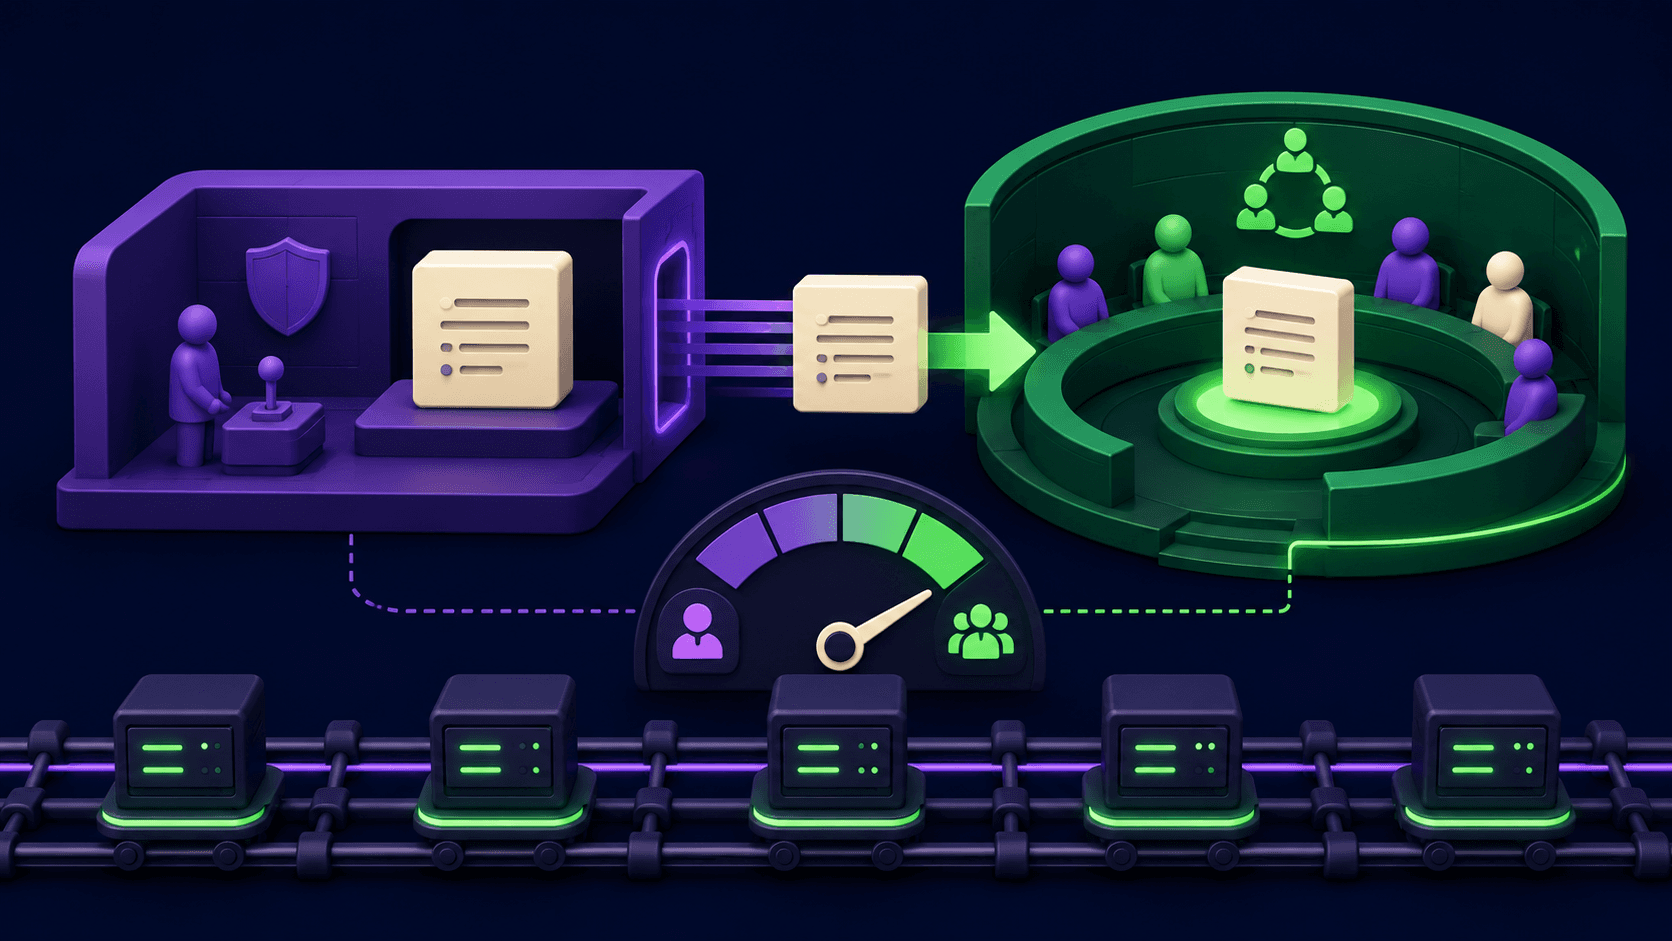
LiteLLM est une passerelle IA open source développée par BerriAI (YC W23) qui traduit les API de plus de 100 fournisseurs de LLM en un point de terminaison unique compatible avec OpenAI. Auto-hébergez le serveur proxy pour router vos requêtes vers OpenAI, Anthropic, Bedrock et bien d'autres, avec un suivi des dépenses, une limitation de débit et un routage de secours intégrés.
LiteLLM est une passerelle IA open source et un SDK Python développés par BerriAI, une entreprise soutenue par Y Combinator (Winter 2023) et fondée par Krrish Dholakia et Ishaan Jaffer. L'outil résout un problème spécifique et concret : à mesure que les équipes ajoutent des fournisseurs de LLM à leur stack, chaque fournisseur impose son propre format d'API, son modèle d'authentification et sa gestion des erreurs. LiteLLM se place en amont de tous ces services et traduit chaque appel au format d'OpenAI, de sorte que le code de l'application n'a jamais besoin de savoir avec quel fournisseur il communique. En avril 2026, le projet a atteint 45 400 étoiles sur GitHub, plus de 1 000 contributeurs et a déclaré avoir traité 1 milliard de requêtes via son infrastructure proxy.
L'outil est disponible en deux modes. Le SDK Python vous permet d'appeler litellm.completion() directement dans le code et gère automatiquement la traduction des formats, les nouvelles tentatives et les solutions de secours pour plus de 100 fournisseurs, dont OpenAI, Anthropic, Google Vertex AI, AWS Bedrock, Azure OpenAI, Cohere, Mistral, HuggingFace, NVIDIA NIM, Ollama et vLLM. Le mode Proxy Server est une passerelle HTTP auto-hébergée que vous déployez via Docker : tout client SDK OpenAI existant pointe vers elle sans modification de code, et le proxy gère le routage, la gestion des clés API virtuelles, les limites de budget par équipe, la limitation de débit et les intégrations d'observabilité avec des outils comme Langfuse et Arize Phoenix. Les deux modes sont sous licence MIT et gratuits à exécuter. Les fonctionnalités de gouvernance d'entreprise, incluant le SSO, le RBAC et les journaux d'audit, sont disponibles dans les niveaux payants à partir de $250 par mois.
Ce que fait réellement LiteLLM en avril 2026
La fonction principale est la traduction entre fournisseurs. Lorsque votre application envoie une requête au format Anthropic via LiteLLM, la bibliothèque réécrit les champs d'entrée et de sortie pour correspondre à ce que le modèle cible attend, normalise les codes d'erreur entre les fournisseurs et renvoie une réponse au format d'OpenAI, quel que soit le modèle ayant traité l'appel. Les nouveaux fournisseurs sont généralement ajoutés dans la journée suivant la publication de leur API publique, ce qui explique comment LiteLLM a su suivre le rythme de l'expansion rapide du secteur au-delà de 100 points de terminaison pris en charge.
Le serveur proxy étend cela avec une gestion des accès de niveau production. Les équipes le configurent avec un fichier YAML qui définit les groupes de modèles, les budgets par clé et les règles de routage. Une équipe plateforme peut émettre des clés API virtuelles pour des escouades individuelles avec des plafonds de dépenses stricts, des listes d'autorisation de modèles et des limites de RPM appliquées au niveau du proxy. Lorsqu'un modèle principal est indisponible ou limité en débit, le proxy bascule automatiquement vers une alternative configurée. L'équilibrage de charge répartit les requêtes sur plusieurs instances du même fournisseur. Tout cela se produit sans que l'application n'ait connaissance de la logique de routage.
L'observabilité s'intègre de manière externe plutôt que native. LiteLLM achemine les journaux vers Langfuse, Arize Phoenix, Prometheus ou OpenTelemetry. Les équipes visualisent ensuite l'attribution des coûts par équipe, par clé ou par utilisateur dans leur plateforme d'observabilité de choix. L'interface utilisateur du proxy fournit un tableau de bord de base des dépenses, mais les configurations de surveillance en production le relient généralement à des outils externes pour les alertes et la conservation à long terme.
"L'idée d'un proxy LLM est super convaincante. Cela pourrait aider les équipes à choisir dynamiquement entre des LLM locaux et cloud sans restructurer leur infrastructure." -- jmorgan (créateur d'Ollama), Hacker News, décembre 2023
Le SDK Python est souvent la première façon dont les développeurs découvrent LiteLLM. L'interface est un wrapper léger : installez le package, définissez les clés API des fournisseurs comme variables d'environnement et appelez litellm.completion(model="gpt-4o", messages=[..]). Passer à Claude ne nécessite qu'une modification d'un seul champ dans la chaîne du modèle. Le SDK gère le streaming, les appels asynchrones, le comptage des tokens et le suivi des coûts par requête. Les développeurs qui construisent avec LangChain ou LlamaIndex peuvent intégrer LiteLLM comme client de modèle sous-jacent pour obtenir un routage multi-fournisseurs sans toucher à la couche framework supérieure.
Où se situe LiteLLM par rapport à OpenRouter et Portkey
Trois outils dominent les conversations sur les passerelles LLM : LiteLLM, OpenRouter et Portkey. Ils font des paris architecturaux fondamentalement différents, et le bon choix dépend de votre philosophie d'infrastructure plutôt que des listes de fonctionnalités.
OpenRouter est une place de marché hébergée et fermée. Vous vous inscrivez, obtenez une clé API et accédez à plus de 300 modèles, y compris des ajustements communautaires (fine-tunes), via les serveurs d'OpenRouter. OpenRouter ajoute des frais d'achat de crédits de 5,5 % et prend une part des revenus avec les fournisseurs de modèles qui s'inscrivent sur sa place de marché. Tout votre trafic transite par l'infrastructure d'OpenRouter, ce qui signifie aucune charge de déploiement mais aucun contrôle sur le routage des données. Pour le prototypage rapide et les projets personnels, OpenRouter est le chemin le plus rapide vers un accès multi-modèles. Pour $10,000 par mois de dépenses LLM, vous payez $550 de frais à OpenRouter. Vous ne pouvez pas l'auto-héberger, auditer son code ou le déployer dans un environnement isolé (air-gapped). Il convient mieux aux développeurs qui souhaitent un accès aux modèles, et non un contrôle de l'infrastructure.
Portkey est une passerelle gérée et fermée qui s'exécute sur le réseau edge de Portkey. Sa tarification est basée sur les journaux enregistrés (environ $49 par mois pour le niveau Pro, couvrant de 100K à 3M de requêtes), ce qui signifie que le coût évolue avec l'utilisation de l'observabilité plutôt qu'avec le volume de tokens. Le différenciateur de Portkey est son observabilité intégrée de niveau production : des journaux de requêtes détaillés, le traçage de la latence, l'attribution des coûts, la mise en cache sémantique et les métriques de garde-fous sont inclus dans le service géré sans nécessiter d'intégrations externes. La mise en cache sémantique, notablement absente du niveau open source de LiteLLM, permet à Portkey de servir des réponses mises en cache pour des requêtes sémantiquement similaires (et pas seulement identiques), ce qui peut réduire considérablement les coûts à grande échelle. Tout comme OpenRouter, Portkey n'est pas auto-hébergeable et le trafic transite par son infrastructure.
LiteLLM fait le pari inverse : vous possédez l'infrastructure et les données. La licence MIT signifie que vous pouvez auditer le code, le déployer dans des environnements réglementés et l'exécuter dans des configurations isolées (air-gapped) où le trafic ne peut jamais toucher un serveur tiers. Aucune donnée ne quitte votre réseau, à l'exception des appels directs aux fournisseurs de LLM que vous configurez explicitement. Le compromis est la charge opérationnelle. L'exécution d'une instance LiteLLM en production nécessite la gestion de PostgreSQL, Redis, des migrations de base de données, des sauvegardes et du regroupement de connexions (connection pooling). Les coûts d'infrastructure pour une configuration de production réaliste s'élèvent entre $2,000 et $2,300 par mois avant de prendre en compte le travail DevOps. LiteLLM devient le vainqueur incontestable en termes de coûts par rapport à OpenRouter une fois que les dépenses LLM dépassent environ $10,000 par mois, mais seulement si votre équipe a la capacité de maintenir la stack.
"Changer de fournisseur se fait en modifiant une seule ligne de code. C'est la promesse principale, et pour la plupart des fournisseurs, elle est réellement tenue." -- critique sur aicoolies.com, 2025
Les développeurs utilisant OpenRouter aux côtés de LiteLLM utilisent souvent OpenRouter pour accéder aux modèles communautaires et expérimentaux tout en acheminant le trafic de production via une instance LiteLLM auto-hébergée pour des raisons de conformité. Les deux ne sont pas mutuellement exclusifs : LiteLLM peut servir de proxy vers OpenRouter comme l'un de ses fournisseurs configurés. Pour les équipes utilisant déjà Helicone pour l'observabilité, LiteLLM peut coexister en tant que couche de routage tandis qu'Helicone gère la journalisation.
À quoi ressemble la réalité quotidienne du proxy
La configuration est rapide. Une instance locale fonctionnelle s'exécute en moins de dix minutes : installez via pip, créez un fichier de configuration YAML qui liste vos modèles et leurs identifiants de fournisseur, exécutez litellm --config config.yaml, et tout client compatible OpenAI ciblant localhost:4000 est désormais acheminé via le proxy. Les configurations Docker Compose ajoutent Postgres et Redis en dix minutes supplémentaires pour la persistance et la mise en cache.
La configuration YAML est l'endroit où les équipes passent la majeure partie de leur temps. Les groupes de modèles définissent les chaînes de secours. Les paramètres du routeur contrôlent si l'équilibrage de charge est de type round-robin, le moins occupé ou pondéré par la latence. Les clés de budget sont émises par équipe avec des plafonds stricts et des alertes souples. Pour une équipe plateforme standardisant l'accès aux LLM à l'échelle d'une entreprise, cette configuration devient le document de politique central pour toutes les dépenses en IA.
À volume modéré (moins de 100 000 requêtes par jour), le proxy est largement transparent. La surcharge de latence pour la plupart des appels est minime. Le routage de secours, l'application du budget et la logique de nouvelle tentative spécifique au fournisseur fonctionnent sans intervention.
À plus grand volume, la base de données devient le goulot d'étranglement. LiteLLM écrit les journaux de requêtes dans PostgreSQL de manière synchrone dans le chemin de la requête. Au-delà d'un million de lignes de journaux accumulées, la documentation elle-même reconnaît que les temps de réponse de l'API peuvent se dégrader. Des équipes ont signalé que des requêtes mises en cache avec des succès de cache d'une milliseconde renvoyaient toujours des latences de bout en bout de plus de 10 secondes en raison de la surcharge de sérialisation des écritures dans la base de données. La solution de contournement opérationnelle consiste à désactiver la journalisation détaillée ou à partitionner (sharder) la base de données, ce qui va à l'encontre de l'objectif du suivi des dépenses intégré. Cette contrainte architecturale a poussé certaines équipes à haut débit vers des alternatives construites sur des environnements d'exécution plus rapides (des proxys basés sur Go comme Bifrost ont émergé spécifiquement pour résoudre ce problème).
Les agents IA construits avec AnythingLLM ou d'autres frameworks d'agents peuvent pointer vers un proxy LiteLLM comme backend de modèle, ce qui donne aux équipes plateforme une visibilité centralisée sur les dépenses LLM générées par les agents sans nécessiter de gestion des clés API par agent.
À qui s'adresse LiteLLM
LiteLLM convient particulièrement aux équipes d'ingénierie plateforme et backend qui gèrent l'accès aux LLM pour plusieurs escouades internes, traitent des données réglementées qui ne peuvent pas transiter par une infrastructure tierce, ou qui ont des dépenses LLM suffisamment élevées pour justifier le coût de l'auto-hébergement. Les entreprises qui construisent des produits IA sur plusieurs fournisseurs pour des raisons de résilience (Claude en principal, GPT-4o en secours, Bedrock comme option requise par l'entreprise) tirent le meilleur parti de la logique de routage et de secours de la passerelle.
Les ingénieurs IA qui prototypent sur plusieurs modèles utilisent le SDK Python comme une couche "essayer avant de s'engager" : ils développent sur l'interface litellm.completion() et changent de fournisseur sans toucher à la logique de l'application. C'est véritablement utile lors des premières phases d'un produit, lorsque le bon modèle pour une tâche est encore en cours d'évaluation.
Les organisations des secteurs de la santé, de la finance ou d'autres industries réglementées apprécient l'option de déploiement isolé (air-gapped) et la possibilité d'auditer l'intégralité de la base de code pour des raisons de conformité. Le modèle auto-hébergé signifie que vous pouvez démontrer aux auditeurs que les données sensibles des prompts ne touchent jamais un serveur tiers.
Ce que LiteLLM n'est pas
LiteLLM n'est pas adapté aux particuliers, aux développeurs solos ou aux petites équipes. La surcharge d'infrastructure, les dépendances à PostgreSQL et Redis, le modèle de configuration YAML et la charge de maintenance opérationnelle sont tous calibrés pour des équipes d'ingénierie disposant de capacités DevOps. Un développeur qui souhaite simplement appeler Claude et GPT-4o à partir de la même base de code sera mieux servi par le SDK Python seul (sans le proxy) ou par l'option hébergée sans configuration d'OpenRouter.
Évitez LiteLLM si vous avez besoin d'une mise en cache sémantique intégrée sans travail d'intégration supplémentaire. La mise en cache au format OpenAI (correspondance exacte) fonctionne ; la déduplication de requêtes sémantiquement similaires nécessite que vous intégriez vous-même une couche externe. Pour les équipes où l'observabilité est l'exigence principale, la stack gérée de Portkey offre un meilleur rapport qualité-prix à des volumes faibles à modérés.
L'incident de la chaîne d'approvisionnement PyPI de mars 2026 est un contexte pertinent pour toute équipe évaluant le package Python de LiteLLM. Les versions 1.82.7 et 1.82.8 ont été compromises par le groupe d'acteurs malveillants "TeamPCP" via un scanner de sécurité Trivy empoisonné dans le pipeline CI/CD de BerriAI. Les packages malveillants, qui récoltaient des clés SSH, des identifiants cloud et des tokens Kubernetes, ont été en ligne pendant environ 40 minutes le 24 mars 2026 avant que PyPI ne les mette en quarantaine. La réponse de BerriAI a été transparente : Krrish Dholakia et Ishaan Jaffer ont publié une chronologie publique, engagé l'équipe Mandiant de Google pour une analyse forensique, effectué une rotation de tous les identifiants et publié des versions propres via un pipeline CI/CD renforcé. Les clients exécutant l'image Docker officielle n'ont pas été affectés. Les équipes installant directement depuis PyPI doivent épingler la version v1.83.0 ou ultérieure et vérifier le pipeline de publication avant de mettre à niveau.
LiteLLM n'héberge pas non plus de modèles. C'est une couche de routage et de traduction, pas un fournisseur de calcul. Les équipes exécutant une inférence locale via Ollama ou vLLM peuvent pointer LiteLLM vers ces serveurs, mais LiteLLM lui-même ne possède aucune infrastructure GPU.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Présent dans les collections
Listes sélectionnées incluant LiteLLM.
Articles associés
Guides et articles en lien avec LiteLLM.

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing