
Vapi est une plateforme d'infrastructure vocale IA permettant de créer et de déployer des agents téléphoniques à grande échelle. Elle permet aux développeurs d'apporter leur propre LLM, TTS et pile de téléphonie, en gérant l'orchestration en temps réel, les tours de parole et l'appel de fonctions dans plus de 100 langues.
Vapi est une plateforme d'infrastructure vocale IA qui permet aux développeurs de créer, déployer et faire évoluer des agents téléphoniques IA en utilisant les modèles de langage, les fournisseurs vocaux et les opérateurs de téléphonie de leur choix. Fondée par Jordan Dearsley et Nikhil Gupta, ingénieurs de l'Université de Waterloo et diplômés du Y Combinator W23, l'entreprise a levé une série A de $20M menée par Bessemer Venture Partners en décembre 2024. Il ne s'agit ni d'un fournisseur de voix hébergée ni d'un créateur de chatbots no-code. C'est un middleware d'orchestration : une couche programmable qui connecte vos fournisseurs STT, LLM et TTS en temps réel, gère la détection des tours de parole et la logique d'interruption, administre les appels de fonctions vers des API externes, et exécute l'ensemble du pipeline via une connexion WebSocket persistante avec une latence de bout en bout inférieure à 500ms dans des conditions optimales.
En avril 2026, Vapi revendique plus de 500,000 développeurs sur sa plateforme, plus de 300M d'appels traités et plus de 2.5M d'assistants lancés. Ses capacités principales incluent la prise en charge du « bring-your-own-model » (BYOM) avec OpenAI, Anthropic, Groq, Google, Together AI et des points de terminaison LLM personnalisés ; des fournisseurs vocaux tels qu'ElevenLabs, Azure, Deepgram et les voix sélectionnées par Vapi ; la téléphonie via Twilio, Vonage, Telnyx ou vos propres trunks SIP ; des tests A/B pour l'optimisation des prompts et des voix ; la détection automatisée des hallucinations ; ainsi qu'une API REST et des SDK pour TypeScript, Python et React. Les équipes utilisent Vapi pour le support client entrant, la prise de rendez-vous sortante, la prospection commerciale, l'admission des patients dans le secteur de la santé et les assistants vocaux en temps réel intégrés aux produits.
Ce que fait réellement Vapi en avril 2026
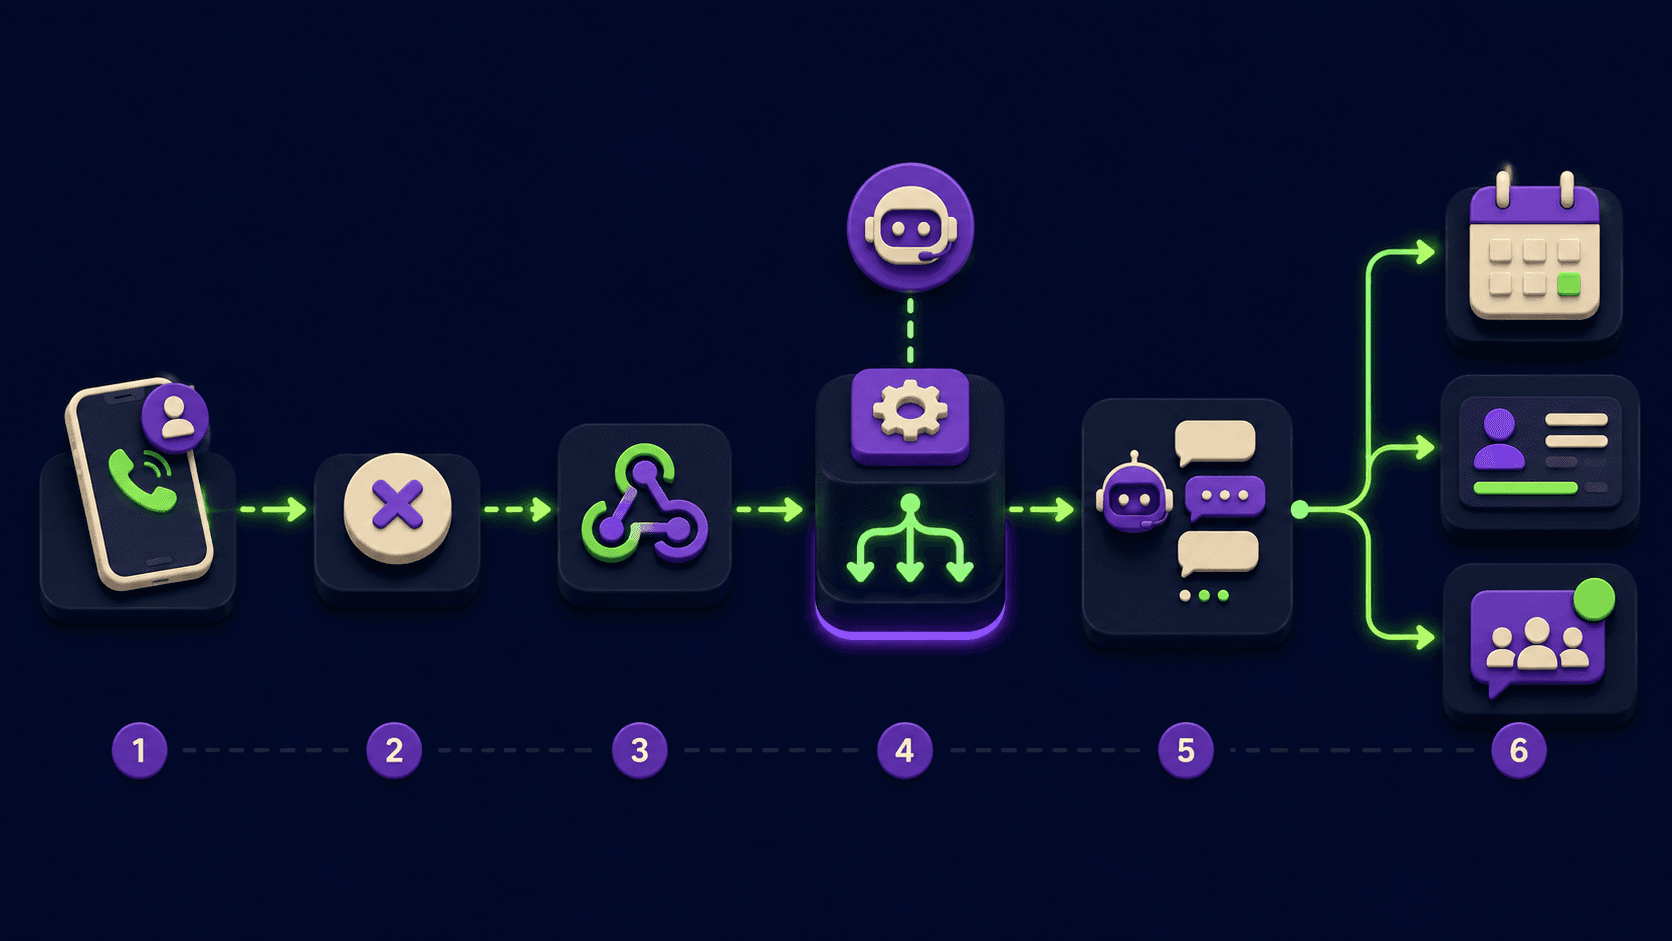
L'architecture de Vapi est un pipeline audio en temps réel qui connecte trois couches de fournisseurs externes : le speech-to-text (transcription), un modèle de langage (raisonnement et génération de réponses) et le text-to-speech (synthèse vocale). Chaque trame audio entrante traverse ce pipeline de manière séquentielle, et Vapi gère l'orchestration : détection du moment où l'utilisateur cesse de parler, suppression des faux positifs (bruit de fond, respiration), routage de la transcription vers le LLM, injection des résultats d'appels de fonctions si l'agent doit interroger une API externe, et conversion de la réponse du LLM en audio avec le fournisseur vocal choisi avant de la renvoyer dans l'appel.
La plateforme prend en charge plus de 100 langues avec détection et adaptation automatiques. La gestion des conversations simultanées évolue selon le forfait : le niveau pay-as-you-go est limité à 10 appels simultanés ; les forfaits Enterprise sont illimités. L'appel de fonctions permet aux agents d'interroger des CRM (Salesforce, HubSpot), des systèmes de billetterie (Zendesk), des bases de données ou n'importe quelle API REST pendant un appel en direct, les résultats étant injectés dans le contexte de la conversation. Des webhooks se déclenchent au début et à la fin de l'appel, à la fin de la transcription et lors des événements d'appel de fonctions, ce qui facilite la synchronisation en temps réel des données de conversation avec les systèmes en aval.
Le tableau de bord propose un constructeur d'assistants no-code pour le prototypage, mais toute la puissance de la plateforme réside dans l'API. Vous pouvez créer et configurer des assistants de manière programmatique, gérer des numéros de téléphone, lancer des campagnes d'appels, extraire des transcriptions et accéder aux enregistrements via l'API REST. La prise en charge des tests A/B permet aux équipes d'exécuter des variantes parallèles sur la voix, le prompt et la configuration du modèle, et de comparer les taux de conversion ou de résolution sur un échantillon d'appels.
"Une exigence technique clé était la possibilité d'apporter notre propre pile. L'approche API-first de Vapi, pensée pour les développeurs, a rendu cela possible." - Quang Tran, CTO chez FleetWorks, vapi.ai, avril 2026
En décembre 2024, Byron Deeter, partenaire chez Bessemer, a cité "l'amélioration par 10x de l'expérience de développement pour les agents vocaux" de Vapi comme principale thèse d'investissement, soulignant un modèle audio propriétaire en temps réel qui détecte les inflexions émotionnelles dans la voix des appelants. L'entreprise se positionne explicitement comme une infrastructure dans la tradition de Twilio/AWS : "nous fabriquons le moteur qui alimente la magie". Des demandes de fonctionnalités soumises le vendredi soir auraient été déployées en production dès le samedi matin, une cadence qui a fidélisé la communauté lors de la phase de croissance initiale.
Où se situe Vapi par rapport à Retell AI et Bland AI
Vapi vs. Retell AI : Retell est une plateforme gérée et packagée. Elle fournit une pile tout-en-un incluant la transcription, une sélection d'intégrations LLM, des connecteurs CRM natifs et la fourniture intégrée de numéros de téléphone dans de nombreux pays. Les utilisateurs paient un tarif unique à la minute commençant autour de $0.07/min qui couvre conjointement le STT, le LLM et le TTS. Pas de contrats séparés avec Deepgram ou ElevenLabs. L'approche gérée de Retell élimine la latence des API multi-sauts que la couche d'orchestration de Vapi introduit lorsqu'un fournisseur externe est lent. Les tests ont montré que Retell atteint une latence de bout en bout de 500-800ms de manière plus constante, tandis que la plage de Vapi s'étend jusqu'à 1200ms selon les fournisseurs LLM et TTS que vous avez connectés. La différence pratique : Retell est plus rapide à déployer et plus facile à budgétiser ; Vapi est plus flexible pour les équipes disposant d'une pile de modèles existante. Si vous avez affiné votre propre LLM ou si vous avez déjà un accord d'entreprise avec ElevenLabs, Vapi vous permet de l'intégrer directement sans avoir à tout reconstruire. Retell vous enferme dans son ensemble de fournisseurs pris en charge.
Vapi vs. Bland AI : Bland est intégré verticalement. L'entreprise auto-héberge l'intégralité de sa pile de modèles affinés dans des clusters colocalisés à côté de l'infrastructure de téléphonie, éliminant totalement les sauts d'API externes. Ce choix architectural rend la latence de Bland plus constante, entre 600-1000ms, indépendamment des pics de trafic sur OpenAI ou Anthropic, car ces sauts n'existent pas. Vapi peut atteindre une latence de 3-4 secondes lors des pics de charge des fournisseurs externes. Bland fournit également des outils avancés de gestion de campagnes conçus explicitement pour les appels sortants à fort volume : traitement par lots, planification, logique de relance et une interface de flux de conversation basée sur des graphes. La tarification de Bland est plus simple : un tarif à la minute avec des remises sur volume. Vapi nécessite de gérer 4 à 6 relations fournisseurs. La distinction : Bland est conçu pour le remplacement des centres de contact d'entreprise à grande échelle avec un modèle commercial simple ; Vapi est conçu pour les équipes de développeurs qui ont besoin d'une flexibilité maximale des fournisseurs et d'une orchestration programmable. Si votre cas d'usage principal est de 100,000 appels sortants par mois vers une liste de contacts, l'infrastructure de Bland est spécialement conçue pour cela. Si vous devez changer de LLM selon le cas d'usage, tester de nouveaux modèles vocaux ou router différents types d'appels vers différents niveaux de modèles, l'architecture modulaire de Vapi justifie sa complexité.
"Le support est inexistant et la documentation est extrêmement pauvre. Ils ont déployé de nouvelles fonctionnalités et TOUT a cassé." - Utilisateur vérifié, Trustpilot/Product Hunt, 2025
À quoi ressemble la réalité quotidienne du développement
Un déploiement Vapi en production implique généralement la configuration de comptes auprès de trois à cinq fournisseurs externes avant même d'écrire une ligne de logique d'agent. Au minimum : un compte Twilio ou Telnyx pour la téléphonie, un compte Deepgram ou Azure pour le STT, et un compte OpenAI ou Anthropic pour le LLM. Si vous souhaitez une voix non synthétisée, ajoutez un compte ElevenLabs. Chacun a sa propre facturation, sa gestion des clés API et ses limites d'utilisation. Le tableau de bord de Vapi consolide la configuration, mais les factures arrivent séparément.
Une fois les fournisseurs connectés, vous configurez un assistant via le tableau de bord ou l'API : définition du prompt système, choix des modèles STT/LLM/TTS, configuration de la sensibilité aux interruptions, définition des outils (fonctions que l'agent peut appeler) et configuration des webhooks. La fonction d'appel test du tableau de bord vous permet d'appeler l'agent via un navigateur. L'API de création d'assistants est propre et bien documentée ; les développeurs l'utilisent couramment pour créer des modèles d'assistants destinés aux déploiements d'agences multi-clients.
L'ajustement de la latence est la partie la plus exigeante techniquement lors de l'utilisation de Vapi. La latence de bout en bout inférieure à 500ms revendiquée par la plateforme nécessite une sélection minutieuse de modèles à faible latence (GPT-4o-mini plutôt que GPT-4o, Deepgram Nova plutôt que Nova-2, etc.) et ne tient pas lors des pics de trafic des fournisseurs externes. Lors de tests indépendants sur softailed.com, abaisser la sensibilité aux interruptions en dessous de 750ms a poussé l'assistant à interrompre les appelants au milieu d'une phrase. Les développeurs ajustent généralement la latence pour leur cas d'usage spécifique et leur combinaison de modèles plutôt que de s'attendre à ce que cela fonctionne parfaitement d'emblée.
La boucle de test et d'itération est fonctionnelle mais limitée par rapport à Retell. Les tests d'évaluation générés automatiquement renvoient des résultats de réussite/échec sans suggestions d'optimisation exploitables. Le constructeur de flux de travail ne prend pas en charge l'appel d'autres assistants au sein du même flux, ce qui est important pour les architectures multi-agents. L'historique des appels et la récupération des transcriptions sont limités à 14 jours pour les forfaits non-Enterprise.
À qui s'adresse Vapi
Vapi convient aux équipes dirigées par des développeurs qui ont besoin d'un contrôle full-stack sur leur infrastructure d'agents vocaux. La plateforme récompense les équipes qui disposent déjà de modèles LLM affinés qu'elles souhaitent exploiter, d'accords existants avec des fournisseurs TTS ou STT spécifiques, ou de cas d'usage nécessitant le routage de différents types d'appels vers différents niveaux de modèles. Les agences qui créent des agents vocaux pour plusieurs clients bénéficient de l'approche API-first : vous pouvez créer et configurer des assistants de manière programmatique par client, gérer les paramètres vocaux et de modèles par déploiement, et tout exécuter via un seul compte Vapi avec des clés API spécifiques au client.
Les équipes des services de santé et financiers ayant besoin de la conformité HIPAA, SOC2 ou PCI peuvent utiliser le niveau Enterprise, qui inclut les certifications de conformité et un support technique dédié. Les fonctionnalités de tests A/B et de détection automatisée des hallucinations sont véritablement précieuses pour les déploiements dans des secteurs réglementés où la qualité des conversations doit être mesurée et auditée.
Les équipes en phase exploratoire bénéficient d'un point de départ raisonnable : $10 de crédits gratuits couvrent environ 150 à 200 minutes d'appels de test avec des modèles de niveau intermédiaire, ce qui est suffisant pour construire et tester un prototype fonctionnel avant de s'engager dans des contrats multi-fournisseurs.
Ce que Vapi n'est pas
Vapi n'est pas une plateforme no-code. Le constructeur d'assistants du tableau de bord permet un prototypage de base, mais les déploiements en production avec une logique conditionnelle, des appels d'outils en plusieurs étapes ou la construction dynamique de prompts nécessitent un développeur écrivant en TypeScript, Python ou effectuant des appels REST. Si vous avez besoin qu'un non-ingénieur crée et gère des agents vocaux, vous n'êtes pas sur le bon produit.
Vapi n'est pas une plateforme à coût prévisible en dessous du niveau Enterprise. Le tarif annoncé de $0.05/minute correspond aux frais d'orchestration. Les déploiements en production utilisant GPT-4o, ElevenLabs et Twilio se situent régulièrement entre $0.25 et $0.35/minute tout compris. L'analyse de CloudTalk en 2026 estime les dépenses annuelles typiques d'un déploiement d'entreprise entre $40,000 et $70,000 en modélisant des volumes d'utilisation réalistes. L'établissement de projections de coûts réalistes nécessite de modéliser chaque couche de fournisseur séparément avant de s'engager sur la plateforme.
Vapi n'est pas optimisé pour le volume pur d'appels sortants. Bland AI offre de meilleurs outils de campagne, de planification et de gestion par lots pour les scénarios de remplacement de centres de contact. Les capacités de campagne de Vapi nécessitent de construire votre propre couche d'orchestration par-dessus l'API.
Vapi n'est pas fiable lors des pannes de fournisseurs. Étant donné que le pipeline dépend de fournisseurs LLM et STT externes, toute dégradation chez OpenAI, Anthropic, Deepgram ou ElevenLabs se propage directement à la qualité des appels. Les équipes ayant des exigences strictes en matière de SLA de disponibilité devraient soit utiliser le niveau Enterprise avec une infrastructure dédiée, soit évaluer la pile verticalement intégrée de Bland.
Enfin, la fourniture de numéros de téléphone par Vapi est nativement limitée aux États-Unis. Les déploiements hors États-Unis et hors Canada nécessitent l'importation manuelle de numéros Twilio ou Vonage, ce qui ajoute des frictions de configuration pour les cas d'usage internationaux.
Avis des utilisateurs
Aucun avis pour l'instant. Soyez le premier à partager votre expérience !
Se connecter pour écrire un avis.
Articles associés
Guides et articles en lien avec Vapi.
Voice Agent for Missed Calls: Every Service Business Is Bleeding Leads After Hours (2026)
AI Receptionist for Solo Professionals: Replace the Answering Service (2026)

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
How to Sell AI Chatbots to Local Businesses ($1K-$5K Retainers, 2026)
Build a 70-Language Live Voice Agent With GPT-Realtime-Translate (2026)
