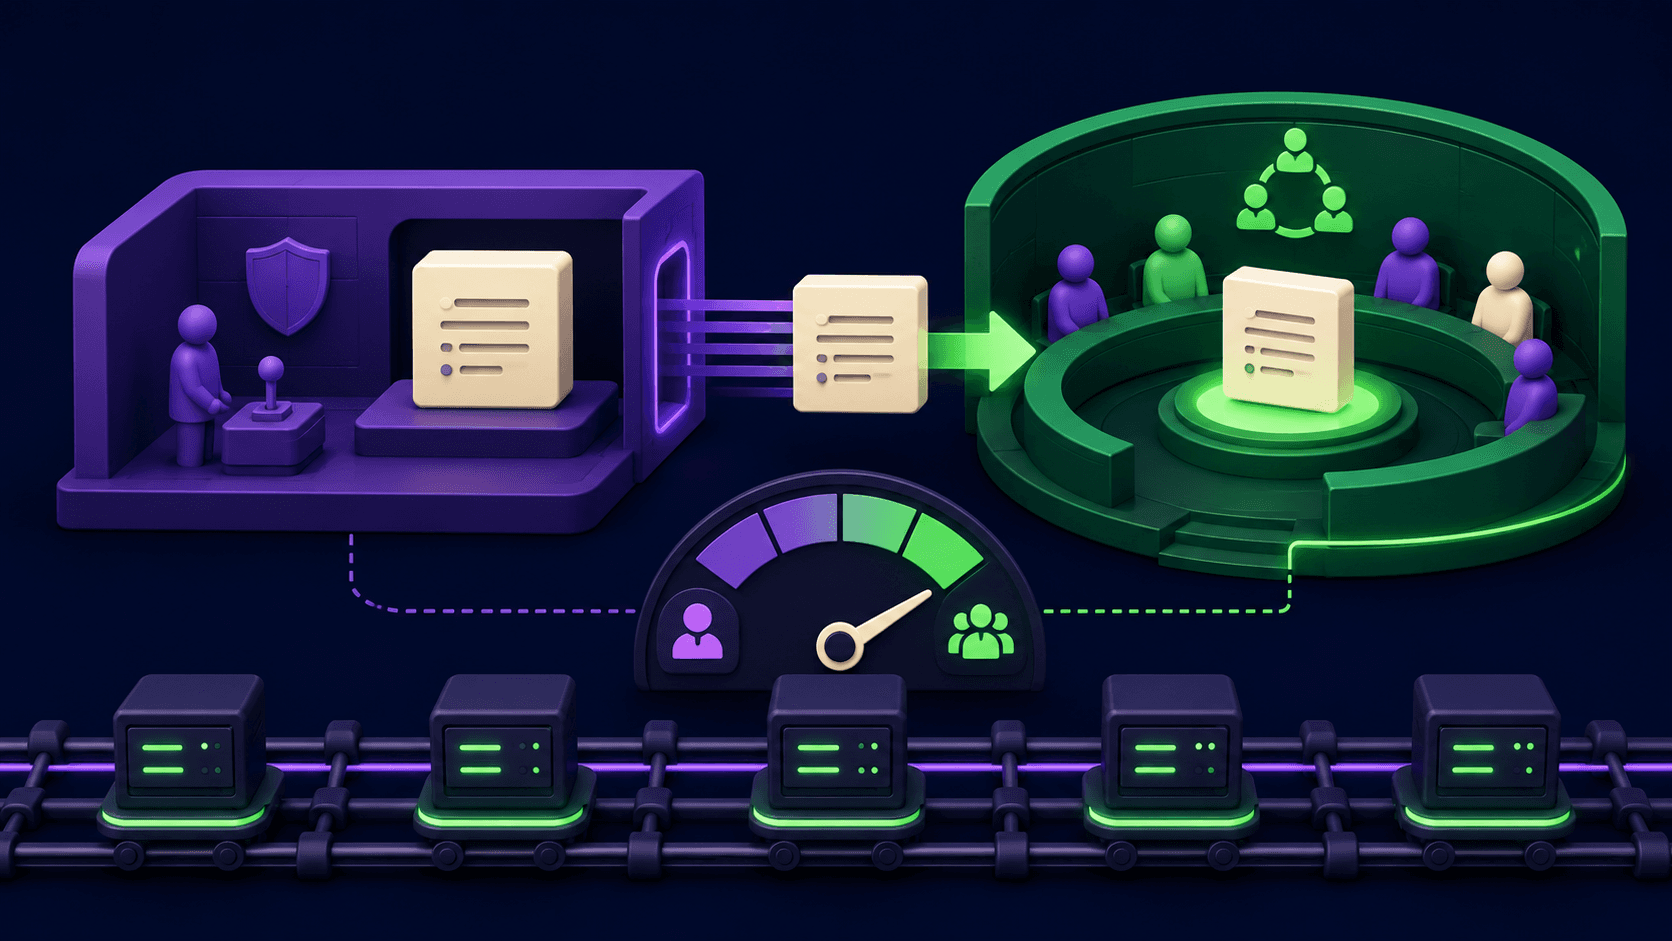
LiteLLM 是由 BerriAI(YC W23)开发的开源 AI 网关,可将 100 多个 LLM 供应商的 API 转换为单一的兼容 OpenAI 的端点。通过自托管代理服务器,可以在 OpenAI、Anthropic、Bedrock 等模型之间进行路由,并内置了支出跟踪、速率限制和回退路由功能。
LiteLLM 是一个开源 AI 网关和 Python SDK,由 Krrish Dholakia 和 Ishaan Jaffer 创立的 Y Combinator 2023 冬季批次公司 BerriAI 开发。该工具解决了一个具体而实际的问题:随着团队在技术栈中引入越来越多的 LLM 供应商,每个供应商都会提供自己的 API 格式、身份验证模型和错误处理机制。LiteLLM 位于所有这些供应商的前端,将每次调用转换为 OpenAI 的格式,因此应用程序代码完全不需要知道它正在与哪个供应商通信。截至 2026 年 4 月,该项目在 GitHub 上已获得 45,400 颗星,拥有 1,000 多名贡献者,据官方报告,其代理基础设施已处理了 10 亿次请求。
该工具提供两种运行模式。Python SDK 允许你在代码中直接调用 litellm.completion(),并自动处理包括 OpenAI、Anthropic、Google Vertex AI、AWS Bedrock、Azure OpenAI、Cohere、Mistral、HuggingFace、NVIDIA NIM、Ollama 和 vLLM 在内的 100 多家供应商的格式转换、重试和回退。代理服务器(Proxy Server)模式是一个通过 Docker 部署的自托管 HTTP 网关:任何现有的 OpenAI SDK 客户端都可以在不修改代码的情况下指向它,代理会处理路由、虚拟 API 密钥管理、团队预算限制、速率限制,以及与 Langfuse 和 Arize Phoenix 等工具的可观测性集成。这两种模式均采用 MIT 许可证并可免费运行。企业治理功能(包括 SSO、RBAC 和审计日志)在付费层级中提供,起价为每月 $250。
2026 年 4 月的 LiteLLM 实际功能
其核心功能是供应商转换。当你的应用程序通过 LiteLLM 发送 Anthropic 格式的请求时,该库会重写输入和输出字段以匹配目标模型的预期,标准化不同供应商的错误代码,并以 OpenAI 的格式返回响应,无论是由哪个模型处理的调用。新供应商通常在其公共 API 发布后的一天内就会被添加,这就是 LiteLLM 能够跟上行业快速扩张步伐并支持超过 100 个端点的原因。
代理服务器通过生产级的访问管理扩展了这一功能。团队可以使用 YAML 文件对其进行配置,定义模型组、每个密钥的预算和路由规则。平台团队可以向各个小组发放虚拟 API 密钥,并在代理层强制执行硬性支出上限、模型白名单和 RPM 限制。当主模型不可用或受到速率限制时,代理会自动回退到配置的备用模型。负载均衡会在同一供应商的多个实例之间分配请求。所有这些操作都在应用程序对路由逻辑毫无感知的情况下进行。
可观测性是通过外部集成而非原生提供的。LiteLLM 将日志路由到 Langfuse、Arize Phoenix、Prometheus 或 OpenTelemetry。然后,团队可以在他们选择的可观测性平台中按团队、密钥或用户可视化成本归属。代理 UI 提供了一个基本的支出仪表板,但生产监控设置通常会将其连接到外部工具,以实现警报和长期数据保留。
“LLM 代理的想法非常吸引人。它可以帮助团队在本地和云端 LLM 之间动态选择,而无需重构其基础设施。” —— jmorgan(Ollama 创始人),Hacker News,2023 年 12 月
Python SDK 通常是开发人员首次接触 LiteLLM 的方式。该接口是一个轻量级封装:安装包,将供应商 API 密钥设置为环境变量,然后调用 litellm.completion(model="gpt-4o", messages=[..])。切换到 Claude 只需要更改模型字符串这一个字段。SDK 处理流式传输、异步调用、Token 计数和每次请求的成本跟踪。使用 LangChain 或 LlamaIndex 进行开发的工程师可以将 LiteLLM 作为底层模型客户端引入,从而在不触及上层框架的情况下实现多供应商路由。
LiteLLM 与 OpenRouter 和 Portkey 的定位对比
在 LLM 网关的讨论中,有三个工具占据主导地位:LiteLLM、OpenRouter 和 Portkey。它们在架构上做出了截然不同的选择,正确的选择取决于你的基础设施理念,而不是功能列表。
OpenRouter 是一个封闭的托管市场。你只需注册,获取一个 API 密钥,即可通过 OpenRouter 的服务器访问 300 多个模型(包括社区微调模型)。OpenRouter 会收取 5.5% 的积分购买费,并与在其市场上列出的模型供应商进行收入分成。你的所有流量都流经 OpenRouter 的基础设施,这意味着零部署开销,但也无法控制数据路由。对于快速原型设计和个人项目,OpenRouter 是访问多模型的最快途径。如果每月 LLM 支出为 $10,000,你需要向 OpenRouter 支付 $550 的费用。你无法自托管、审计其代码或在物理隔离(air-gapped)环境中部署它。它最适合那些需要模型访问权限而非基础设施控制权的开发人员。
Portkey 是一个运行在 Portkey 边缘网络上的封闭式托管网关。它按记录的日志收费(Pro 层级每月约 $49,涵盖 10 万到 300 万次请求),这意味着成本随可观测性使用量而非 Token 数量扩展。Portkey 的差异化优势在于内置的生产级可观测性:托管服务中包含了详细的请求日志、延迟追踪、成本归属、语义缓存和护栏指标,无需外部集成。语义缓存(LiteLLM 的开源层级中明显缺失)使 Portkey 能够为语义相似(而不仅仅是完全相同)的查询提供缓存响应,这在规模化应用时可以显著降低成本。与 OpenRouter 一样,Portkey 不可自托管,且流量流经其基础设施。
LiteLLM 做出了相反的选择:你拥有基础设施和数据。MIT 许可证意味着你可以审计代码,在受监管的环境中部署它,并在流量永远不会接触第三方服务器的物理隔离设置中运行它。除了你明确配置的对 LLM 供应商的直接调用外,没有任何数据会离开你的网络。代价是运维负担。运行生产级 LiteLLM 实例需要管理 PostgreSQL、Redis、数据库迁移、备份和连接池。在不考虑 DevOps 人工成本的情况下,一个实际的生产环境基础设施成本约为每月 $2,000 到 $2,300。一旦 LLM 支出超过每月约 $10,000,LiteLLM 就会成为比 OpenRouter 更具成本优势的明显赢家,但前提是你的团队有能力维护该技术栈。
“切换供应商只需更改一行代码。这是它的核心承诺,而且对于大多数供应商来说,它确实做到了。” —— aicoolies.com 评论员,2025 年
同时使用 OpenRouter 和 LiteLLM 的开发人员通常使用 OpenRouter 来访问社区和实验性模型,同时通过自托管的 LiteLLM 实例路由生产流量以满足合规性要求。两者并不互斥:LiteLLM 可以将 OpenRouter 作为其配置的供应商之一进行代理。对于已经使用 Helicone 进行可观测性的团队,LiteLLM 可以作为路由层共存,而 Helicone 则负责处理日志记录。
代理的日常实际运行情况
设置过程非常快。一个可用的本地实例在十分钟内即可运行:通过 pip 安装,创建一个列出你的模型及其供应商凭证的配置 YAML 文件,运行 litellm --config config.yaml,任何访问 localhost:4000 的兼容 OpenAI 的客户端现在都会通过代理进行路由。Docker Compose 设置只需再花十分钟即可添加 Postgres 和 Redis,以实现持久化和缓存。
YAML 配置是团队花费大部分时间的地方。模型组定义了回退链。路由器设置控制负载均衡是采用轮询、最少连接还是延迟加权策略。预算密钥按团队发放,并设有硬性上限和软性警报。对于在整个公司内标准化 LLM 访问的平台团队来说,此配置将成为所有 AI 支出的核心策略文档。
在中等请求量(每天低于 100,000 次请求)下,代理在很大程度上是透明的。大多数调用的延迟开销极小。回退路由、预算强制执行和特定于供应商的重试逻辑无需干预即可正常工作。
在更高请求量下,数据库会成为瓶颈。LiteLLM 在请求路径中同步将请求日志写入 PostgreSQL。当累积日志行数超过一百万时,官方文档也承认 API 响应时间可能会下降。有团队报告称,由于数据库写入序列化的开销,即使缓存命中只需一毫秒的缓存请求,仍会返回 10 秒以上的端到端延迟。运维上的变通方法是禁用详细日志记录或对数据库进行分片,但这违背了内置支出跟踪的初衷。这种架构限制促使一些高吞吐量团队转向基于更快运行时的替代方案(如 Bifrost 等基于 Go 的代理正是为了解决这个问题而出现的)。
使用 AnythingLLM 或其他智能体框架构建的 AI 智能体可以将 LiteLLM 代理作为其模型后端,这使平台团队能够集中查看由智能体发起的 LLM 支出,而无需对每个智能体进行 API 密钥管理。
LiteLLM 适合哪些用户
LiteLLM 最适合那些为多个内部小组管理 LLM 访问权限、处理不能流经第三方基础设施的受监管数据,或者 LLM 支出规模足以证明自托管成本合理性的平台和后端工程团队。为了提高弹性而在多个供应商上构建 AI 产品的公司(例如将 Claude 作为主模型,GPT-4o 作为备用模型,Bedrock 作为企业要求的选项)能从该网关的路由和回退逻辑中获得最大收益。
在不同模型间进行原型设计的 AI 工程师将 Python SDK 作为一个“先试后买”层:基于 litellm.completion() 接口进行构建,并在不触及应用程序逻辑的情况下切换供应商。在产品的早期阶段,当仍在评估适合特定任务的模型时,这非常实用。
医疗保健、金融或其他受监管行业的组织非常看重物理隔离部署选项以及审计完整代码库以确保合规性的能力。自托管模式意味着你可以向审计人员证明,敏感的提示词数据永远不会接触第三方服务器。
LiteLLM 不适合哪些场景
LiteLLM 不适合个人、独立开发者或小型团队。其基础设施开销、对 PostgreSQL 和 Redis 的依赖、YAML 配置模型以及运维负担,都是为具备 DevOps 能力的工程团队量身定制的。如果开发者只是想从同一个代码库中调用 Claude 和 GPT-4o,那么单独使用 Python SDK(不使用代理)或 OpenRouter 的零设置托管选项会是更好的选择。
如果你需要无需额外集成工作即可使用的内置语义缓存,请跳过 LiteLLM。OpenAI 格式的缓存(精确匹配)是可以工作的;但语义相似的查询去重需要你自己接入外部层。对于将可观测性作为首要需求的团队来说,在中低请求量下,Portkey 的托管技术栈能提供更高的性价比。
2026 年 3 月的 PyPI 供应链事件是任何评估 LiteLLM Python 包的团队都需要了解的相关背景。版本 1.82.7 和 1.82.8 被“TeamPCP”威胁行为者组织通过 BerriAI 的 CI/CD 管道中被投毒的 Trivy 安全扫描器入侵。这些恶意包会收集 SSH 密钥、云凭证和 Kubernetes 令牌,在 2026 年 3 月 24 日上线了大约 40 分钟后被 PyPI 隔离。BerriAI 的回应非常透明:Krrish Dholakia 和 Ishaan Jaffer 发布了公开的时间表,聘请了 Google 的 Mandiant 团队进行取证分析,轮换了所有凭证,并通过加固的 CI/CD 管道发布了干净的版本。运行官方 Docker 镜像的客户未受影响。直接从 PyPI 安装的团队应将版本固定在 v1.83.0 或更高版本,并在升级前验证发布管道。
LiteLLM 也不托管模型。它是一个路由和转换层,而不是计算提供商。通过 Ollama 或 vLLM 运行本地推理的团队可以将 LiteLLM 指向这些服务器,但 LiteLLM 本身没有 GPU 基础设施。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 LiteLLM 的精选合集。
相关文章
与 LiteLLM 相关的指南和文章。

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing