
SWE-Agent هو وكيل هندسة برمجيات مستقل مفتوح المصدر من Princeton University يستخدم واجهة وكيل-حاسوب (Agent-Computer Interface) مخصصة لحل مشكلات GitHub، وإصلاح الأخطاء، ومعالجة تحديات الأمن السيبراني. مجاني، ومرخص بموجب MIT، ومستقل عن النماذج (model-agnostic).
SWE-Agent هو وكيل هندسة برمجيات مستقل صممه باحثون في Princeton University و Stanford University. تم إصداره في عام 2024 وعُرض في NeurIPS 2024، حيث تأخذ الأداة رابط مشكلة من GitHub وتحاول كتابة تصحيح (patch) لحلها، باستخدام أي نموذج لغوي توفره. يتولى صيانة المشروع كل من John Yang و Carlos Jimenez و Kilian Lieret و Ofir Press تحت مظلة مجموعة Princeton NLP group. الأداة مجانية، ومرخصة بموجب MIT، وتعمل بالكامل على بنيتك التحتية الخاصة.
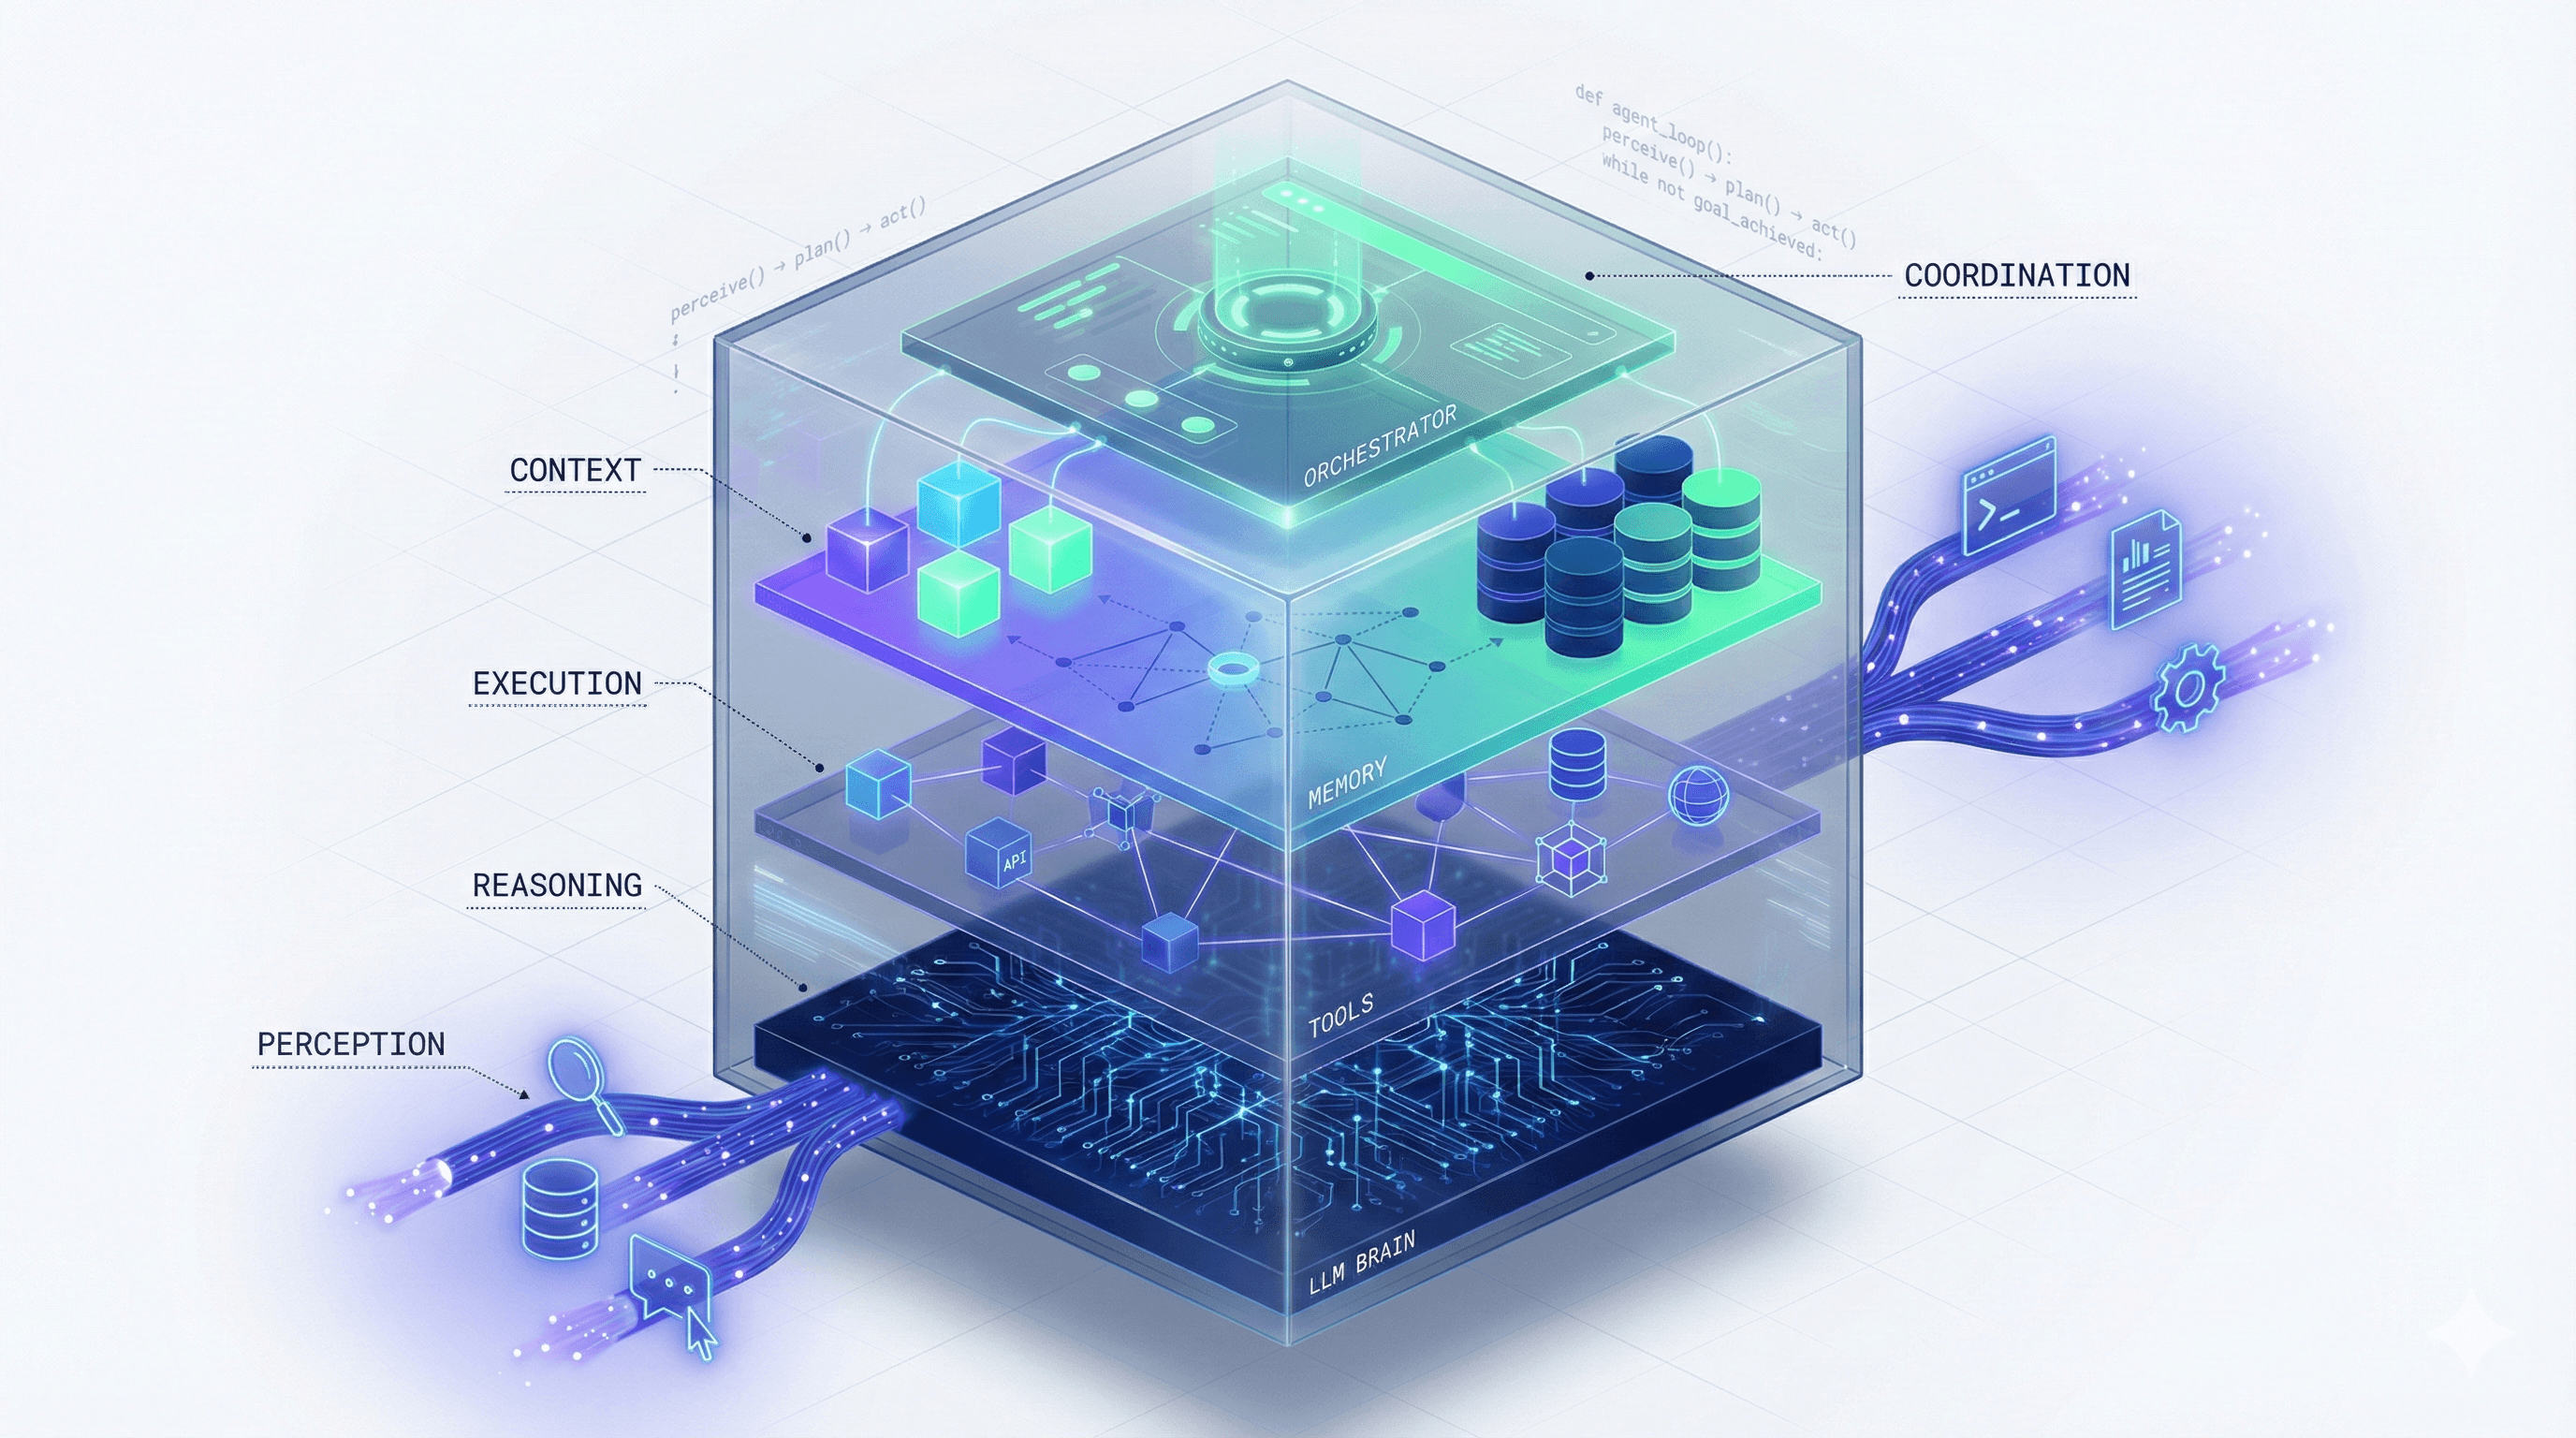
الفكرة الأساسية للوكيل هي واجهة الوكيل-الحاسوب (ACI)، وهي طبقة تجريد مصممة خصيصاً لاستبدال الوصول المباشر إلى سطر الأوامر (shell) بأوامر منظمة ومحسنة لطريقة معالجة النماذج اللغوية للمعلومات. يتم عرض عمليات عرض الملفات والبحث والتحرير كعمليات موجزة ومحدودة بدلاً من استدعاءات طرفية (terminal) مفتوحة. يحقق نفس نموذج GPT-4 ضعف النتيجة تقريباً على SWE-bench عند تزويده بأدوات ACI مقارنة باستخدام bash المباشر، وهي نتيجة تم تفصيلها في ورقة NeurIPS 2024. وبعيداً عن حل المشكلات، يتضمن SWE-Agent وضع EnIGMA لمهام الأمن السيبراني الهجومية، ويدعم المعالجة المجمعة (batch processing)، والتكوين الكامل المستند إلى YAML، وبيئة تشغيل SWE-ReX للتنفيذ السحابي المتوازي. يحقق متغير المشروع mini-SWE-agent، المكون من حوالي 100 سطر من كود Python، أكثر من 74% على SWE-bench Verified باستخدام نموذج متطور حديث.
ما يفعله SWE-Agent فعلياً في مايو 2026
في جوهره، يقبل SWE-Agent رابط مشكلة من GitHub ومفتاح API للنموذج، ثم يُشغّل حلقة مستقلة تقرأ المستودع، وتعيد إنتاج الخطأ، وتعدل الكود، وتختبر الإصلاح. يتم توجيه حلقة الوكيل بواسطة ACI: حيث يتم تقييد كل عملية عرض للملفات لمنع تجاوز سياق النموذج (context overflow)، وتمر التعديلات عبر أداة فحص (linter) تتراجع تلقائياً عن الصياغة الخاطئة، ويتم تتبع حالة الوكيل (الملف الحالي، موضع المؤشر) بواسطة بيئة التشغيل بدلاً من استنتاجها من سجل المحادثة.
الإصدار المستقر الحالي هو v1.1.0 (22 مايو 2025)، والذي قدم توليد مسارات SWE-smith ونموذج الأوزان المفتوحة SWE-agent-LM-32b. تدعم البنية أي نموذج لغوي كبير (LLM) من خلال litellm، بما في ذلك OpenAI و Anthropic و Google والنماذج المحلية. تتم معالجة التنفيذ المتوازي بواسطة SWE-ReX، والذي يمكنه توجيه عمليات التشغيل المعزولة (sandboxed) إلى خلفيات Docker أو AWS أو Modal أو Fargate. تُنتج كل عملية تشغيل ملف مسار منظم (trajectory file) مناسب لإعادة التشغيل البحثي، أو الضبط الدقيق (fine-tuning)، أو التدقيق.
يُعد EnIGMA، الذي تم تقديمه في الإصدار v0.7.0 (سبتمبر 2024)، وضعاً منفصلاً لتحديات الأمن السيبراني من نوع "التقط العلم" (CTF). يضيف هذا الوضع أدوات وكيل تفاعلية (Interactive Agent Tools) ومُلخِّصاً للتعامل مع المخرجات الطرفية الطويلة من نصوص الاستغلال البرمجية، محققاً تحسناً بمقدار 3.3 ضعف مقارنة بالوكلاء السابقين على معيار NYU CTF. تم تقديم EnIGMA كورقة بحثية منفصلة في ICML 2025.
يتبنى مشروع mini-SWE-agent، الذي تم إصداره في منتصف عام 2025، فلسفة معاكسة: تجريد كل شيء وصولاً إلى أداة bash واحدة وحلقة ReAct بسيطة. يحقق أكثر من 74% على SWE-bench Verified باستخدام Gemini أو Claude، مما يطابق أداء الوكيل الكامل مع كود أقل بـ 100 مرة. بالنسبة للمستخدمين الجدد الذين يريدون نتائج بدون تكوين YAML، يوصي فريق Princeton الآن بالبدء باستخدام mini-SWE-agent بدلاً من إطار العمل الكامل.
"إن إدراك أن bash هو كل ما يحتاجه نموذج LLM حديث لحل مهام البرمجة هو أمر مشجع للغاية. إنه مفيد جداً وملهم للبدء في البرمجة." - scottyeager، Hacker News، يوليو 2025
موقع SWE-Agent مقارنة بـ OpenHands و Aider
يهيمن ثلاثة وكلاء برمجة مفتوحي المصدر على لوحات الصدارة البحثية: SWE-Agent و OpenHands و Aider. يشتركون في نفس المهمة ولكنهم يختلفون ميكانيكياً في كل بُعد تقريباً.
SWE-Agent مقابل OpenHands: يعمل OpenHands داخل حاويات Docker ببنية تدفق الأحداث (event-stream): يُنتج الوكيل إجراءات (Actions)، وتنفذها البيئة وتُرجع ملاحظات (Observations)، وتستمر الحلقة. تحصل كل جلسة على وصول SSH، ونواة Jupyter لتنفيذ Python، وواجهة BrowserGym لأتمتة الويب. تفويض الوكلاء المتعددين مدمج أصلياً: يمكن لوكيل رئيسي إنشاء وكلاء فرعيين لمهام فرعية محددة ودمج نتائجهم. يوفر OpenHands أيضاً واجهة مستخدم ويب مصقولة وإضافة VSCode. لا يمتلك SWE-Agent أياً من ذلك. فهو يعمل عبر واجهة سطر الأوامر (CLI) فقط، ولا يحتوي على واجهة مستخدم ويب، ودعمه للوكلاء المتعددين لا يزال تجريبياً. ما يمتلكه SWE-Agent ويفتقر إليه OpenHands هو وضع الأمن السيبراني EnIGMA، وسطح تكوين YAML أعمق للباحثين، ومحرك التنفيذ المتوازي SWE-ReX. يناسب OpenHands الفرق التي تريد مطوراً مستقلاً متعدد الأغراض. بينما يناسب SWE-Agent الباحثين والمطورين الذين يريدون التحكم في كل جزء من حلقة الوكيل.
SWE-Agent مقابل Aider: يعتمد Aider على نهج git أولاً: يصبح كل تعديل التزاماً (commit) مُسمى ومُلتزماً به تلقائياً في سجل مستودعك. يعمل Aider بشكل تفاعلي من الوحدة الطرفية (terminal)، ويتفوق في التعاون المتبادل مع المطور، ويستخدم رموزاً (tokens) أقل بحوالي 4.2 مرة لكل مهمة لأنه يظل سطحياً في سياق المستودع. يعمل SWE-Agent بشكل غير تفاعلي في الوضع المستقل، ويُنشئ مسارات منظمة، ولديه سقف أعلى بكثير في SWE-bench لأن ACI يسمح باجتياز أعمق للمستودع. يُعد Aider أفضل لجلسات البرمجة المزدوجة والمتكررة. بينما يُعد SWE-Agent أفضل لحل المشكلات المؤتمت بالكامل وغير المتزامن بدون تدخل المطور. لا يمتلك أي منهما وضعاً للأمن السيبراني؛ حيث يظل ذلك ميزة فريدة لمتغير EnIGMA الخاص بـ SWE-Agent.
في السياق التجاري، يتفوق كل من SWE-Agent و OpenHands بشكل كبير على Devin من حيث السعر (مجاني مقابل الفوترة لكل ACU) مع مطابقة أو تجاوز أدائه في المعايير. يشغل Cursor و Cline مكانة مختلفة، حيث يركزان على الإكمال التلقائي والدردشة المدمجة في بيئة التطوير المتكاملة (IDE) بدلاً من حل المشكلات المستقل، لذا فهما يكملان SWE-Agent بدلاً من التنافس معه بشكل مباشر.
"يختبر SWE-bench حل المشكلات في مستودعات Python فقط، مما يحد من القيمة التنبؤية لسيناريوهات العالم الحقيقي عبر اللغات وأنواع المهام." - ToolHalla AI، تحليل مقارن، 2026
كيف يبدو واقع حلقة الوكيل
يتبع تشغيل SWE-Agent نمطاً ثابتاً. تقوم بالتثبيت عبر pip install sweagent، وتعيين مفتاح API الخاص بنموذج LLM في متغيرات البيئة، واستدعاء واجهة سطر الأوامر (CLI) مع رابط مشكلة GitHub والنموذج الذي اخترته. يقوم الوكيل باستنساخ المستودع في بيئة معزولة (sandbox)، ويقرأ المشكلة، ويستكشف الملفات ذات الصلة من خلال أوامر ACI، ويُجري تعديلات مستهدفة، ويحاول تشغيل مجموعة الاختبار. تُنتج عملية التشغيل ملف تصحيح (patch) وسجل مسار.
تصميم ACI هو ما يفصل بين التشغيل الناجح والفاشل. في المستودعات ذات المشكلات الواضحة والمحددة جيداً وتغطية اختبار Python، يحل الوكيل جزءاً كبيراً من المشكلات دون تدخل بشري. أما في المشكلات الغامضة ("تعطل على جهازي")، فإن الوكيل إما يفشل بشكل نظيف أو يُنتج تصحيحاً معقولاً ولكنه غير مكتمل. يُظهر معيار SWE-bench-Live، الذي يختبر مشكلات جديدة تماماً بدون تلوث في مجموعة البيانات، أن كلاً من SWE-Agent و OpenHands يحققان حوالي 18-20%، وهي فجوة واقعية مقارنة بأرقام 70%+ في المعايير المنسقة. يتطلب الاستخدام الفعلي في الإنتاج مراجعة بشرية لكل تصحيح مقترح.
قدم إصدار SWE-Agent 1.0 في فبراير 2025 محرك SWE-ReX، مما جعل التقييم المتوازي عملياً. يمكن للباحثين الآن تشغيل مئات المحاولات لحل المشكلات في وقت واحد عبر خلفيات Modal أو AWS. بالنسبة للفرق التي تقيّم جودة الوكيل على نطاق واسع، فإن هذا يقضي على عنق الزجاجة الزمني الذي جعل التنفيذ التسلسلي الأصلي غير عملي لقوائم المهام الكبيرة.
تُعد تكلفة الرموز (Token cost) حالة عدم يقين متكررة. لا يعرض SWE-Agent تقديرات التكلفة لكل عملية تشغيل قبل التنفيذ. تعتمد التكلفة كلياً على اختيار النموذج، وتعقيد المشكلة، وعدد دورات ACI التي يتخذها الوكيل. يُبلغ المستخدمون المتمرسون عن متوسط مئات الآلاف من الرموز لكل مشكلة معقدة باستخدام Claude أو GPT-4o، وهو ما يُترجم إلى 1-5 دولارات لكل مشكلة بأسعار API الحالية. بالنسبة للمعالجة المجمعة، يوصي الفريق باستخدام واجهات برمجة التطبيقات المجمعة (batch APIs) على مستوى المزود لخفض التكاليف بنسبة 50%.
قدمت ترقية v1.0 أيضاً تغييرات جذرية (breaking changes) فاجأت بعض المستخدمين. تمت إعادة تسمية حقل messages في بيانات المسار إلى query، وتمت إعادة تسمية حزم الأدوات، وتغيرت بنية الأوامر الفرعية لـ CLI بشكل كبير. احتاجت الفرق التي تُشغّل SWE-Agent كجزء من مسارات التقييم إلى تحديث أدواتها. وثّق الفريق التغييرات في ملاحظات الترحيل، لكن هذا التغيير المستمر كان تكلفة حقيقية لأي شخص لا يتابع المستودع عن كثب. يُعد الانضباط في الإصدارات أمراً مهماً مع SWE-Agent أكثر من معظم الأدوات مفتوحة المصدر لأن وتيرة البحث سريعة ويُعطي الفريق الأولوية لتحسينات المعايير على استقرار واجهة برمجة التطبيقات (API).
لمن تم بناء SWE-Agent
تم بناء SWE-Agent للباحثين في المقام الأول. يشير نظام تكوين YAML، وتسجيل المسارات، ودعم حزم الأدوات المخصصة، والنسب الأكاديمي للورقة البحثية، إلى أداة تتوقع من مستخدميها قراءة الوثائق وتعديل المصدر. تعكس نجوم GitHub البالغ عددها 19,100 والاستشهادات من IBM و NVIDIA و Meta و Nebius و Anyscale هذا الجمهور. يتم اعتماده على نطاق واسع في مختبرات أبحاث التعلم الآلي (ML) كخط أساس يجب التغلب عليه لتصميمات الوكلاء الجديدة.
وبعيداً عن البحث، يناسب SWE-Agent المطورين المستقلين والفرق الصغيرة التي ترغب في فرز المشكلات بشكل مستقل. سير العمل هو: تزويد الوكيل بقائمة متراكمة من مشكلات GitHub المصنفة، ومراجعة التصحيحات التي يُنشئها، ودمج تلك التي تجتاز التكامل المستمر (CI). هذا ليس حلاً جاهزاً للاستخدام الفوري (turnkey)، فهو يتطلب الإلمام بمجموعة الاختبار الخاصة بك والمراجعة الدقيقة، ولكنه سير عمل حقيقي تُبلغ الفرق أنه يوفر ساعات أسبوعياً في إصلاحات الأخطاء المحددة جيداً.
يفتح EnIGMA شريحة مستخدمين مميزة: الباحثين الأمنيين ومنافسي CTF. التحسن بمقدار 3.3 ضعف في تحديات NYU CTF ونتائج CyBench يجعله أحد أقوى أدوات اختبار الاختراق الآلية المتاحة مجاناً. تُعد الفرق الأمنية في الجامعات والشركات الموجهة نحو الأبحاث هي المتبني الأساسي هنا.
ما لا يمثله SWE-Agent
لا يُعد SWE-Agent منتجاً للمستخدمين غير التقنيين. لا توجد واجهة مستخدم ويب مستضافة، ولا يوجد تثبيت بنقرة واحدة لغير المطورين، ولا يوجد دعم عملاء يتجاوز مشكلات GitHub ومجتمع Discord. إذا كانت معايير التقييم الخاصة بك تتضمن واجهة مصقولة، فابحث عن OpenHands بدلاً من ذلك.
إنه ليس مساعد برمجة مستمر. على عكس الوضع التفاعلي في Aider أو الأدوات المستندة إلى IDE مثل Cursor، لا يمتلك SWE-Agent ذاكرة بين عمليات التشغيل. يبدأ الوكيل من جديد مع كل استدعاء. سيصاب المستخدمون الذين يتوقعون منه تجميع المعرفة حول قاعدة التعليمات البرمجية الخاصة بهم عبر الجلسات بخيبة أمل. توجد حلول بديلة (توفير سياق المشروع في تكوين YAML)، ولكنها يدوية.
إنه ليس بديلاً عن حكم المطور على جودة التصحيح. يُعد أداء SWE-bench Verified في أواخر السبعينيات مثيراً للإعجاب، ولكن هذه المعايير منسقة. تؤدي مستودعات العالم الحقيقي ذات التغطية الاختبارية الجزئية، والمواصفات الغامضة، والتبعيات عبر اللغات إلى خفض الأداء بشكل كبير. يجب أن يجتاز كل تصحيح من SWE-Agent يذهب إلى الإنتاج مسار التكامل المستمر (CI) الخاص بك وأن يتلقى مراجعة بشرية للكود.
إنه ليس منتجاً تجارياً مزوداً باتفاقيات مستوى الخدمة (SLAs) من البائع، أو دعماً للمؤسسات، أو شهادات امتثال. بالنسبة للفرق التي تحتاج إلى وقت تشغيل مضمون، أو مسارات تدقيق، أو تكامل تسجيل الدخول الموحد (SSO)، فإن فئة المؤسسات من Devin أو بديل مُدار سيكون أكثر ملاءمة.
تقييمات المستخدمين
لا توجد تقييمات بعد. كن أول من يشارك تجربته!
سجّل الدخول لكتابة تقييم.
ظهرت في مجموعات
قوائم منتقاة تتضمّن SWE-Agent.
مقالات ذات صلة
أدلة ومقالات ذات صلة بـ SWE-Agent.

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
SWE-bench Pro Explained: Why the Benchmark Changed (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC