LiteLLM es un gateway de IA de código abierto creado por BerriAI (YC W23) que traduce las API de más de 100 proveedores de LLM en un único endpoint compatible con OpenAI. Aloja tú mismo el servidor proxy para enrutar entre OpenAI, Anthropic, Bedrock y más, con seguimiento de gastos, limitación de tasa y enrutamiento de respaldo integrados.
LiteLLM es un gateway de IA de código abierto y un SDK de Python creado por BerriAI, una empresa de Y Combinator Winter 2023 fundada por Krrish Dholakia e Ishaan Jaffer. La herramienta resuelve un problema específico y concreto: a medida que los equipos añaden más proveedores de LLM a su stack, cada proveedor incluye su propio formato de API, modelo de autenticación y comportamiento de errores. LiteLLM se sitúa frente a todos ellos y traduce cada llamada al formato de OpenAI, por lo que el código de la aplicación nunca tiene que saber con qué proveedor se está comunicando. Para abril de 2026, el proyecto ha alcanzado 45,400 estrellas en GitHub, más de 1,000 colaboradores y mil millones de solicitudes atendidas a través de su infraestructura proxy, según sus propios informes.
La herramienta se ofrece en dos modos. El SDK de Python te permite llamar a litellm.completion() directamente en el código y gestiona la traducción de formatos, los reintentos y los respaldos automáticamente en más de 100 proveedores, incluyendo OpenAI, Anthropic, Google Vertex AI, AWS Bedrock, Azure OpenAI, Cohere, Mistral, HuggingFace, NVIDIA NIM, Ollama y vLLM. El modo Proxy Server es un gateway HTTP autohospedado que se despliega a través de Docker: cualquier cliente existente del SDK de OpenAI apunta a él sin cambios en el código, y el proxy se encarga del enrutamiento, la gestión de claves API virtuales, los límites de presupuesto por equipo, la limitación de tasa y las integraciones de observabilidad con herramientas como Langfuse y Arize Phoenix. Ambos modos tienen licencia MIT y son de uso gratuito. Las funciones de gobernanza empresarial, que incluyen SSO, RBAC y registros de auditoría, están disponibles en los niveles de pago a partir de $250 al mes.
Lo que LiteLLM hace realmente en abril de 2026
La función principal es la traducción de proveedores. Cuando tu aplicación envía una solicitud en formato Anthropic a través de LiteLLM, la biblioteca reescribe los campos de entrada y salida para que coincidan con lo que espera el modelo de destino, normaliza los códigos de error entre proveedores y devuelve una respuesta en el formato de OpenAI, independientemente del modelo que haya gestionado la llamada. Los nuevos proveedores suelen añadirse en el plazo de un día desde el lanzamiento de su API pública, que es como LiteLLM ha mantenido el ritmo de la rápida expansión de la industria más allá de los 100 endpoints compatibles.
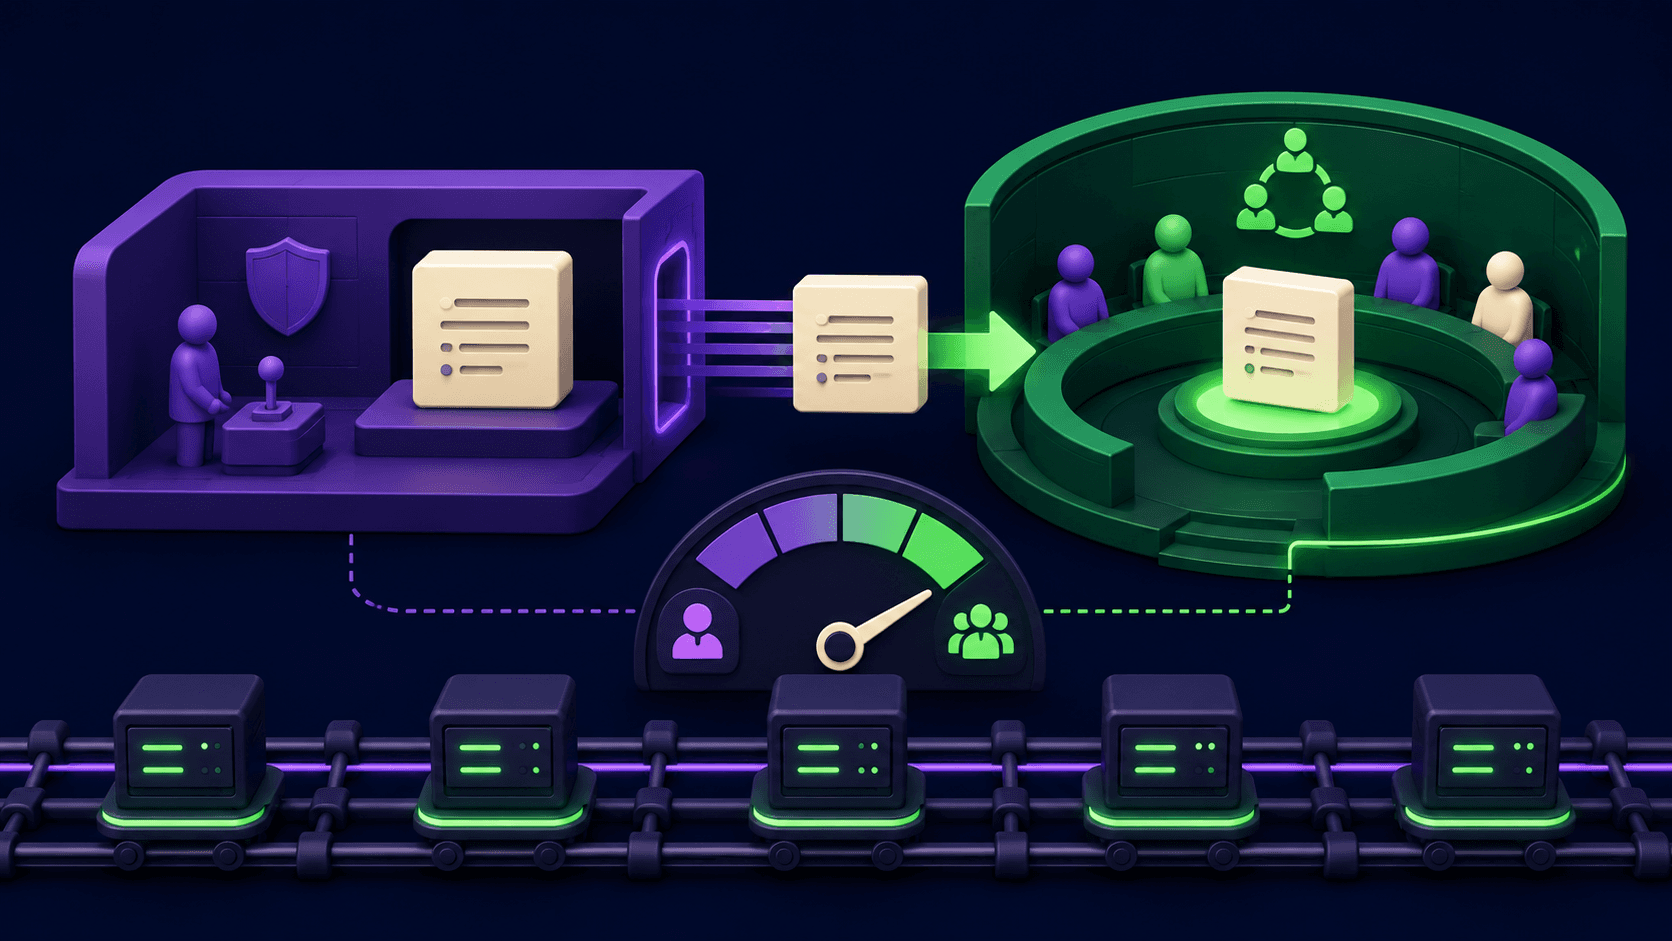
El servidor proxy amplía esto con una gestión de acceso de nivel de producción. Los equipos lo configuran con un archivo YAML que define grupos de modelos, presupuestos por clave y reglas de enrutamiento. Un equipo de plataforma puede emitir claves API virtuales a escuadrones individuales con límites de gasto estrictos, listas de modelos permitidos y límites de RPM aplicados en la capa del proxy. Cuando un modelo principal no está disponible o tiene la tasa limitada, el proxy recurre automáticamente a una alternativa configurada. El balanceo de carga distribuye las solicitudes entre múltiples instancias del mismo proveedor. Todo esto ocurre sin que la aplicación tenga conocimiento de la lógica de enrutamiento.
La observabilidad se integra de forma externa en lugar de nativa. LiteLLM enruta los registros a Langfuse, Arize Phoenix, Prometheus u OpenTelemetry. A continuación, los equipos visualizan la atribución de costes por equipo, clave o usuario en su plataforma de observabilidad preferida. La interfaz de usuario del proxy proporciona un panel de gastos básico, pero las configuraciones de monitorización en producción generalmente lo conectan a herramientas externas para la generación de alertas y la retención a largo plazo.
"La idea de un proxy LLM es súper atractiva. Podría ayudar a los equipos a elegir dinámicamente entre LLM locales y en la nube sin reestructurar su infraestructura." -- jmorgan (creador de Ollama), Hacker News, diciembre de 2023
El SDK de Python es a menudo la forma en que los desarrolladores descubren LiteLLM por primera vez. La interfaz es un contenedor ligero: instalas el paquete, configuras las claves API del proveedor como variables de entorno y llamas a litellm.completion(model="gpt-4o", messages=[..]). Cambiar a Claude es una modificación de un solo campo en la cadena del modelo. El SDK gestiona el streaming, las llamadas asíncronas, el recuento de tokens y el seguimiento de costes por solicitud. Los desarrolladores que construyen con LangChain o LlamaIndex pueden integrar LiteLLM como el cliente de modelo subyacente para obtener enrutamiento multiproveedor sin tocar la capa del framework superior.
Dónde se sitúa LiteLLM frente a OpenRouter y Portkey
Tres herramientas dominan las conversaciones sobre gateways de LLM: LiteLLM, OpenRouter y Portkey. Hacen apuestas arquitectónicas fundamentalmente diferentes, y la elección correcta depende de tu filosofía de infraestructura más que de las listas de características.
OpenRouter es un marketplace cerrado y alojado. Te registras, obtienes una clave API y accedes a más de 300 modelos, incluyendo ajustes finos de la comunidad, a través de los servidores de OpenRouter. OpenRouter añade una tarifa de compra de créditos del 5.5% y se lleva un porcentaje de los ingresos con los proveedores de modelos que se anuncian en su marketplace. Todo tu tráfico fluye a través de la infraestructura de OpenRouter, lo que significa cero sobrecarga de despliegue pero ningún control sobre el enrutamiento de datos. Para la creación rápida de prototipos y proyectos personales, OpenRouter es el camino más rápido hacia el acceso multimodelo. Con un gasto de $10,000 al mes en LLM, estás pagando a OpenRouter $550 en tarifas. No puedes autohospedarlo, auditar su código ni desplegarlo en un entorno aislado (air-gapped). Funciona mejor para los desarrolladores que desean acceso a modelos, no control de la infraestructura.
Portkey es un gateway cerrado y gestionado que se ejecuta en la red edge de Portkey. Su precio se basa en el registro guardado (alrededor de $49 al mes para el nivel Pro, que cubre de 100K a 3M de solicitudes), lo que significa que el coste escala con el uso de la observabilidad en lugar del volumen de tokens. El diferenciador de Portkey es la observabilidad integrada de nivel de producción: registros de solicitudes detallados, seguimiento de latencia, atribución de costes, almacenamiento en caché semántico y métricas de barreras de seguridad (guardrails) se incluyen en el servicio gestionado sin requerir integraciones externas. El almacenamiento en caché semántico, notablemente ausente en el nivel de código abierto de LiteLLM, permite a Portkey servir respuestas en caché para consultas semánticamente similares (no solo idénticas), lo que puede reducir significativamente los costes a escala. Al igual que OpenRouter, Portkey no es autohospedable y el tráfico fluye a través de su infraestructura.
LiteLLM hace la apuesta opuesta: tú eres el dueño de la infraestructura y de los datos. La licencia MIT significa que puedes auditar el código, desplegarlo en entornos regulados y ejecutarlo en configuraciones aisladas donde el tráfico nunca puede tocar un servidor de terceros. Ningún dato sale de tu red, excepto las llamadas directas a los proveedores de LLM que configures explícitamente. La contrapartida es la carga operativa. Ejecutar una instancia de LiteLLM en producción requiere gestionar PostgreSQL, Redis, migraciones de bases de datos, copias de seguridad y agrupación de conexiones (connection pooling). Los costes de infraestructura para una configuración de producción realista oscilan entre $2,000 y $2,300 al mes antes de tener en cuenta el trabajo de DevOps. LiteLLM se convierte en el claro ganador en costes frente a OpenRouter una vez que el gasto en LLM supera aproximadamente los $10,000 al mes, pero solo si tu equipo tiene la capacidad de mantener el stack.
"Cambiar de proveedor es una modificación de una línea de código. Esa es la promesa principal, y para la mayoría de los proveedores realmente la cumple." -- revisor de aicoolies.com, 2025
Los desarrolladores que utilizan OpenRouter junto con LiteLLM a menudo usan OpenRouter para acceder a modelos experimentales y de la comunidad, mientras enrutan el tráfico de producción a través de una instancia autohospedada de LiteLLM por motivos de cumplimiento. Ambos no son mutuamente excluyentes: LiteLLM puede actuar como proxy hacia OpenRouter como uno de sus proveedores configurados. Para los equipos que ya utilizan Helicone para la observabilidad, LiteLLM puede coexistir como la capa de enrutamiento mientras Helicone se encarga del registro.
Cómo es la realidad diaria del proxy
La configuración es rápida. Una instancia local funcional se ejecuta en menos de diez minutos: instalas a través de pip, creas un YAML de configuración que enumera tus modelos y las credenciales de sus proveedores, ejecutas litellm --config config.yaml, y cualquier cliente compatible con OpenAI que apunte a localhost:4000 ahora se enruta a través del proxy. Las configuraciones de Docker Compose añaden Postgres y Redis en otros diez minutos para la persistencia y el almacenamiento en caché.
La configuración YAML es donde los equipos pasan la mayor parte de su tiempo. Los grupos de modelos definen las cadenas de respaldo. La configuración del enrutador controla si el balanceo de carga es round-robin, el menos ocupado o ponderado por latencia. Las claves de presupuesto se emiten por equipo con límites estrictos y alertas suaves. Para un equipo de plataforma que estandariza el acceso a LLM en toda una empresa, esta configuración se convierte en el documento de política central para todo el gasto en IA.
A un volumen moderado (menos de 100,000 solicitudes al día), el proxy es en gran medida transparente. La sobrecarga de latencia para la mayoría de las llamadas es mínima. El enrutamiento de respaldo, la aplicación del presupuesto y la lógica de reintento específica del proveedor funcionan sin intervención.
A mayor volumen, la base de datos se convierte en el cuello de botella. LiteLLM escribe los registros de solicitudes en PostgreSQL de forma síncrona en la ruta de la solicitud. Pasado un millón de filas de registro acumuladas, la propia documentación reconoce que los tiempos de respuesta de la API pueden degradarse. Los equipos han reportado solicitudes en caché con aciertos de caché de un milisegundo que aún devuelven latencias de extremo a extremo de más de 10 segundos debido a la sobrecarga de serialización de escritura de la base de datos. La solución operativa es deshabilitar el registro detallado o fragmentar (sharding) la base de datos, lo que anula el propósito del seguimiento de gastos integrado. Esta limitación arquitectónica ha empujado a algunos equipos de alto rendimiento hacia alternativas construidas en tiempos de ejecución más rápidos (proxies basados en Go como Bifrost han surgido específicamente para abordar esto).
Los agentes de IA construidos con AnythingLLM u otros frameworks de agentes pueden apuntar a un proxy de LiteLLM como su backend de modelo, lo que brinda a los equipos de plataforma una visibilidad centralizada sobre el gasto en LLM originado por los agentes sin requerir la gestión de claves API por agente.
Para quién está diseñado LiteLLM
LiteLLM funciona mejor para los equipos de ingeniería de plataforma y backend que gestionan el acceso a LLM para múltiples escuadrones internos, manejan datos regulados que no pueden fluir a través de infraestructura de terceros, o están ejecutando suficiente gasto en LLM como para que el coste del autohospedaje esté justificado. Las empresas que construyen productos de IA en múltiples proveedores por resiliencia (Claude como principal, GPT-4o como respaldo, Bedrock como la opción requerida por la empresa) sacan el máximo provecho de la lógica de enrutamiento y respaldo del gateway.
Los ingenieros de IA que crean prototipos en varios modelos utilizan el SDK de Python como una capa de "prueba antes de comprometerte": construyen contra la interfaz litellm.completion() y cambian de proveedor sin tocar la lógica de la aplicación. Esto es genuinamente útil durante las primeras etapas de un producto, cuando todavía se está evaluando el modelo adecuado para una tarea.
Las organizaciones en el sector de la salud, las finanzas u otras industrias reguladas aprecian la opción de despliegue aislado (air-gapped) y la capacidad de auditar todo el código base para el cumplimiento. El modelo autohospedado significa que puedes demostrar a los auditores que los datos confidenciales de los prompts nunca tocan un servidor de terceros.
Lo que LiteLLM no es
LiteLLM no es una buena opción para individuos, desarrolladores en solitario o equipos pequeños. La sobrecarga de la infraestructura, las dependencias de PostgreSQL y Redis, el modelo de configuración YAML y la carga de mantenimiento operativo están calibrados para equipos de ingeniería con capacidad DevOps. Un desarrollador que solo quiere llamar a Claude y GPT-4o desde el mismo código base estará mejor servido por el SDK de Python por sí solo (sin el proxy) o por la opción alojada sin configuración de OpenRouter.
Evita LiteLLM si necesitas almacenamiento en caché semántico integrado sin trabajo de integración adicional. El almacenamiento en caché en formato OpenAI (coincidencia exacta) funciona; la deduplicación de consultas semánticamente similares requiere que conectes una capa externa tú mismo. Para los equipos donde la observabilidad es el requisito principal, el stack gestionado de Portkey ofrece más por dólar a un volumen bajo a moderado.
El incidente de la cadena de suministro de PyPI de marzo de 2026 es un contexto relevante para cualquier equipo que evalúe el paquete de Python de LiteLLM. Las versiones 1.82.7 y 1.82.8 fueron comprometidas por el grupo de actores de amenazas "TeamPCP" a través de un escáner de seguridad Trivy envenenado en el pipeline CI/CD de BerriAI. Los paquetes maliciosos, que recolectaban claves SSH, credenciales en la nube y tokens de Kubernetes, estuvieron activos durante aproximadamente 40 minutos el 24 de marzo de 2026 antes de que PyPI los pusiera en cuarentena. La respuesta de BerriAI fue transparente: Krrish Dholakia e Ishaan Jaffer publicaron una cronología pública, contrataron al equipo Mandiant de Google para el análisis forense, rotaron todas las credenciales y lanzaron versiones limpias a través de un pipeline CI/CD reforzado. Los clientes que ejecutaban la imagen oficial de Docker no se vieron afectados. Los equipos que instalan directamente desde PyPI deben fijar la versión a la v1.83.0 o posterior y verificar el pipeline de lanzamiento antes de actualizar.
LiteLLM tampoco aloja modelos. Es una capa de enrutamiento y traducción, no un proveedor de computación. Los equipos que ejecutan inferencia local a través de Ollama o vLLM pueden apuntar LiteLLM a esos servidores, pero LiteLLM en sí no tiene infraestructura de GPU.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen LiteLLM.
Artículos relacionados
Guías y artículos relacionados con LiteLLM.

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Does API Cost More Than a Subscription for Claude Opus 4.8, GPT-5.5, and Grok?

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Replit Pricing Explained (2026): Core vs Pro and Effort-Based Agent Billing