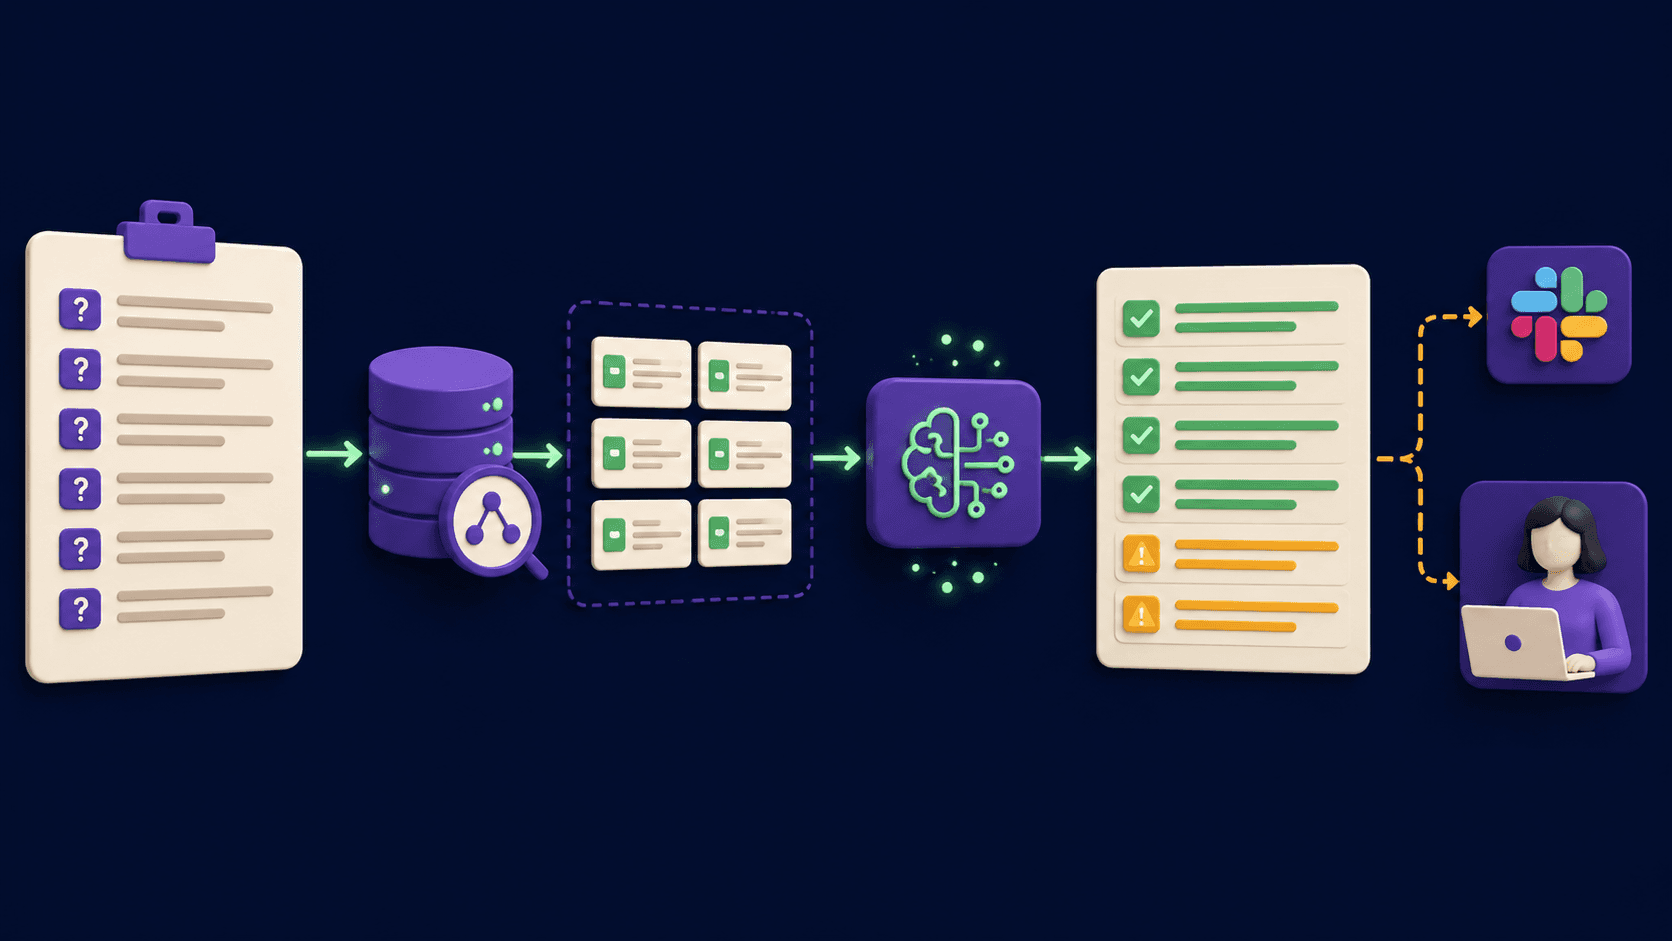
LlamaIndex es un framework de datos de código abierto para crear aplicaciones RAG sobre datos privados, desarrollado por LlamaIndex, Inc. Incluye más de 300 conectores de datos, fragmentación jerárquica integrada y LlamaParse para el análisis de documentos a nivel empresarial. Núcleo OSS gratuito; LlamaCloud desde $50/mes.
LlamaIndex es un framework de datos de código abierto creado por LlamaIndex, Inc. para desarrolladores que conectan fuentes de datos privados con grandes modelos de lenguaje. Lanzado originalmente a finales de 2022 como GPT Index por Jerry Liu y Simon Liu, el proyecto ha crecido hasta alcanzar casi 49,000 estrellas en GitHub y 25 millones de descargas mensuales de paquetes a partir de abril de 2026. La biblioteca principal tiene licencia MIT y su uso comercial es gratuito. La capa comercial de la empresa, LlamaCloud, añade servicios gestionados de análisis, extracción e indexación sobre el framework OSS, con LlamaParse como su producto de pago estrella para la comprensión de documentos.
El framework se organiza en torno a cinco abstracciones: conectores de datos (más de 300 fuentes a través de LlamaHub), analizadores de nodos para estrategias de fragmentación (chunking), índices (vectoriales, de resumen, de palabras clave, de grafos de conocimiento), motores de consulta para flujos de recuperación a respuesta, y Workflows para la orquestación asíncrona de agentes. Las capacidades integradas incluyen fragmentación jerárquica, búsqueda híbrida que combina la similitud vectorial con la coincidencia de palabras clave BM25, descomposición de subpreguntas para consultas de múltiples documentos y un evaluador RAG integrado que mide la fidelidad y la relevancia sin requerir una plataforma de observabilidad independiente. LlamaParse maneja diseños de documentos complejos, incluyendo tablas anidadas, PDF de varias columnas, gráficos y notas manuscritas, utilizando agentes impulsados por VLM que dirigen el contenido a modelos de análisis especializados.
Lo que LlamaIndex realmente hace en abril de 2026
El framework se ha expandido sustancialmente más allá de sus raíces en los flujos de trabajo RAG. La versión actual (v0.14.21, 21 de abril de 2026) incluye Workflows, un sistema completo de orquestación de agentes asíncronos basado en el paso de eventos en lugar de grafos dirigidos. LlamaAgents, lanzado en 2025, permite el despliegue con un solo clic de agentes de procesamiento de documentos con plantillas listas para usar en el procesamiento de facturas, revisión de contratos y gestión de reclamaciones, todo construido sobre la biblioteca Workflows.
LlamaParse v2, lanzado el 18 de diciembre de 2025, reorganizó el análisis en cuatro niveles: Fast (1 crédito por página, documentos centrados en texto), Cost-effective (3 créditos por página, uso general), Agentic (10 créditos por página, diseños complejos con contenido mixto) y Agentic Plus (45 créditos por página, máxima precisión). La versión v2 redujo los costos de Agentic Plus en un 50 % y añadió la fijación de versiones (version pinning) para que los flujos de producción se bloqueen en un comportamiento de análisis específico y no se rompan con las actualizaciones automáticas. Las herramientas adicionales lanzadas en 2025 incluyen LlamaSheets (datos de hojas de cálculo listos para IA), LlamaSplit (separación automática de documentos a partir de archivos agrupados) y el modo de fila de tabla de LlamaExtract para extraer entidades repetitivas de documentos estructurados.
LlamaCloud obtuvo la certificación SOC 2 Type 2 y el cumplimiento de GDPR/HIPAA tras el anuncio de la Serie A en marzo de 2025. Se despliega como SaaS o en las instalaciones (VPC). Los clientes revelados en la Disponibilidad General incluyen a Rakuten, Carlyle, Salesforce y KPMG. La empresa informa de mil millones de documentos procesados y 300,000 usuarios de LlamaParse.
Dónde se sitúa LlamaIndex frente a LangChain y Haystack
LlamaIndex vs. LangChain: Las arquitecturas divergen en la unidad fundamental de trabajo. LlamaIndex trata la recuperación como la abstracción principal: los conectores de datos, las estrategias de fragmentación, los índices y los motores de consulta son objetos de primera clase. LangChain trata a los agentes como la abstracción principal, con la recuperación como un componente conectado manualmente con divisores de texto, almacenes vectoriales, recuperadores y reclasificadores. El resultado práctico es que un flujo RAG básico requiere aproximadamente un 30-40 % más de código en LangChain que en LlamaIndex, y el equivalente en LangChain a la fragmentación jerárquica de LlamaIndex requiere el ensamblaje manual de componentes. LlamaIndex tiene una sobrecarga de framework de alrededor de 6 ms y 1.6K tokens por consulta; LangGraph se sitúa en aproximadamente 14 ms y 2.4K tokens en los benchmarks de producción. Sin embargo, LangChain domina en tamaño de comunidad, tutoriales y ofertas de empleo, y LangSmith proporciona observabilidad de primera mano de la que LlamaIndex carece de forma nativa (depende de herramientas de terceros como Langfuse o Phoenix). Muchos equipos de producción terminan usando ambos: LlamaIndex como capa de recuperación y LangGraph como capa de orquestación.
LlamaIndex vs. Haystack: Haystack (de deepset) utiliza un modelo de flujo modular explícito donde el preprocesamiento se divide en componentes con nombre: convertidores, limpiadores, divisores, recuperadores y reclasificadores, cada uno como una etapa del flujo visible en el código. Esto hace que los flujos de trabajo complejos de procesamiento de documentos sean más fáciles de auditar y mantener en entornos empresariales. Haystack también incluye un constructor visual de flujos (Haystack Studio) para el cual LlamaIndex no tiene equivalente. La contrapartida: LlamaParse es un servicio propietario de análisis de documentos impulsado por VLM que maneja diseños complejos, tablas y gráficos mejor que la pila de componentes de código abierto de Haystack (Apache Tika, Unstructured.io). Para flujos de búsqueda de documentos sencillos, el modelo de flujo explícito de Haystack gana en claridad; para aplicaciones donde la calidad del análisis de documentos es el cuello de botella, el enfoque centrado en los datos de LlamaIndex y la precisión de LlamaParse marcan la diferencia. La sobrecarga del framework para ambos es casi idéntica en los benchmarks (Haystack ~5.9 ms/1.57K tokens; LlamaIndex ~6 ms/1.6K tokens).
Cómo es la realidad del flujo RAG en el día a día
Para un desarrollador que empieza con LlamaIndex, los primeros 30 minutos son genuinamente rápidos. Instalar el paquete principal, apuntar un SimpleDirectoryReader a una carpeta de PDF, crear un VectorStoreIndex y ejecutar un motor de consultas requiere menos de 20 líneas de Python. La primera demostración funciona. La fricción comienza al pasar de la demostración a la producción.
La migración a la v0.10 en febrero de 2024 fue el momento más disruptivo en la historia de LlamaIndex. El equipo dividió el paquete único llama-index en llama-index-core más cientos de paquetes de integración con versiones separadas, desaprobó ServiceContext (un objeto de configuración muy utilizado) y reescribió las abstracciones de fragmentación. Los notebooks, tutoriales y el código de la comunidad se rompieron con ImportError. El problema #10747 de GitHub ("Breaking changes makes it hard to work with llama_index") se convirtió en un largo hilo de desarrolladores frustrados. Las herramientas de migración ayudaron, pero los equipos con plazos ajustados absorbieron tiempo real de depuración.
"Probablemente nunca lo vuelva a usar porque es inestable, la interfaz cambia constantemente, la documentación está regularmente desactualizada y las abstracciones son demasiado complicadas. Los documentos han cambiado por completo 3 veces. Es exasperante". -- Desarrollador anónimo, GitHub Issues #10747, 2024
Desde la v0.10, la estabilidad ha mejorado. La rama actual v0.14 no ha provocado quejas equivalentes. Pero la brecha en la documentación persiste: el ritmo de lanzamiento es rápido, los ejemplos envejecen rápidamente y los principiantes que siguen un tutorial de hace tres meses se topan regularmente con errores que requieren consultar el registro de cambios o Discord. Una vez que un desarrollador entiende las abstracciones principales lo suficientemente bien como para leer el código fuente cuando algo se rompe, LlamaIndex se vuelve mucho más cómodo.
LlamaParse es donde el producto comercial se gana su lugar. Para PDF limpios y bien formateados, incluyendo contratos legales, declaraciones financieras y documentación técnica, la precisión es sólida. La recepción de la comunidad en el hilo de Hacker News de febrero de 2025 fue positiva:
"Donde la calidad es más importante que la cantidad, dudo que haya muchas herramientas que puedan acercarse a Llamaparse". -- BenGosub, Hacker News, 7 de febrero de 2025
La advertencia señalada en el mismo hilo: las demostraciones en la página de inicio de LlamaParse utilizan renderizados digitales limpios. El rendimiento en el mundo real con escaneos de baja calidad, fotos de recibos y documentos manuscritos es más variable, y la empresa ha reconocido que manejar "una larga cola de problemas más allá de las tablas", incluyendo fuentes, encabezados, gráficos y campos de formularios, es un desafío continuo.
Para quién está diseñado LlamaIndex
LlamaIndex es ideal para desarrolladores de Python o TypeScript que crean aplicaciones donde el problema central es la recuperación estructurada a partir de datos privados: bases de conocimiento empresariales, preguntas y respuestas sobre documentos, agentes de datos de múltiples fuentes y flujos de procesamiento de contratos o informes. Los equipos que procesan flujos de trabajo con gran volumen de documentos en finanzas, legal, salud o investigación sacarán el máximo provecho de LlamaParse y LlamaExtract sin tener que crear una lógica de análisis personalizada. Los desarrolladores que deseen un framework con opiniones sólidas, centrado en los datos, que maneje la fragmentación, la indexación y la recuperación híbrida de forma predeterminada, cubrirán el mismo terreno que LangChain con menos código repetitivo para casos de uso centrados en RAG.
El framework OSS también es muy adecuado para configuraciones de LLM locales. Las integraciones de Ollama y llama.cpp permiten a los desarrolladores ejecutar todo el flujo con modelos alojados localmente, manteniendo todos los datos en las instalaciones sin necesidad de LlamaCloud en absoluto. Esto hace que LlamaIndex sea viable para entornos de datos sensibles incluso en el nivel gratuito.
Lo que LlamaIndex no es
LlamaIndex no es un producto sin código (no-code). No hay interfaz visual, ni constructor de flujos de arrastrar y soltar, ni interfaz de chat que los usuarios puedan abrir sin la configuración de un desarrollador. Los usuarios no técnicos no pueden usarlo directamente.
No es la mejor opción para equipos cuya necesidad principal es la orquestación compleja de agentes en lugar de la recuperación de datos. Si la aplicación trata fundamentalmente sobre razonamiento de múltiples pasos, uso de herramientas, memoria y bucles de agentes sobre API web en lugar de datos privados con gran cantidad de documentos, el ecosistema más amplio de LangChain/LangGraph y su observabilidad de primera mano (LangSmith) son un mejor punto de partida. Del mismo modo, si el equipo necesita un constructor visual de flujos empresariales para flujos de trabajo gestionados por TI, Haystack Studio aborda esa necesidad de manera más directa.
LlamaParse a gran escala se vuelve costoso rápidamente. En el nivel Agentic (10 créditos por página, $0.0125 por página), procesar 100,000 páginas al mes cuesta $1,250 en créditos de análisis antes de la suscripción al plan Pro de $500. El procesamiento por lotes de alto volumen sobre documentos ruidosos debería requerir un cálculo de costos antes de comprometerse.
Por último, para los equipos que todavía están en la v0.9 o anterior, migrar a la rama actual v0.14 requiere un esfuerzo deliberado. Los cambios de arquitectura en la v0.10 no son compatibles con versiones anteriores. Presupueste tiempo para la migración antes de depender de ejemplos de la comunidad que asumen la estructura de paquetes actual.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen LlamaIndex.
Artículos relacionados
Guías y artículos relacionados con LlamaIndex.

Google Vision AI Explained (2026): Pricing Per 1,000 Units, Free Tier, and Alternatives

Build an Internal Knowledge Bot (RAG) for Your Company: A No-Nonsense Guide

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)