Sesame AI 是 Maya 和 Miles 背后的初创公司,这两款语音伴侣由对话式语音模型(CSM)驱动。2025 年 3 月在 Apache 2.0 协议下发布的 10 亿参数开源权重,让开发者能够自托管语音模型,重现自然的对话节奏、停顿和语流不畅(如语气词)。
Sesame AI 是一家总部位于旧金山的语音 AI 初创公司,由 Brendan Iribe(Oculus 联合创始人兼前 CEO)、Ankit Kumar(Ubiquity6 前 CTO)和 Nate Mitchell(Oculus 联合创始人)共同创立。该公司的核心理念是,语音 AI 一直陷入“恐怖谷”效应:技术上令人惊叹,但与之交谈最终会让人感到疲惫,因为它缺乏“语音存在感”,即那种让对话感觉被真正倾听的特质。为了解决这个问题,Sesame 构建了对话式语音模型(CSM),这是一个基于 Transformer 的系统,它在单一的统一通道中处理交错的文本和音频 token,而不是通过传统的“语音转文本-语言模型-文本转语音”流水线进行路由。其成果通过名为 Maya 和 Miles 的两个语音角色进行了展示,并在 2025 年 2 月迅速走红,当时一场现场演示吸引了超过 100 万用户,在短短几周内生成了超过 500 万分钟的对话。
对话式语音模型使用 Meta Llama 主干网络,并配以较小的音频解码器来生成残差矢量量化(RVQ)音频代码。该模型训练了三种规模:CSM-1B(10 亿参数)、CSM-3B(30 亿参数)和 CSM-8B(80 亿参数)。CSM-1B 权重于 2025 年 3 月 13 日通过 Hugging Face 和 GitHub 在 Apache 2.0 许可下开源,允许免费进行商业和私人使用。托管在 app.sesame.com 的演示版本对所有人免费开放,无需注册账号即可进行 5 分钟的会话;注册免费账号后可延长至 30 分钟。Maya 和 Miles 拥有截然不同的性格:Maya 擅长延伸对话并以温暖的语气回应,而 Miles 则更加直接和简洁。到 2025 年底,该公司共筹集了 2.975 亿美元,其中包括 2025 年 2 月由 Andreessen Horowitz 领投的 4750 万美元 A 轮融资,以及 2025 年 10 月由 Sequoia Capital 和 Spark Capital 领投的 2.5 亿美元 B 轮融资,使其估值超过 10 亿美元。
Sesame AI 在 2026 年的产品矩阵
目前的公开产品主要围绕两个语音伴侣展开,可通过 app.sesame.com 以及 2025 年 10 月推出的 iOS 封闭测试版进行访问。Maya 和 Miles 都能生成带有语流不畅(如语气词、自我纠正)、自然呼吸模式、符合语境的语速的语音,并且能够处理打断,而不会卡顿或从固定的提示词重新开始。这些特质反映了 CSM 的架构优势:由于该模型将完整的对话历史作为交错的 token 进行处理,而不是将每一轮对话视为孤立的合成任务,因此它可以根据之前所说的所有内容来调节语气和节奏。
开源的 CSM-1B 需要 CUDA GPU、Python 3.10 或更高版本以及 ffmpeg。它是语音生成专家,而非通用语言模型:它无法自行生成文本,需要与独立的 LLM 集成来驱动对话的语言部分。在 Hugging Face 上,该模型需要申请访问权限(免费申请)。社区成员已经构建了兼容 Mac 的 MLX 实现,支持在 Apple Silicon 硬件上进行本地推理。截至 2026 年 5 月,其 GitHub 仓库已获得 14,600 颗星和 1,500 次分叉,表明开发者采用率非常活跃。在语言覆盖方面,该模型在约 100 万小时(主要为英语)的音频上进行了训练;Sesame 已宣布计划扩展到 20 多种语言,但目前尚未达到生产级质量。
2025 年 2 月 26 日,Sesame 发布了题为“跨越对话式语音的恐怖谷”的研究博客,并同步推出了 Maya 和 Miles 的现场演示,立即引发了 The Verge、ZDNET、PCWorld、TechRadar 和 Dataconomy 的病毒式报道。访问者描述了与 Maya 长达 20 到 30 分钟的对话,话题涵盖从伦理学到创意头脑风暴的各个方面,并指出该模型在某个时刻随口提到想吃一个花生酱泡菜三明治,这进一步增强了其个性感。反响之热烈,促使 Sesame 在演示发布后的几天内就加速完成了 A 轮融资。
“我甚至有点担心,我会对这种拥有如此逼真人类声音的语音助手产生情感依赖。”—— Reddit 用户,r/artificial,2025 年 2 月
Sesame AI 与 Hume AI 和 ElevenLabs 的对比定位
该领域最具可比性的三款工具是 Hume AI、ElevenLabs 和 Sesame AI,它们解决的是相邻但截然不同的问题。了解它们的架构就能明白真正的区别所在。
Hume AI (EVI):Hume 的共情语音接口(Empathic Voice Interface)通过分析输入流中的声音特征(语调、音高、语速、停顿)来对说话者的情绪状态进行分类,并相应地调整回复。它不像 CSM 那样从头开始生成语音;它使用的是传统的 TTS 合成技术,并叠加了情绪感知模块。Hume 面向的是构建面向客户的应用程序的企业开发者,在这些应用中,情商是一项设计或合规要求。该产品以 API 为先,并不直接面向最终用户。Sesame 的 Maya 和 Miles 是面向消费者的伴侣;而 Hume 则是开发者的构建模块。如果你需要在语音流水线中进行实时情绪识别,Hume 解决了 Sesame 未涉及的问题。
ElevenLabs Conversational AI:ElevenLabs 的竞争优势在于零样本语音克隆和原始延迟。其 Flash TTS 模型实现了约 75 毫秒的端到端延迟,并且在 2025-2026 年的语音 AI 基准测试中,ElevenLabs 在感知语音质量方面始终位居榜首或名列前茅。其架构是经典的流水线:语音转文本,然后是 LLM,最后是 TTS,其中 TTS 层是 ElevenLabs 专有的合成引擎。ElevenLabs 是一款闭源商业产品(2025 年 1 月估值为 33 亿美元),没有开源权重。Sesame 的 CSM 是一个处理交错 token 的单一统一模型,这意味着没有流水线拼接的开销,并且在整个对话中可能具有更连贯的韵律。ElevenLabs 在语音克隆深度和延迟方面胜出;而 Sesame 在自托管能力、开源许可和整体对话自然度方面更胜一筹。
Cartesia AI 采用了不同的架构方法:它使用状态空间模型(SSM)架构,特别是基于 Mamba 的架构,而不是 Transformer。这使得它在较低的计算成本下实现了低于 50 毫秒的首 token 延迟,使其在极低延迟比自然度更重要的实时流媒体用例中表现强劲。Cartesia 以开发者 API 为先,没有消费者产品。对于优先考虑对话深度而非原始速度的应用程序,Sesame 是更好的选择。在开源自托管选项的比较中,OpenVoice 提供了另一种开源 TTS 路径,而 Whisper 则处理任何混合流水线中的语音转文本部分。
“他们开源的是一个阉割版的 Sesame (1B),而不是他们在实际演示中使用的那个版本。”—— thehamkercat,Hacker News,2025 年 3 月 13 日
许可与版权现状
CSM-1B 开源权重在 Apache 2.0 协议下发布,这是目前最宽松的商业开源许可之一。开发者可以在商业产品中使用该模型、对其进行修改并重新分发,而无需向 Sesame 支付费用。它没有病毒式的 copyleft(著佐权)条款。这使得 CSM-1B 与许多商业语音 API 截然不同,后者生成的每个音频文件都带有使用限制或按分钟计费。
尽管如此,托管的演示版本需要考虑不同的因素。Sesame 明确表示,它会出于研究和改进的目的审查对话内容。使用托管在 app.sesame.com 界面的用户应将他们的对话视为非私密的。对于敏感的个人、法律或医疗对话,托管产品并不合适。对于愿意在自己的基础设施上构建自有流水线的技术用户来说,自托管的 CSM-1B 权重可以避免这种担忧。
关于语音克隆:当 TechCrunch 在 2025 年 3 月测试 CSM-1B 模型时,一名记者使用开源权重在不到一分钟的时间内成功克隆了自己的声音,然后生成了自己说出未曾说过的话的音频。Consumer Reports 当时指出,语音克隆工具作为一个类别,缺乏“有意义的”防欺诈保护措施。Sesame 在开源权重方面没有任何技术控制来防止这种情况。托管的 Maya 和 Miles 角色与用户语音克隆不同,但基础模型的能力是真实存在的。在生产应用中部署 CSM-1B 的开发者有责任实施适当的保护措施。这与大多数开源 AI 模型处理双重用途风险的方式一致,但在基于其进行构建之前值得了解。PlayHT 和 ElevenLabs 都在其托管产品中对语音克隆实施了更严格的同意验证。
Sesame AI 的明显不足之处
演示版本与开源版本之间的差距是记录最多的令人沮丧之处。Sesame 训练了三种规模的模型,但只发布了最小的一种。截至 2026 年 5 月,Maya 和 Miles 演示中使用的 8B 模型尚未开源。那些对病毒式演示感到兴奋并随后拉取开源权重的开发者发现,体验存在明显差异。Hacker News 用户将该发布版本描述为“阉割版”,GitHub 的 issue 讨论区也显示出对更大权重和训练代码的持续需求,而 Sesame 尚未承诺发布这两者。
仅支持英语的高质量输出是第二个一致的局限性。训练数据集约为 100 万小时,主要为英语音频;Sesame 承认非英语音频是污染了训练集,而不是被有意策划的。需要西班牙语、法语、普通话或其他语言的用户会得到明显降级的结果。其公布的路线图包括支持 20 多种语言,但尚未确认时间表。
对于托管产品而言,会话长度限制仍然是一个实际的痛点。免账号的 5 分钟不足以对对话质量形成判断。免费账号的 30 分钟虽然更好,但对于一款定位为“永远在线的伴侣”的应用来说仍然受到限制。iOS 测试版是封闭的;尚未宣布全面开放的日期。
Maya 和 Miles 并非事实型助手。它们没有网络访问权限或实时信息。在长时间的对话中,它们会对事实性问题生成听起来似是而非但可能不正确的答案。需要获取最新信息的语音界面的用户,最好将检索增强系统与 TTS 层结合使用,而不是将 Sesame 的托管伴侣用于任何需要准确性的任务。
在自托管方面:运行 CSM-1B 需要 CUDA GPU,这意味着对于大多数没有云 GPU 访问权限的个人来说并不实用。针对 Apple Silicon(通过 MLX 支持 M1/M2/M3)的社区实现是存在的,但截至研究之日尚未得到官方支持。一些 HN 用户报告称,在 M1 硬件上生成语音时会出现数秒的停顿。该模型还需要一个独立的 LLM 来驱动任何对话应用程序的语言部分,这增加了一个需要管理的系统。
Sesame AI 适合哪些人
Sesame AI 非常适合想要练习口语对话的用户,特别是致力于提高英语流利度的语言学习者,他们可以从一个能够不知疲倦地维持 30 分钟讨论的耐心对话者中获益。它也非常适合“出声思考”:通过交谈来梳理思路的知识工作者和开发者会发现,Maya 延伸对话的回复比传统的聊天机器人更具启发性。其对话质量确实与其他语音 AI 产品截然不同。
对于开发者来说,Apache 2.0 协议下的 CSM-1B 是目前最容易获取的开源语音生成模型之一。为游戏、互动小说、客户服务原型或无障碍工具构建语音界面的团队可以将其进行商业集成,而无需支付许可费用。它与开源 LLM(Llama 3、Mistral、Qwen)天然契合,可用于构建完全自托管的语音对话技术栈。
如果您需要事实准确性、多语言支持或低于 100 毫秒的延迟,请跳过 Sesame AI。如果您的应用程序需要 ElevenLabs 或 PlayHT 提供的语音克隆深度和语音库,或者如果您需要 Hume AI 提供的从输入流中进行实时情绪分类的功能,那么这些工具解决了语音 AI 问题的不同部分。Sesame 的独特贡献在于通过开源权重实现英语的整体对话自然度,而这正是它目前比其他任何可用工具做得更好的地方。
用户评价
暂无评价,快来分享你的第一条体验吧!
登录 后即可撰写评价。
收录于精选合集
包含 Sesame AI 的精选合集。
相关文章
与 Sesame AI 相关的指南和文章。

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
Build a 70-Language Live Voice Agent With GPT-Realtime-Translate (2026)

Google vs OpenAI vs Anthropic Agents: The May 2026 Platform Showdown
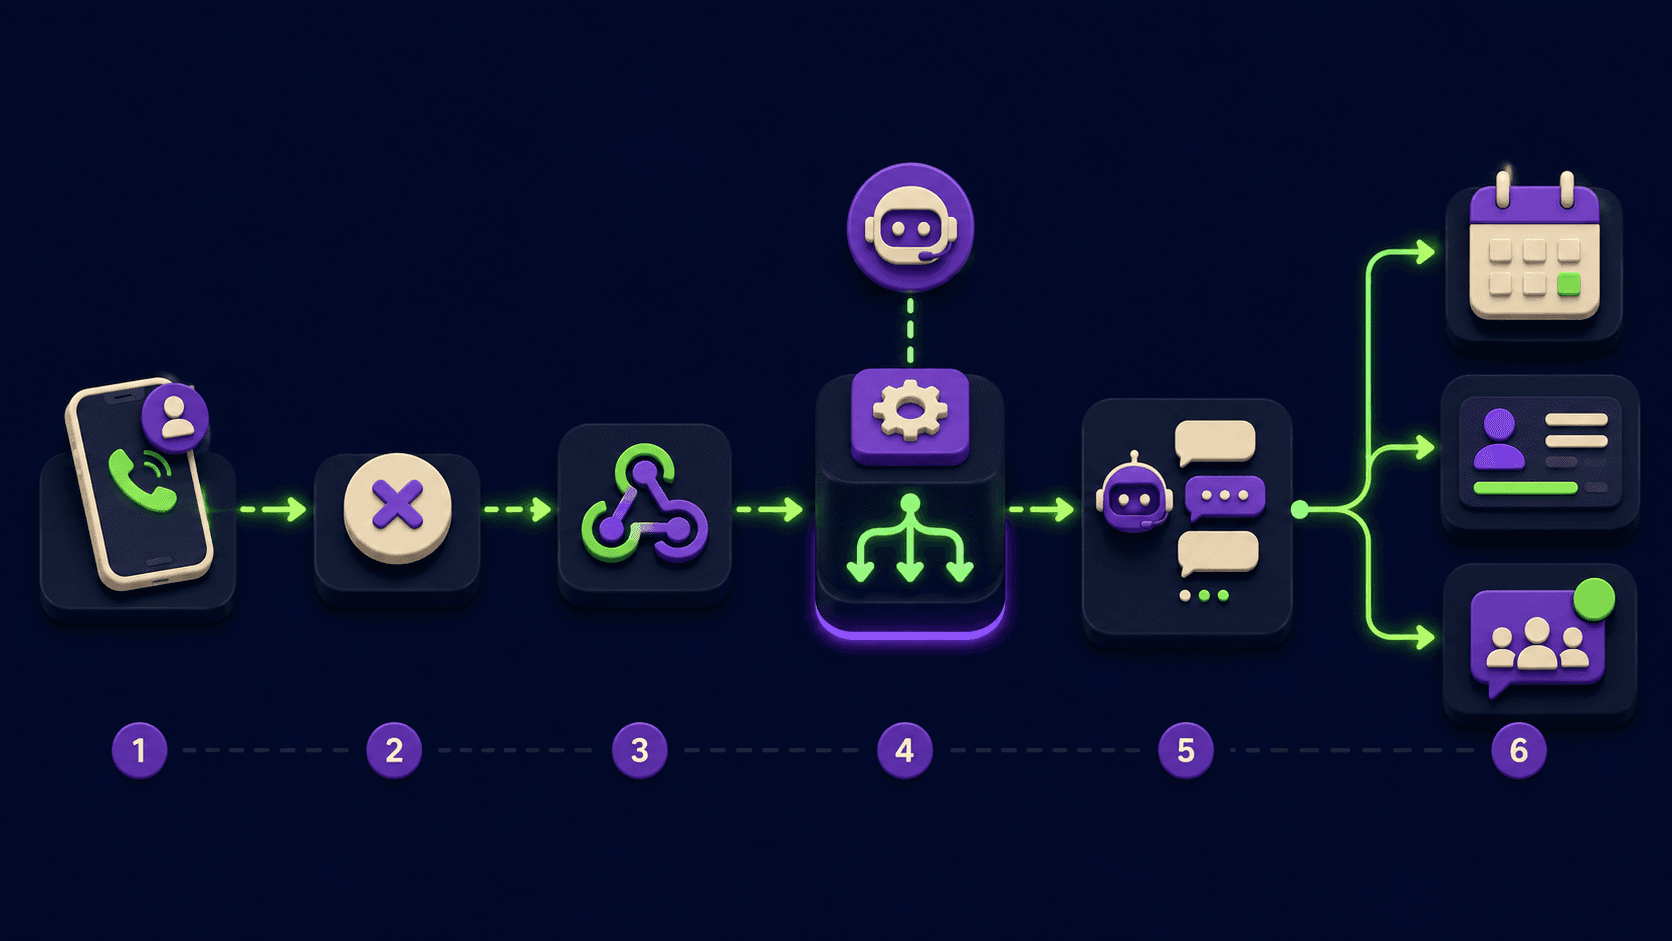
Voice Agent for Missed Calls: Every Service Business Is Bleeding Leads After Hours (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration