شركة Sesame AI هي الشركة الناشئة المطورة للمساعدين الصوتيين Maya و Miles، واللذين يعملان بنموذج التخاطب الصوتي (CSM). تتيح الأوزان المفتوحة للنموذج بحجم 1B معلمة، والتي تم إصدارها في مارس 2025 بموجب ترخيص Apache 2.0، للمطورين استضافة نموذج توليد كلام ذاتياً يحاكي إيقاع المحادثة الطبيعية، والتوقفات، والتلعثم العفوي.
شركة Sesame AI هي شركة ناشئة متخصصة في الذكاء الاصطناعي الصوتي مقرها سان فرانسيسكو، شارك في تأسيسها Brendan Iribe (المؤسس المشارك والرئيس التنفيذي السابق لشركة Oculus)، و Ankit Kumar (المدير التقني السابق لشركة Ubiquity6)، و Nate Mitchell (المؤسس المشارك لشركة Oculus). تتمحور الرؤية الأساسية للشركة حول فكرة أن الذكاء الاصطناعي الصوتي قد علق في "الوادي الخارق" (uncanny valley): فهو مبهر تقنياً ولكنه مرهق في التحدث إليه لأنه يفتقر إلى "الحضور الصوتي"، وهي السمة التي تجعل المحادثة تبدو مسموعة ومفهومة حقاً. ولحل هذه المشكلة، طورت Sesame نموذج التخاطب الصوتي (CSM)، وهو نظام قائم على بنية المحولات (transformer) يعالج الرموز النصية والصوتية المتداخلة في مسار واحد موحد بدلاً من توجيهها عبر المسار التقليدي (تحويل الكلام إلى نص، ثم نموذج لغوي، ثم تحويل النص إلى كلام). وقد حققت النتيجة، التي تم استعراضها من خلال شخصيتين صوتيتين باسم Maya و Miles، انتشاراً واسعاً في فبراير 2025 عندما جذب عرض تجريبي حي أكثر من مليون مستخدم قاموا بتوليد أكثر من خمسة ملايين دقيقة من المحادثات في غضون أسابيع.
يستخدم نموذج التخاطب الصوتي بنية Meta Llama الأساسية مقترنة بوحدة فك ترميز صوتية أصغر لتوليد رموز صوتية بتقنية التكميم المتجهي المتبقي (RVQ). تم تدريب ثلاثة أحجام من النموذج: CSM-1B (1 مليار معلمة)، و CSM-3B (3 مليارات معلمة)، و CSM-8B (8 مليارات معلمة). تم توفير أوزان CSM-1B كمصدر مفتوح في 13 مارس 2025 عبر Hugging Face و GitHub بموجب ترخيص Apache 2.0، مما يسمح بالاستخدام التجاري والخاص بحرية تامة. يعمل العرض التجريبي المستضاف على app.sesame.com مجاناً لأي شخص بدون حساب لجلسات مدتها 5 دقائق؛ ويمدد الحساب المجاني المسجل هذه المدة إلى 30 دقيقة. يتمتع كل من Maya و Miles بشخصيات مميزة: حيث تميل Maya إلى إطالة الحوار والرد بدفء، بينما يميل Miles إلى أن يكون أكثر مباشرة وإيجازاً. وبحلول أواخر عام 2025، جمعت الشركة إجمالي $297.5 مليون، مع جولة تمويل من الفئة أ (Series A) بقيمة $47.5 مليون بقيادة Andreessen Horowitz في فبراير 2025، وجولة تمويل من الفئة ب (Series B) بقيمة $250 مليون بقيادة Sequoia Capital و Spark Capital في أكتوبر 2025، مما دفع تقييم الشركة إلى ما يزيد عن $1 مليار.
ما تقدمه Sesame AI في عام 2026
تتركز العروض العامة الحالية حول مساعدين صوتيين يمكن الوصول إليهما عبر app.sesame.com ومن خلال نسخة تجريبية مغلقة لنظام iOS تم إطلاقها في أكتوبر 2025. يولد كل من Maya و Miles كلاماً يتضمن تلعثماً عفوياً (كلمات حشو، وتصحيحات ذاتية)، وأنماط تنفس طبيعية، وسرعة إيقاع مناسبة للسياق، بالإضافة إلى القدرة على التعامل مع المقاطعات دون توقف أو إعادة البدء من موجه ثابت. تعكس هذه الصفات بنية CSM: نظراً لأن النموذج يعالج سجل المحادثة بالكامل كرموز متداخلة بدلاً من التعامل مع كل دور كمهمة توليد معزولة، فإنه يستطيع تعديل النبرة والإيقاع بناءً على كل ما قيل سابقاً.
يتطلب نموذج CSM-1B مفتوح المصدر وحدة معالجة رسومات CUDA، و Python 3.10 أو أحدث، و ffmpeg. إنه متخصص في توليد الكلام، وليس نموذجاً لغوياً عاماً: فهو لا يستطيع توليد النص بمفرده ويتطلب التكامل مع نموذج لغوي كبير (LLM) منفصل لتوجيه الجانب اللغوي من المحادثة. على Hugging Face، يتطلب النموذج وصولاً مقيداً (طلب الوصول مجاني). قام أعضاء المجتمع ببناء تطبيقات MLX متوافقة مع أجهزة Mac تتيح الاستدلال المحلي على أجهزة Apple Silicon. حصد مستودع GitHub على 14,600 نجمة و 1,500 تفرع (fork) اعتباراً من مايو 2026، مما يشير إلى تبني نشط من قبل المطورين. بالنسبة للتغطية اللغوية، تم تدريب النموذج على ما يقرب من مليون ساعة من الصوتيات باللغة الإنجليزية في الغالب؛ وقد صرحت Sesame بخططها للتوسع إلى أكثر من 20 لغة ولكنها لم تصل بعد إلى جودة الإنتاج.
في 26 فبراير 2025، نشرت Sesame مدونتها البحثية بعنوان "عبور الوادي الخارق للصوت التخاطبي" جنباً إلى جنب مع العرض التجريبي الحي لـ Maya و Miles، مما أدى إلى تغطية إعلامية واسعة وفورية من The Verge و ZDNET و PCWorld و TechRadar و Dataconomy. وصف الزوار محادثاتهم مع Maya بأنها استمرت من 20 إلى 30 دقيقة حول مواضيع تتراوح من الأخلاقيات إلى العصف الذهني الإبداعي، مشيرين إلى أن النموذج ذكر بشكل عفوي رغبته في تناول شطيرة زبدة الفول السوداني والمخلل في إحدى اللحظات، مما زاد من الإحساس بوجود شخصية حقيقية. كانت الاستجابة سريعة بما يكفي لتسريع إغلاق جولة التمويل من الفئة أ (Series A) لشركة Sesame في غضون أيام من إطلاق العرض التجريبي.
"أشعر بالقلق قليلاً من أنني سأبدأ في التعلق العاطفي بمساعد صوتي يتمتع بهذا المستوى من الصوت الشبيه بالبشر.". مستخدم Reddit، مجتمع r/artificial، فبراير 2025
موقع Sesame AI مقارنة بـ Hume AI و ElevenLabs
أبرز ثلاث أدوات قابلة للمقارنة في هذا المجال هي Hume AI، و ElevenLabs، و Sesame AI، وهي تحل مشكلات متقاربة ولكنها متميزة. إن فهم البنية التقنية يوضح الاختلافات الحقيقية بينها.
Hume AI (EVI): تصنف واجهة الصوت التعاطفية من Hume الحالة العاطفية للمتحدث من خلال تحليل الميزات الصوتية في تدفق الإدخال (النبرة، والطبقة، والسرعة، والتوقفات) وتكييف الردود وفقاً لذلك. إنها لا تولد الكلام من الصفر كما يفعل CSM؛ بل تستخدم توليد TTS التقليدي المدمج مع وحدة إدراك المشاعر. تستهدف Hume مطوري المؤسسات الذين يبنون تطبيقات موجهة للعملاء حيث يكون الذكاء العاطفي متطلباً أساسياً في التصميم أو الامتثال. المنتج يعتمد على واجهة برمجة التطبيقات (API) في المقام الأول ولا يستهدف المستخدمين النهائيين مباشرة. في المقابل، يعتبر Maya و Miles من Sesame مساعدين موجهين للمستهلكين؛ بينما Hume هي أداة بناء للمطورين. إذا كنت بحاجة إلى التعرف على المشاعر في الوقت الفعلي في مسارك الصوتي، فإن Hume تحل مشكلة لا تعالجها Sesame.
ElevenLabs Conversational AI: تكمن الميزة التنافسية لـ ElevenLabs في استنساخ الصوت الفوري (zero-shot) وزمن الوصول المنخفض. يحقق نموذج Flash TTS زمن وصول من البداية إلى النهاية يبلغ حوالي 75 مللي ثانية، وتضع معايير الذكاء الاصطناعي الصوتي لعامي 2025-2026 أداة ElevenLabs باستمرار في الصدارة أو بالقرب منها من حيث جودة الصوت المدركة. تعتمد البنية على مسار تقليدي: تحويل الكلام إلى نص، ثم نموذج لغوي كبير (LLM)، ثم تحويل النص إلى كلام (TTS)، حيث تكون طبقة TTS هي محرك التوليد الخاص بـ ElevenLabs. تعتبر ElevenLabs منتجاً تجارياً مغلقاً (بقيمة $3.3 مليار في يناير 2025) ولا توفر أوزاناً مفتوحة المصدر. أما نموذج CSM من Sesame فهو نموذج موحد يعالج الرموز المتداخلة، مما يعني عدم وجود عبء إضافي لربط المسارات، ويوفر إيقاعاً أكثر تماسكاً عبر المحادثة بأكملها. تتفوق ElevenLabs في عمق استنساخ الصوت وزمن الوصول؛ بينما تتفوق Sesame في إمكانية الاستضافة الذاتية، والترخيص المفتوح، والطبيعة التخاطبية الشاملة.
تتخذ Cartesia AI نهجاً معمارياً مختلفاً: فهي تستخدم بنية نموذج فضاء الحالة (SSM)، وتحديداً القائمة على Mamba، بدلاً من المحولات (transformers). يوفر هذا زمن وصول للرمز الأول يقل عن 50 مللي ثانية بتكاليف حوسبة أقل، مما يجعلها قوية لحالات استخدام البث في الوقت الفعلي حيث يكون الحد الأدنى من التأخير أكثر أهمية من الطبيعية. تعتمد Cartesia على واجهة برمجة التطبيقات (API) للمطورين ولا تقدم منتجاً للمستهلكين. تعتبر Sesame الخيار الأفضل للتطبيقات التي تعطي الأولوية لعمق المحادثة على السرعة المجردة. ولمقارنة خيارات الاستضافة الذاتية مفتوحة المصدر، تقدم OpenVoice مساراً مختلفاً لتحويل النص إلى كلام (TTS) مفتوح المصدر، بينما تتولى Whisper جانب تحويل الكلام إلى نص في أي مسار هجين.
"لقد جعلوا نسخة مقيدة من Sesame (1B) مفتوحة المصدر، وليست النسخة التي يستخدمونها في العرض التجريبي الفعلي."، thehamkercat، Hacker News، 13 مارس 2025
واقع الترخيص وحقوق النشر
تم إصدار الأوزان المفتوحة لـ CSM-1B بموجب ترخيص Apache 2.0، وهو أحد أكثر التراخيص التجارية مفتوحة المصدر تساهلاً. يمكن للمطورين استخدام النموذج في المنتجات التجارية، وتعديله، وإعادة توزيعه دون الدفع لشركة Sesame. لا يوجد شرط حقوق متروكة (copyleft) فيروسي. يضع هذا CSM-1B في فئة مختلفة عن العديد من واجهات برمجة التطبيقات الصوتية التجارية حيث يحمل كل ملف صوتي يتم إنشاؤه قيوداً على الاستخدام أو فواتير بالدقيقة.
ومع ذلك، يأتي العرض التجريبي المستضاف مع مجموعة مختلفة من الاعتبارات. تنص Sesame صراحةً على أنها تراجع المحادثات لأغراض البحث والتحسين. يجب على مستخدمي واجهة app.sesame.com المستضافة التعامل مع محادثاتهم على أنها غير خاصة. بالنسبة للمحادثات الشخصية أو القانونية أو الطبية الحساسة، فإن المنتج المستضاف غير مناسب. تتجنب أوزان CSM-1B المستضافة ذاتياً هذا القلق للمستخدمين التقنيين المستعدين لبناء مسارهم الخاص على بنيتهم التحتية الخاصة.
فيما يتعلق باستنساخ الصوت: عندما اختبرت TechCrunch نموذج CSM-1B في مارس 2025، نجح أحد المراسلين في استنساخ صوته في أقل من دقيقة باستخدام الأوزان المفتوحة، ثم قام بتوليد مقطع صوتي لنفسه يقول أشياء لم يقلها. وأشارت Consumer Reports في ذلك الوقت إلى أن أدوات استنساخ الصوت كفئة تفتقر إلى ضمانات "مجدية" لمنع الاحتيال. لا تمتلك Sesame أي ضوابط تقنية تمنع ذلك في جانب الأوزان المفتوحة. تختلف شخصيتا Maya و Miles المستضافتان عن استنساخ صوت المستخدم، لكن قدرة النموذج الأساسي حقيقية. يتحمل المطورون الذين ينشرون CSM-1B في تطبيقات الإنتاج مسؤولية تنفيذ الضمانات المناسبة. يتوافق هذا مع كيفية تعامل معظم نماذج الذكاء الاصطناعي مفتوحة المصدر مع مخاطر الاستخدام المزدوج، ولكن من الجدير معرفة ذلك قبل البناء عليه. تفرض كل من PlayHT و ElevenLabs تحققاً أكثر صرامة من الموافقة لاستنساخ الصوت في منتجاتهما المستضافة.
أين تقصر Sesame AI بشكل ملحوظ
تعتبر الفجوة بين العرض التجريبي والإصدار مفتوح المصدر هي الإحباط الأكثر توثيقاً. دربت Sesame ثلاثة أحجام من النماذج ولكنها أصدرت أصغرها فقط. لم يتم توفير نموذج 8B المستخدم في عروض Maya و Miles كمصدر مفتوح اعتباراً من مايو 2026. وجد المطورون الذين تحمسوا للعرض التجريبي الواسع الانتشار ثم قاموا بتنزيل الأوزان المفتوحة تجربة مختلفة بشكل ملحوظ. وصف مستخدمو Hacker News الإصدار بأنه "نسخة مقيدة"، وتظهر سلاسل المشكلات على GitHub طلباً مستمراً للأوزان الأكبر ولرمز التدريب، ولم تلتزم Sesame بإصدار أي منهما.
الجودة المقتصرة على اللغة الإنجليزية هي القيد الثاني المستمر. كانت مجموعة بيانات التدريب عبارة عن ما يقرب من مليون ساعة من الصوتيات باللغة الإنجليزية في الغالب؛ وتقر Sesame بأن الصوتيات غير الإنجليزية قد تسربت إلى مجموعة التدريب بدلاً من أن يتم تنسيقها عن قصد. يحصل المستخدمون الذين يحتاجون إلى الإسبانية أو الفرنسية أو الماندرين أو لغات أخرى على نتائج متدهورة بشكل ملحوظ. تتضمن خارطة الطريق المعلنة دعماً لأكثر من 20 لغة، ولكن لم يتم تأكيد أي جدول زمني.
بالنسبة للمنتج المستضاف، تظل حدود طول الجلسة إحباطاً عملياً. خمس دقائق بدون حساب ليست كافية لتكوين حكم حول جودة المحادثة. ثلاثون دقيقة مع حساب مجاني أفضل ولكنها لا تزال مقيدة لتطبيق يتم الترويج له على أنه "مرافق دائم الاتصال". النسخة التجريبية لنظام iOS مغلقة؛ ولم يتم الإعلان عن تواريخ التوفر العام.
لا يعتبر Maya و Miles مساعدين للمعلومات الواقعية. فهما لا يمتلكان إمكانية الوصول إلى الويب أو المعلومات في الوقت الفعلي. في المحادثات الممتدة، سيقومان بتوليد إجابات تبدو معقولة للأسئلة الواقعية ولكنها قد تكون غير صحيحة. المستخدمون الذين يحتاجون إلى واجهة صوتية للمعلومات الحالية سيكون من الأفضل لهم إقران نظام معزز بالاسترجاع (RAG) مع طبقة TTS بدلاً من استخدام المساعدين المستضافين من Sesame لأي شيء يتطلب الدقة.
على جانب الاستضافة الذاتية: يتطلب تشغيل CSM-1B وحدة معالجة رسومات CUDA، مما يعني أنه غير عملي لمعظم الأفراد الذين لا يمتلكون وصولاً إلى وحدات معالجة الرسومات السحابية. توجد تطبيقات مجتمعية لأجهزة Apple Silicon (M1/M2/M3 عبر MLX) ولكنها لم تكن مدعومة رسمياً اعتباراً من تاريخ البحث. أبلغ بعض مستخدمي HN عن توقفات لعدة ثوانٍ في توليد الكلام على أجهزة M1. يتطلب النموذج أيضاً نموذجاً لغوياً كبيراً (LLM) منفصلاً لتوجيه الجانب اللغوي لأي تطبيق تخاطبي، مما يضيف نظاماً آخر يجب إدارته.
لمن تصلح Sesame AI
تعد Sesame AI خياراً قوياً للمستخدمين الذين يرغبون في ممارسة المحادثة المنطوقة، وخاصة متعلمي اللغات الذين يعملون على طلاقة اللغة الإنجليزية والذين يستفيدون من محاور صبور يمكنه الحفاظ على نقاش لمدة 30 دقيقة دون تعب. كما أنها مناسبة جداً للتفكير بصوت عالٍ: سيجد العاملون في مجال المعرفة والمطورون الذين يعالجون الأفكار من خلال التحدث عنها أن ردود Maya التي تطيل الحوار أكثر إنتاجية من روبوتات الدردشة التقليدية. جودة المحادثة مختلفة حقاً عن منتجات الذكاء الاصطناعي الصوتي الأخرى.
بالنسبة للمطورين، يعد CSM-1B بموجب ترخيص Apache 2.0 أحد أكثر نماذج توليد الكلام مفتوحة المصدر التي يمكن الوصول إليها. يمكن للفرق التي تبني واجهات صوتية للألعاب، أو القصص التفاعلية، أو النماذج الأولية لخدمة العملاء، أو أدوات إمكانية الوصول دمجها تجارياً دون تكاليف ترخيص. وهو يقترن بشكل طبيعي مع النماذج اللغوية الكبيرة مفتوحة المصدر (Llama 3، Mistral، Qwen) للحصول على حزمة محادثة صوتية مستضافة ذاتياً بالكامل.
تجاوز Sesame AI إذا كنت بحاجة إلى دقة واقعية، أو دعم متعدد اللغات، أو زمن وصول أقل من 100 مللي ثانية. إذا كان تطبيقك يتطلب نوع عمق استنساخ الصوت ومكتبة الأصوات التي توفرها ElevenLabs أو PlayHT، أو إذا كنت بحاجة إلى تصنيف المشاعر في الوقت الفعلي من تدفق الإدخال الذي تقدمه Hume AI، فإن هذه الأدوات تحل أجزاء مختلفة من مشكلة الذكاء الاصطناعي الصوتي. مساهمة Sesame المحددة هي الطبيعة التخاطبية الشاملة باللغة الإنجليزية مع أوزان مفتوحة، وهذا ما تفعله بشكل أفضل من أي شيء آخر متاح حالياً.
تقييمات المستخدمين
لا توجد تقييمات بعد. كن أول من يشارك تجربته!
سجّل الدخول لكتابة تقييم.
ظهرت في مجموعات
قوائم منتقاة تتضمّن Sesame AI.
مقالات ذات صلة
أدلة ومقالات ذات صلة بـ Sesame AI.

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
Build a 70-Language Live Voice Agent With GPT-Realtime-Translate (2026)

Google vs OpenAI vs Anthropic Agents: The May 2026 Platform Showdown
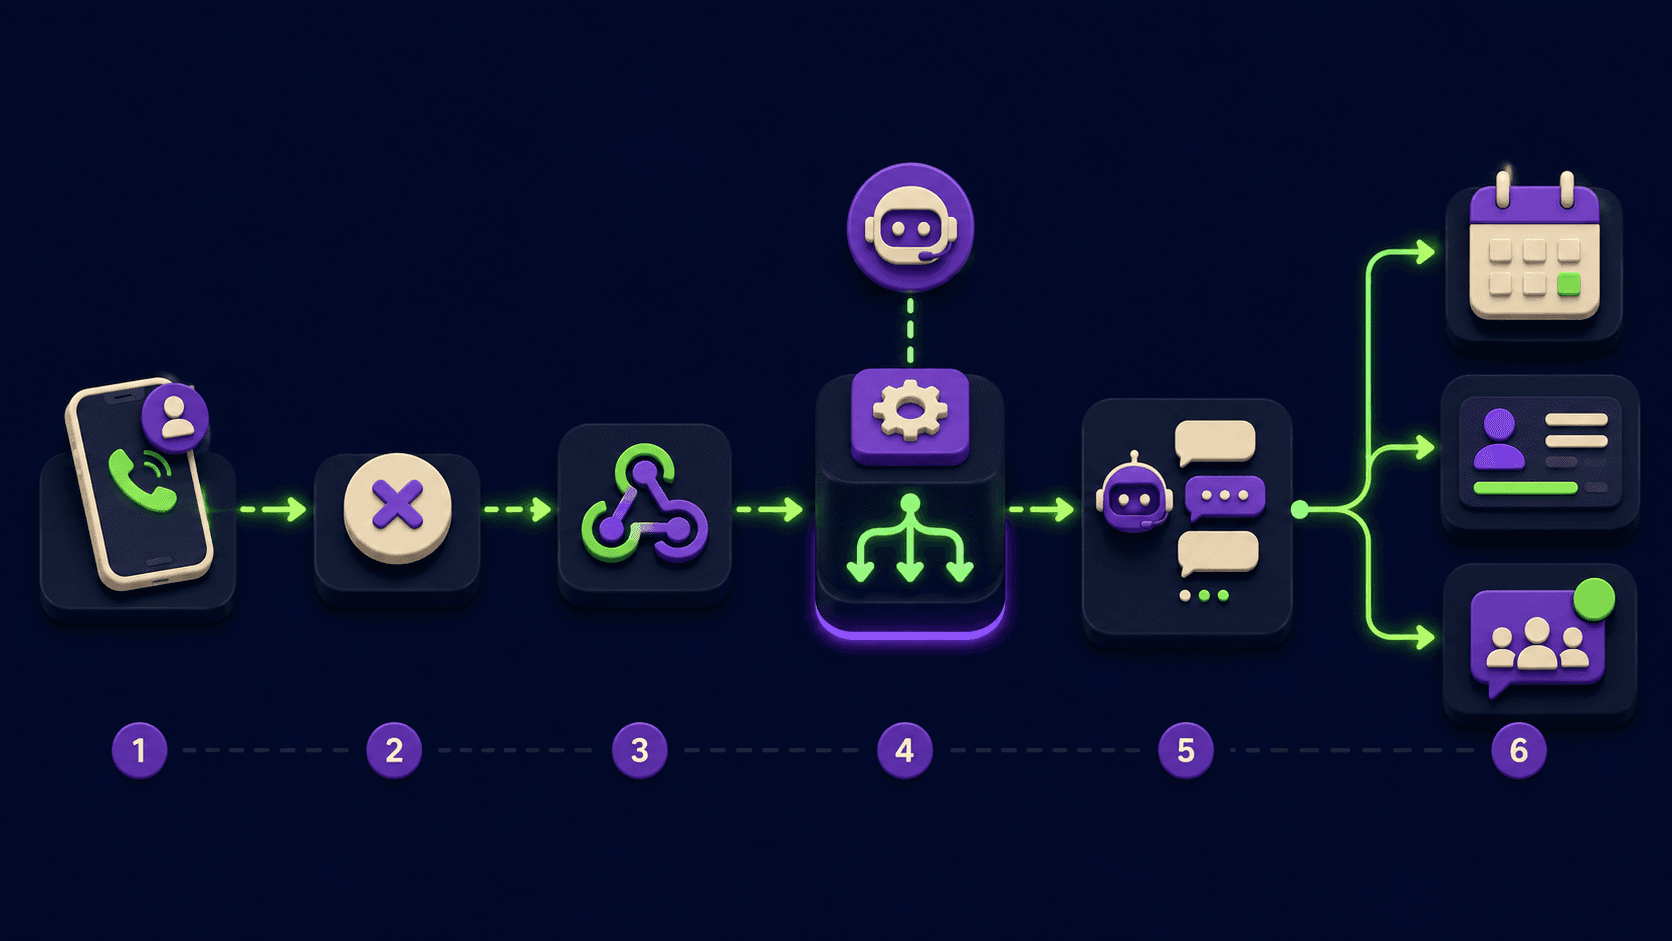
Voice Agent for Missed Calls: Every Service Business Is Bleeding Leads After Hours (2026)

Grok 4.3 API for Agents (May 2026): Pricing, Benchmarks, Migration