
SWE-Agent es un agente de ingeniería de software autónomo de código abierto de Princeton University que utiliza una interfaz agente-computadora (Agent-Computer Interface) personalizada para resolver problemas de GitHub, corregir errores y abordar desafíos de ciberseguridad. Gratuito, con licencia MIT y agnóstico al modelo.
SWE-Agent es un agente de ingeniería de software autónomo creado por investigadores de Princeton University y Stanford University. Lanzada en 2024 y presentada en NeurIPS 2024, la herramienta toma la URL de un problema (issue) de GitHub e intenta escribir un parche que lo resuelva, utilizando el modelo de lenguaje que se le proporcione. El proyecto es mantenido por John Yang, Carlos Jimenez, Kilian Lieret y Ofir Press bajo el grupo Princeton NLP. Es gratuito, tiene licencia MIT y se aloja completamente en tu propia infraestructura.
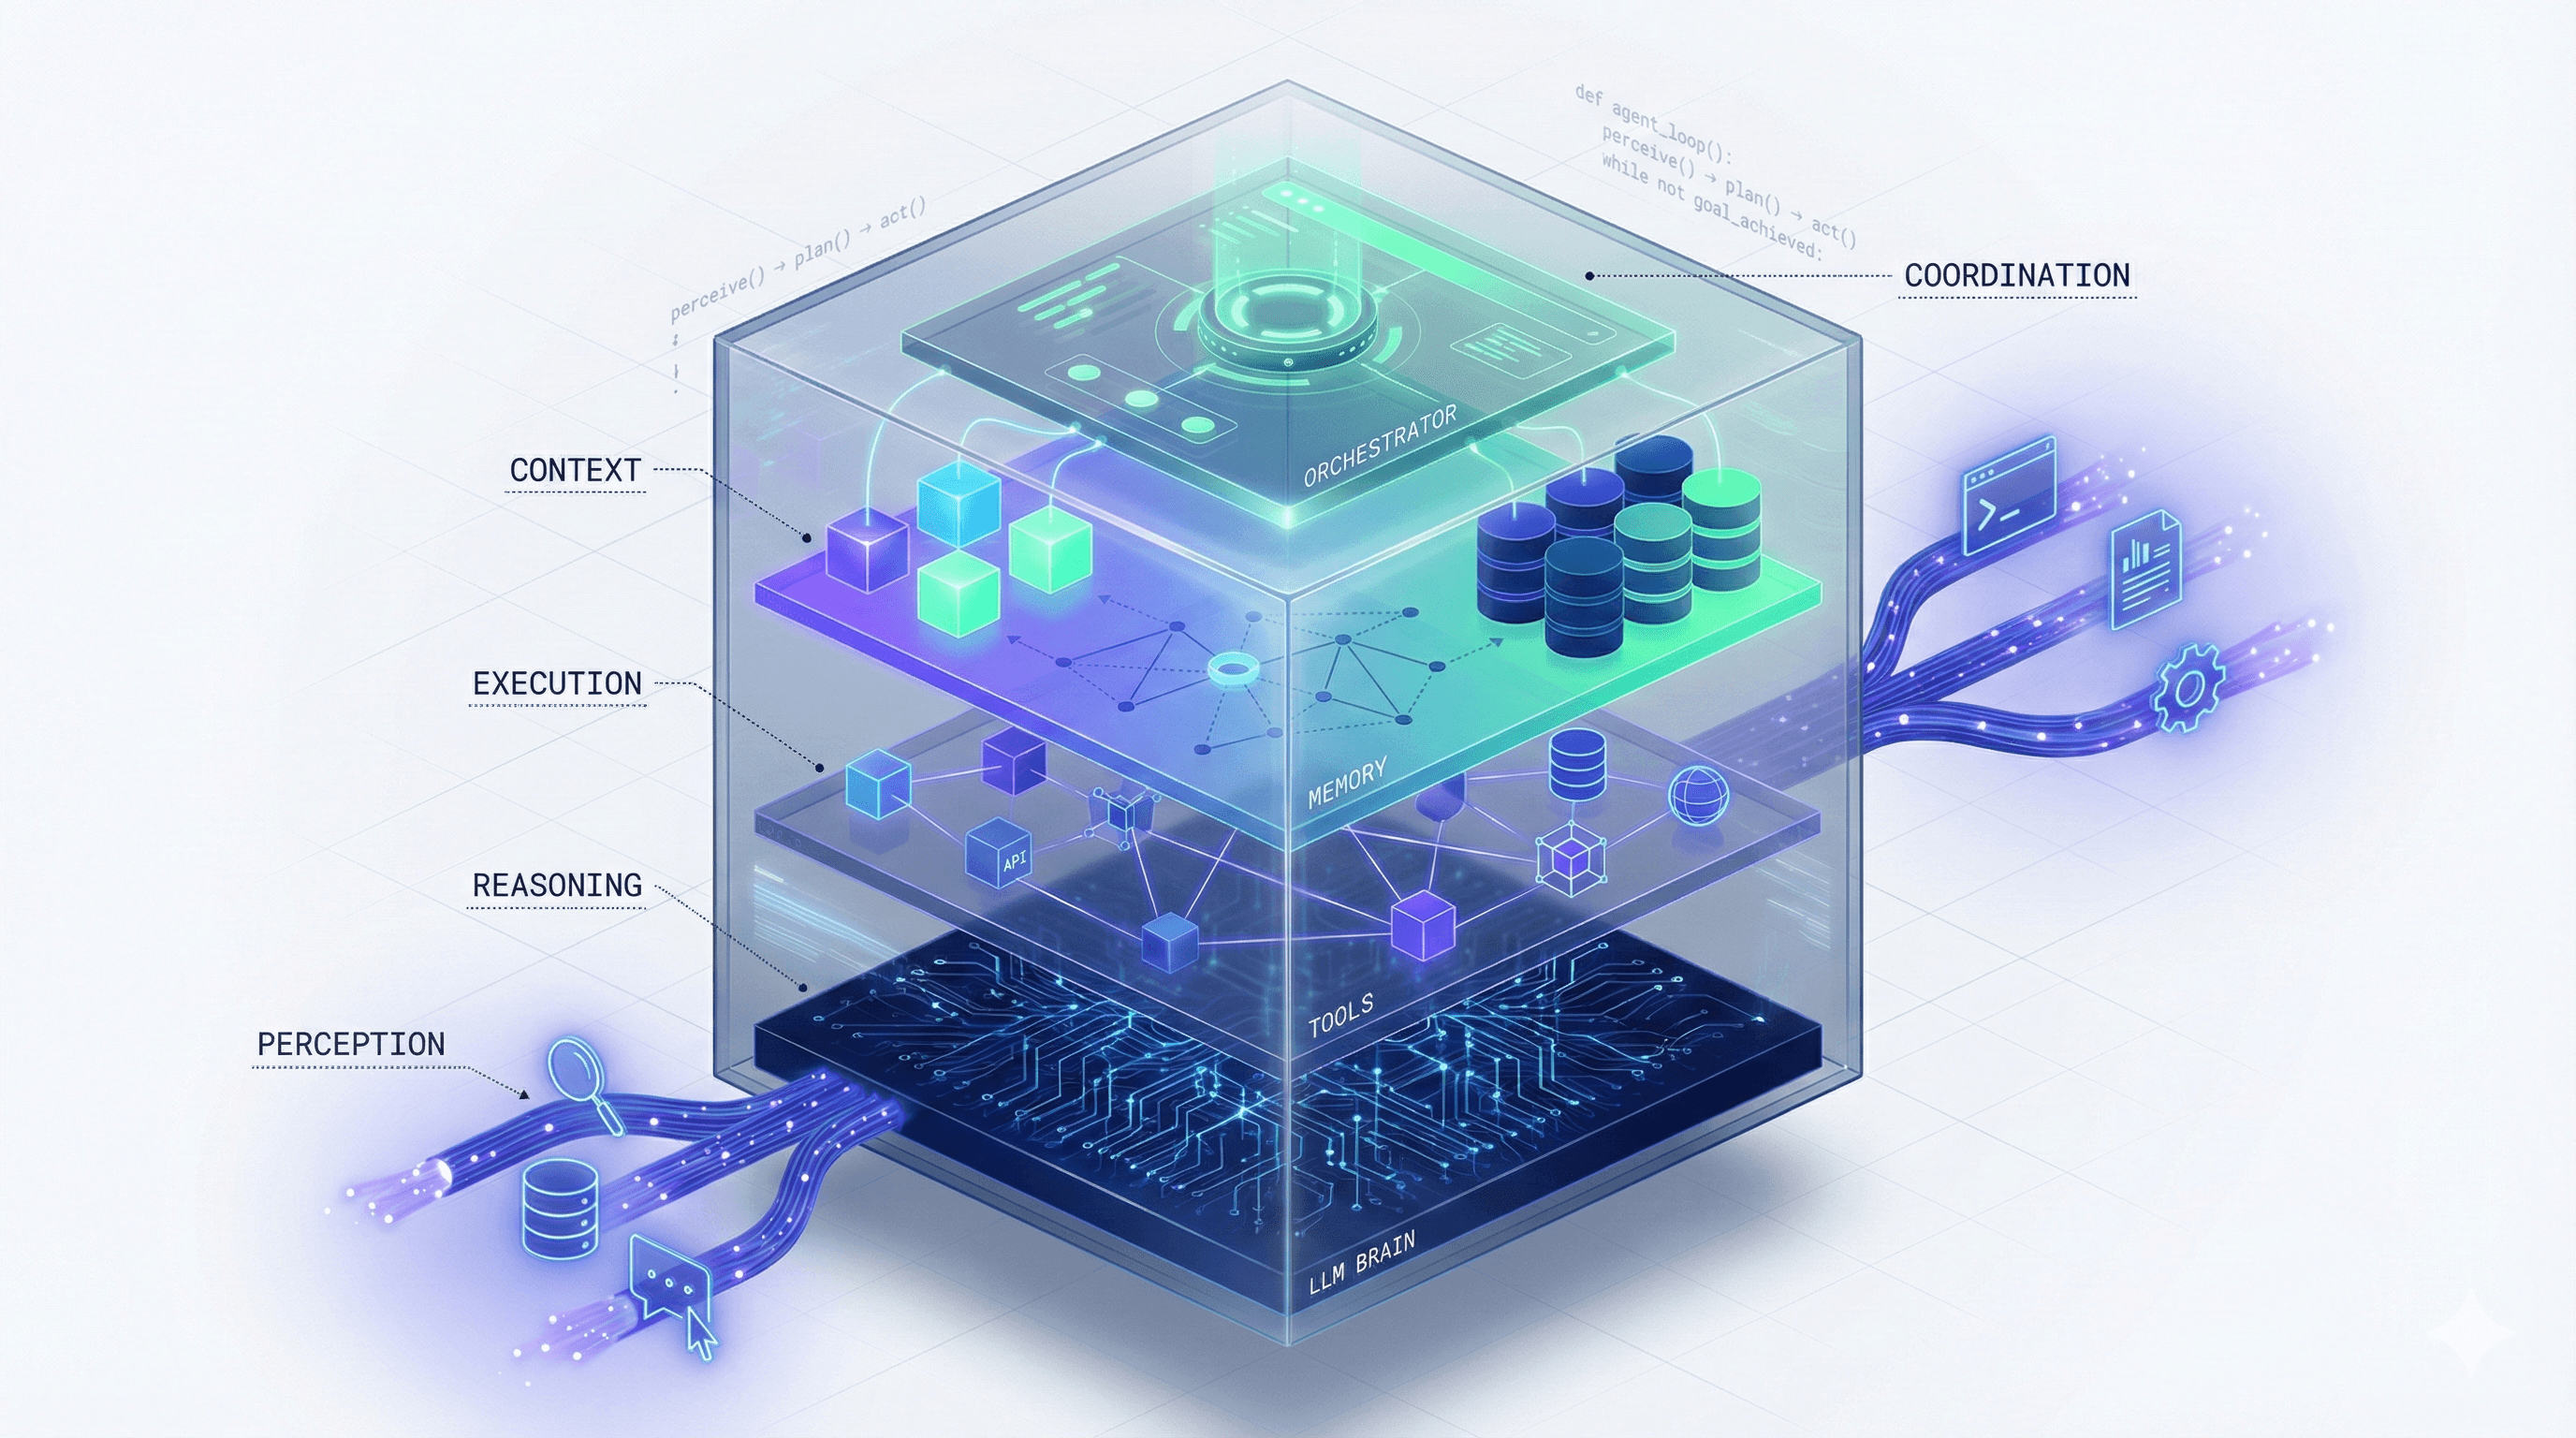
La idea definitoria del agente es la interfaz agente-computadora (Agent-Computer Interface o ACI), una capa de abstracción diseñada específicamente que reemplaza el acceso directo a la terminal (shell) con comandos estructurados optimizados para la forma en que los modelos de lenguaje procesan la información. La visualización, búsqueda y edición de archivos se presentan como operaciones concisas y delimitadas en lugar de llamadas de terminal abiertas. El mismo modelo GPT-4 obtiene aproximadamente el doble de puntuación en SWE-bench cuando se le proporcionan herramientas ACI en lugar de bash sin procesar, un hallazgo detallado en el artículo de NeurIPS 2024. Más allá de la resolución de problemas, SWE-Agent incluye el modo EnIGMA para tareas de ciberseguridad ofensiva y admite el procesamiento por lotes, la configuración completa basada en YAML y el entorno de ejecución SWE-ReX para la ejecución paralela en la nube. La variante del proyecto, mini-SWE-agent, con aproximadamente 100 líneas de Python, obtiene más del 74% en SWE-bench Verified utilizando un modelo de frontera moderno.
Lo que realmente hace SWE-Agent en mayo de 2026
En su núcleo, SWE-Agent acepta la URL de un problema de GitHub y una clave API del modelo, y luego ejecuta un bucle autónomo que lee el repositorio, reproduce el error, edita el código y prueba la solución. El bucle del agente es impulsado por la ACI: cada vista de archivo está delimitada para evitar el desbordamiento del contexto, las ediciones pasan por un linter que revierte automáticamente la sintaxis rota, y el estado del agente (archivo actual, posición del cursor) es rastreado por el entorno de ejecución en lugar de inferirse del historial de conversación.
La versión estable actual es la v1.1.0 (22 de mayo de 2025), que introdujo la generación de trayectorias SWE-smith y el modelo de pesos abiertos SWE-agent-LM-32b. La arquitectura es compatible con cualquier LLM a través de litellm, incluyendo OpenAI, Anthropic, Google y modelos locales. La ejecución paralela es manejada por SWE-ReX, que puede enrutar ejecuciones en entornos aislados (sandbox) a backends de Docker, AWS, Modal o Fargate. Cada ejecución produce un archivo de trayectoria estructurado adecuado para la reproducción de investigaciones, el ajuste fino (fine-tuning) o la auditoría.
EnIGMA, introducido en la v0.7.0 (septiembre de 2024), es un modo independiente para desafíos de ciberseguridad del tipo captura la bandera (CTF). Añade herramientas interactivas para agentes (Interactive Agent Tools) y un resumidor para manejar salidas largas de terminal de scripts de explotación, logrando una mejora de 3.3x sobre agentes anteriores en el benchmark NYU CTF. EnIGMA se presentó como un artículo independiente en ICML 2025.
El proyecto mini-SWE-agent, lanzado a mediados de 2025, adopta la filosofía opuesta: reducir todo a una sola herramienta bash y un simple bucle ReAct. Logra más del 74% en SWE-bench Verified utilizando Gemini o Claude, igualando el rendimiento del agente completo con 100 veces menos código. Para los nuevos usuarios que desean resultados sin configuración YAML, el equipo de Princeton ahora recomienda comenzar con mini-SWE-agent en lugar del framework completo.
"La idea de que bash es todo lo que un LLM moderno necesita para resolver tareas de codificación es muy validadora. Muy instructivo e inspirador para empezar a programar." - scottyeager, Hacker News, julio de 2025
Dónde se sitúa SWE-Agent frente a OpenHands y Aider
Tres agentes de codificación de código abierto dominan las tablas de clasificación de investigación: SWE-Agent, OpenHands y Aider. Comparten una misión, pero difieren mecánicamente en casi todas las dimensiones.
SWE-Agent vs OpenHands: OpenHands se ejecuta dentro de contenedores Docker con una arquitectura de flujo de eventos: el agente produce acciones, el entorno las ejecuta y devuelve observaciones, y el bucle continúa. Cada sesión obtiene acceso SSH, un kernel de Jupyter para la ejecución de Python y una interfaz BrowserGym para la automatización web. La delegación multiagente es nativa: un agente principal puede crear subagentes para subtareas específicas e integrar sus resultados. OpenHands también incluye una interfaz de usuario web pulida y una extensión para VSCode. SWE-Agent no tiene nada de eso. Es solo CLI, no tiene interfaz web y su soporte multiagente es experimental. Lo que SWE-Agent tiene y de lo que OpenHands carece es el modo de ciberseguridad de EnIGMA, una superficie de configuración YAML más profunda para investigadores y el motor de ejecución paralela SWE-ReX. OpenHands se adapta a los equipos que desean un desarrollador autónomo de propósito general. SWE-Agent se adapta a los investigadores y desarrolladores que desean controlar cada parte del bucle del agente.
SWE-Agent vs Aider: Aider prioriza git: cada edición se convierte en un commit con nombre y autoconfirmado en el historial de tu repositorio. Aider se ejecuta de forma interactiva desde la terminal, sobresale en el intercambio colaborativo con un desarrollador y utiliza aproximadamente 4.2 veces menos tokens por tarea porque se mantiene superficial en el contexto del repositorio. SWE-Agent se ejecuta de forma no interactiva en modo autónomo, genera trayectorias estructuradas y tiene un techo de SWE-bench mucho más alto porque la ACI permite un recorrido más profundo del repositorio. Aider es mejor para sesiones de codificación iterativas y en pareja. SWE-Agent es mejor para la resolución de problemas asíncrona y totalmente automatizada sin un desarrollador en el bucle. Ninguno de los dos tiene un modo de ciberseguridad; eso sigue siendo exclusivo de la variante EnIGMA de SWE-Agent.
En el contexto comercial, tanto SWE-Agent como OpenHands superan significativamente a Devin en precio (gratuito frente a facturación por ACU) al tiempo que igualan o superan su rendimiento en los benchmarks. Cursor y Cline ocupan un nicho diferente, autocompletado y chat integrados en el IDE en lugar de resolución autónoma de problemas, por lo que complementan en lugar de competir directamente con SWE-Agent.
"SWE-bench solo prueba la resolución de problemas en repositorios de Python, lo que limita el valor predictivo para escenarios del mundo real en diferentes lenguajes y tipos de tareas." - ToolHalla AI, análisis comparativo, 2026
Cómo es la realidad del bucle del agente
La ejecución de SWE-Agent sigue un patrón consistente. Se instala a través de pip install sweagent, se configura la clave API del LLM en las variables de entorno y se invoca la CLI con la URL de un problema de GitHub y el modelo elegido. El agente clona el repositorio en un entorno aislado, lee el problema, explora los archivos relevantes a través de comandos ACI, realiza ediciones específicas e intenta ejecutar el conjunto de pruebas. La ejecución produce un archivo de parche y un registro de trayectoria.
El diseño de la ACI es lo que separa una ejecución exitosa de una fallida. En repositorios con problemas claros y bien especificados y cobertura de pruebas en Python, el agente resuelve una fracción significativa de los problemas sin intervención humana. En problemas ambiguos ("se bloqueó en mi máquina"), el agente falla limpiamente o produce un parche plausible pero incompleto. El benchmark SWE-bench-Live, que prueba problemas verdaderamente novedosos sin contaminación del conjunto de datos, muestra tanto a SWE-Agent como a OpenHands en aproximadamente un 18-20%, una brecha aleccionadora con respecto a los números de más del 70% en benchmarks seleccionados. El uso real en producción requiere la revisión humana de cada parche propuesto.
La versión 1.0 de SWE-Agent de febrero de 2025 introdujo SWE-ReX, que hizo práctica la evaluación paralela. Los investigadores ahora pueden ejecutar cientos de intentos de resolución de problemas simultáneamente a través de backends de Modal o AWS. Para los equipos que evalúan la calidad de los agentes a escala, esto elimina el cuello de botella del tiempo real que hacía que la ejecución secuencial original fuera poco práctica para grandes acumulaciones de trabajo.
El costo de los tokens es una incertidumbre recurrente. SWE-Agent no muestra estimaciones de costos por ejecución antes de la misma. El costo depende completamente de la elección del modelo, la complejidad del problema y cuántos turnos de ACI toma el agente. Los usuarios experimentados informan un promedio de varios cientos de miles de tokens por problema complejo utilizando Claude o GPT-4o, lo que se traduce en $1-5 por problema a las tarifas actuales de la API. Para el procesamiento por lotes, el equipo recomienda las API por lotes a nivel de proveedor para reducir los costos en un 50%.
La actualización v1.0 también introdujo cambios importantes que tomaron a algunos usuarios por sorpresa. El campo messages en los datos de trayectoria pasó a llamarse query, los paquetes de herramientas cambiaron de nombre y la estructura de subcomandos de la CLI cambió significativamente. Los equipos que ejecutaban SWE-Agent como parte de los canales de evaluación tuvieron que actualizar sus herramientas. El equipo documentó los cambios en las notas de migración, pero la rotación fue un costo real para cualquiera que no siguiera de cerca el repositorio. La disciplina de versiones es más importante con SWE-Agent que con la mayoría de las herramientas de código abierto porque el ritmo de investigación es rápido y el equipo prioriza las mejoras en los benchmarks sobre la estabilidad de la API.
Para quién está creado SWE-Agent
SWE-Agent fue creado primero para investigadores. El sistema de configuración YAML, el registro de trayectorias, el soporte para paquetes de herramientas personalizados y el linaje de artículos académicos apuntan a una herramienta que espera que sus usuarios lean la documentación y modifiquen el código fuente. Las 19,100 estrellas en GitHub y las citas de IBM, NVIDIA, Meta, Nebius y Anyscale reflejan a esa audiencia. Se adopta ampliamente en los laboratorios de investigación de ML como la línea base a superar para los nuevos diseños de agentes.
Más allá de la investigación, SWE-Agent se adapta a desarrolladores independientes y equipos pequeños que desean una clasificación autónoma de problemas. El flujo de trabajo es: alimentar al agente con una acumulación de problemas etiquetados de GitHub, revisar los parches que genera y fusionar los que pasan la CI. Esto no es una solución llave en mano, requiere familiaridad con tu conjunto de pruebas y una revisión cuidadosa, pero es un flujo de trabajo real que los equipos informan que ahorra horas por semana en correcciones de errores bien especificadas.
EnIGMA abre un segmento de usuarios distinto: investigadores de seguridad y competidores de CTF. La mejora de 3.3x en los desafíos de NYU CTF y los resultados de CyBench lo convierten en una de las herramientas de pruebas de penetración automatizadas de libre disponibilidad más sólidas. Los equipos de seguridad en universidades y empresas orientadas a la investigación son los principales adoptantes aquí.
Lo que SWE-Agent no es
SWE-Agent no es un producto para usuarios no técnicos. No hay una interfaz de usuario web alojada, ni una instalación con un solo clic para no desarrolladores, ni atención al cliente más allá de los problemas de GitHub y la comunidad de Discord. Si tus criterios de evaluación incluyen una interfaz pulida, considera OpenHands en su lugar.
No es un asistente de codificación persistente. A diferencia del modo interactivo de Aider o las herramientas basadas en IDE como Cursor, SWE-Agent no tiene memoria entre ejecuciones. El agente comienza de cero en cada invocación. Los usuarios que esperan que acumule conocimientos sobre su base de código a lo largo de las sesiones se sentirán decepcionados. Existen soluciones alternativas (proporcionar el contexto del proyecto en la configuración YAML), pero son manuales.
No es un reemplazo para el juicio del desarrollador sobre la calidad del parche. El rendimiento de SWE-bench Verified en los altos 70 es impresionante, pero esos benchmarks están seleccionados. Los repositorios del mundo real con cobertura de pruebas parcial, especificaciones ambiguas y dependencias entre lenguajes reducen sustancialmente el rendimiento. Cada parche de SWE-Agent que pasa a producción debe pasar por tu canal de CI y recibir una revisión de código humana.
No es un producto comercial con SLA de proveedores, soporte empresarial o certificaciones de cumplimiento. Para los equipos que necesitan tiempo de actividad garantizado, pistas de auditoría o integración SSO, el nivel empresarial de Devin o una alternativa administrada es más apropiado.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Destacado en colecciones
Listas seleccionadas que incluyen SWE-Agent.
Artículos relacionados
Guías y artículos relacionados con SWE-Agent.

Claude Code vs Cursor vs Codex vs Devin vs Replit Agent 3: 2026 Scorecard
SWE-bench Pro Explained: Why the Benchmark Changed (2026)

Run a Company With AI Agents: The Open-Source Orchestration Setup (2026)

Turn Any AI Agent Into a Superagent: The 12-Integration Stack (2026)
AI Security Tools for Small Teams (2026): The Stack That Doesn't Need a SOC