
Vapi es una plataforma de infraestructura de voz con IA para crear e implementar agentes telefónicos a gran escala. Permite a los desarrolladores integrar su propio LLM, TTS y pila de telefonía, gestionando la orquestación en tiempo real, los turnos de conversación y la llamada a funciones en más de 100 idiomas.
Vapi es una plataforma de infraestructura de IA de voz que permite a los desarrolladores crear, implementar y escalar agentes telefónicos de IA utilizando los modelos de lenguaje, proveedores de voz y operadores de telefonía de su elección. Fundada por Jordan Dearsley y Nikhil Gupta, ingenieros de la University of Waterloo y graduados de Y Combinator W23, la empresa recaudó una Serie A de $20M liderada por Bessemer Venture Partners en diciembre de 2024. No es un proveedor de voz alojado ni un creador de chatbots sin código. Es un middleware de orquestación: una capa programable que conecta a tus proveedores de STT, LLM y TTS en tiempo real, maneja la detección de turnos y la lógica de interrupción, gestiona la llamada a funciones contra API externas y ejecuta todo el proceso a través de una conexión WebSocket persistente con una latencia de extremo a extremo inferior a 500ms en condiciones óptimas.
A partir de abril de 2026, Vapi reporta más de 500,000 desarrolladores en la plataforma, más de 300M de llamadas procesadas y más de 2.5M de asistentes lanzados. Las capacidades principales incluyen soporte para traer tu propio modelo (BYOM) a través de OpenAI, Anthropic, Groq, Google, Together AI y endpoints de LLM personalizados; proveedores de voz que incluyen ElevenLabs, Azure, Deepgram y las propias voces seleccionadas de Vapi; telefonía a través de Twilio, Vonage, Telnyx o troncales SIP que ya poseas; pruebas A/B para la optimización de prompts y voz; detección automatizada de alucinaciones; y una API REST además de SDKs para TypeScript, Python y React. Los equipos utilizan Vapi para soporte al cliente entrante, programación de citas salientes, marcación de ventas, admisión de pacientes en el sector salud y asistentes de voz en tiempo real en productos.
Lo que Vapi realmente hace en abril de 2026
La arquitectura de Vapi es un flujo de audio en tiempo real que conecta tres capas de proveedores externos: conversión de voz a texto (transcripción), un modelo de lenguaje (razonamiento y generación de respuestas) y conversión de texto a voz (salida de voz). Cada fragmento de audio entrante fluye a través de este proceso en secuencia, y Vapi gestiona la orquestación: detectando cuándo el usuario deja de hablar, suprimiendo falsos positivos (ruido de fondo, respiración), enrutando la transcripción al LLM, inyectando resultados de llamadas a funciones si el agente necesita consultar una API externa, y convirtiendo la respuesta del LLM en audio con el proveedor de voz elegido antes de devolverla a la llamada.
La plataforma soporta más de 100 idiomas con detección y adaptación automáticas. El manejo de conversaciones simultáneas escala con el plan: el nivel de pago por uso tiene un límite de 10 llamadas simultáneas; los planes empresariales no tienen límite. La llamada a funciones permite a los agentes consultar CRMs (Salesforce, HubSpot), sistemas de tickets (Zendesk), bases de datos o cualquier API REST durante una llamada en vivo, con los resultados inyectados en el contexto de la conversación. Los webhooks se activan al inicio de la llamada, al final de la llamada, al completar la transcripción y en eventos de llamadas a funciones, lo que facilita la sincronización de los datos de la conversación con sistemas posteriores en tiempo real.
El panel de control proporciona un creador de asistentes sin código para la creación de prototipos, pero todo el poder de la plataforma reside en la API. Puedes crear y configurar asistentes programáticamente, gestionar números de teléfono, ejecutar campañas de llamadas, extraer transcripciones y acceder a grabaciones a través de la API REST. El soporte para pruebas A/B permite a los equipos ejecutar variantes paralelas en la configuración de voz, prompt y modelo, y comparar las tasas de conversión o resolución en una muestra de llamadas.
"Un requisito técnico clave era la capacidad de traer nuestra propia pila. El enfoque centrado en la API y amigable para los desarrolladores de Vapi lo hizo posible." - Quang Tran, CTO en FleetWorks, vapi.ai, abril de 2026
En diciembre de 2024, el socio de Bessemer, Byron Deeter, citó la "mejora 10x en la experiencia de desarrollo para agentes de voz" de Vapi como la tesis de inversión principal, señalando un modelo de audio en tiempo real patentado que detecta inflexiones emocionales en las voces de las personas que llaman. La empresa se posiciona explícitamente como infraestructura en la tradición de Twilio/AWS: "hacemos el motor que impulsa la magia". Se ha informado que las solicitudes de funciones enviadas los viernes por la noche se han implementado en producción para el sábado por la mañana, un ritmo que se ganó la lealtad de la comunidad en la fase inicial de crecimiento.
Dónde se sitúa Vapi frente a Retell AI y Bland AI
Vapi vs. Retell AI: Retell es una plataforma gestionada y empaquetada. Proporciona una pila todo en uno que incluye transcripción, un conjunto seleccionado de integraciones de LLM, conectores nativos de CRM y aprovisionamiento de números de teléfono integrado en muchos países. Los usuarios pagan una tarifa única por minuto que comienza alrededor de $0.07/min y que cubre STT, LLM y TTS en conjunto. Sin contratos separados de Deepgram o ElevenLabs. El enfoque gestionado de Retell elimina la latencia de la API de múltiples saltos que introduce la capa de orquestación de Vapi cuando cualquier proveedor externo es lento. Las pruebas han demostrado que Retell logra una latencia de extremo a extremo de 500-800ms de manera más consistente, mientras que el rango de Vapi se extiende a 1200ms dependiendo de qué proveedores de LLM y TTS hayas conectado. La diferencia práctica: Retell es más rápido de implementar y más fácil de presupuestar; Vapi es más flexible para equipos con una pila de modelos existente. Si has ajustado tu propio LLM o ya tienes un acuerdo de voz empresarial con ElevenLabs, Vapi te permite conectarlo directamente sin tener que reconstruir. Retell te limita a su conjunto de proveedores compatibles.
Vapi vs. Bland AI: Bland está integrado verticalmente. La empresa aloja por sí misma toda su pila de modelos ajustados en clústeres coubicados junto a la infraestructura de telefonía, eliminando por completo los saltos de API externos. Esta elección arquitectónica hace que la latencia de Bland sea más consistente en 600-1000ms independientemente de los picos de tráfico en OpenAI o Anthropic, porque esos saltos no existen. Vapi puede alcanzar una latencia de 3-4 segundos durante la carga máxima de proveedores externos. Bland también proporciona herramientas avanzadas de gestión de campañas diseñadas explícitamente para llamadas salientes de alto volumen: procesamiento por lotes, programación, lógica de reintentos y una interfaz de flujo de conversación basada en gráficos. Los precios de Bland son más simples: una tarifa por minuto con descuentos por volumen. Vapi requiere gestionar de 4 a 6 relaciones con proveedores. La división: Bland está diseñado para el reemplazo de centros de contacto empresariales a gran volumen con un modelo comercial simple; Vapi está diseñado para equipos de desarrolladores que necesitan la máxima flexibilidad de proveedores y orquestación programable. Si tu caso de uso principal es de 100,000 llamadas salientes por mes a una lista de contactos, la infraestructura de Bland está diseñada específicamente para eso. Si necesitas cambiar de LLM según el caso de uso, probar nuevos modelos de voz o enrutar diferentes tipos de llamadas a diferentes niveles de modelos, la arquitectura modular de Vapi justifica su complejidad.
"El soporte es inexistente y la documentación es extremadamente pobre. Lanzaron nuevas funciones y TODO se rompió." - Usuario verificado, Trustpilot/Product Hunt, 2025
Cómo es la realidad diaria de desarrollo
Una implementación de Vapi en producción generalmente implica configurar cuentas con tres a cinco proveedores externos antes de escribir una sola línea de lógica del agente. Como mínimo: una cuenta de Twilio o Telnyx para telefonía, una cuenta de Deepgram o Azure para STT y una cuenta de OpenAI o Anthropic para el LLM. Si deseas una voz no sintetizada, añade una cuenta de ElevenLabs. Cada uno tiene su propia facturación, gestión de claves API y límites de uso. El panel de control de Vapi consolida la configuración, pero las facturas llegan por separado.
Una vez que los proveedores están conectados, configuras un asistente a través del panel de control o la API: estableces el prompt del sistema, eliges los modelos de STT/LLM/TTS, configuras la sensibilidad a las interrupciones, defines herramientas (funciones que el agente puede llamar) y configuras webhooks. La función de llamada de prueba del panel de control te permite llamar al agente a través de un navegador. La API de creación de asistentes es limpia y está bien documentada; los desarrolladores la utilizan comúnmente para crear plantillas de asistentes para implementaciones de agencias con múltiples clientes.
El ajuste de la latencia es la parte técnicamente más exigente de operar Vapi. La latencia de extremo a extremo inferior a 500ms que afirma la plataforma requiere una selección cuidadosa de modelos de menor latencia (GPT-4o-mini sobre GPT-4o, Deepgram Nova sobre Nova-2, etc.) y no se mantiene durante los picos de tráfico de proveedores externos. En pruebas independientes en softailed.com, reducir la sensibilidad a las interrupciones por debajo de 750ms provocó que el asistente interrumpiera a las personas que llamaban a mitad de la frase. Los desarrolladores suelen ajustar la latencia para su caso de uso específico y combinación de modelos en lugar de esperar que funcione bien desde el primer momento.
El ciclo de prueba e iteración es funcional pero limitado en comparación con Retell. Las pruebas de evaluación generadas automáticamente devuelven resultados de aprobado/reprobado sin sugerencias de optimización procesables. El creador de flujos de trabajo no admite llamar a otros asistentes dentro del mismo flujo, lo cual es importante para las arquitecturas de múltiples agentes. El historial de llamadas y la recuperación de transcripciones tienen un límite de 14 días para los planes no empresariales.
Para quién está diseñado Vapi
Vapi se adapta a equipos liderados por desarrolladores que necesitan un control total sobre su infraestructura de agentes de voz. La plataforma recompensa a los equipos que ya tienen ajustes finos de LLM que desean poner a trabajar, acuerdos existentes con proveedores específicos de TTS o STT, o casos de uso que requieren enrutar diferentes tipos de llamadas a diferentes niveles de modelos. Las agencias que crean agentes de voz para múltiples clientes se benefician del enfoque centrado en la API: puedes crear y configurar asistentes programáticamente por cliente, gestionar la configuración de voz y modelo por implementación, y ejecutar todo a través de una cuenta de Vapi con claves API específicas del cliente.
Los equipos de atención médica y servicios financieros que necesitan cumplimiento con HIPAA, SOC2 o PCI pueden usar el nivel empresarial, que incluye certificaciones de cumplimiento y soporte de implementación avanzada. Las funciones de pruebas A/B y detección automatizada de alucinaciones son genuinamente valiosas para implementaciones en industrias reguladas donde la calidad de la conversación debe medirse y auditarse.
Los equipos en la etapa exploratoria obtienen un punto de partida razonable: $10 en créditos gratuitos cubren aproximadamente 150-200 minutos de llamadas de prueba con modelos de nivel medio, suficiente para construir y probar un prototipo funcional antes de comprometerse con contratos de múltiples proveedores.
Lo que Vapi no es
Vapi no es una plataforma sin código. El creador de asistentes del panel de control admite la creación de prototipos básicos, pero las implementaciones en producción con lógica condicional, llamadas a herramientas de múltiples pasos o construcción dinámica de prompts requieren que un desarrollador escriba TypeScript, Python o llamadas REST. Si necesitas que un no ingeniero construya y gestione agentes de voz, estás en el producto equivocado.
Vapi no es una plataforma de costos predecibles por debajo del nivel empresarial. Los $0.05/minuto anunciados son la tarifa de orquestación. Las implementaciones en producción que utilizan GPT-4o, ElevenLabs y Twilio suelen alcanzar los $0.25-0.35/minuto en total. El análisis de 2026 de CloudTalk sitúa el gasto anual típico de implementación empresarial en $40,000-$70,000 al modelar volúmenes de uso realistas. Ejecutar proyecciones de costos realistas requiere modelar cada capa de proveedor por separado antes de comprometerse con la plataforma.
Vapi no está optimizado para el volumen puro de marcación saliente. Bland AI ofrece herramientas de campaña, programación y gestión de lotes superiores para escenarios de reemplazo de centros de contacto. Las capacidades de campaña de Vapi requieren construir tu propia capa de orquestación sobre la API.
Vapi no es confiable durante las interrupciones de los proveedores. Debido a que el flujo depende de proveedores externos de LLM y STT, cualquier degradación en OpenAI, Anthropic, Deepgram o ElevenLabs se propaga directamente a la calidad de la llamada. Los equipos con estrictos requisitos de SLA de tiempo de actividad deben usar el nivel empresarial con infraestructura dedicada o evaluar la pila integrada verticalmente de Bland.
Finalmente, el aprovisionamiento de números de teléfono de Vapi es nativo solo para EE. UU. Las implementaciones fuera de EE. UU. y Canadá requieren importar números de Twilio o Vonage manualmente, lo que agrega fricción de configuración para casos de uso internacionales.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Artículos relacionados
Guías y artículos relacionados con Vapi.
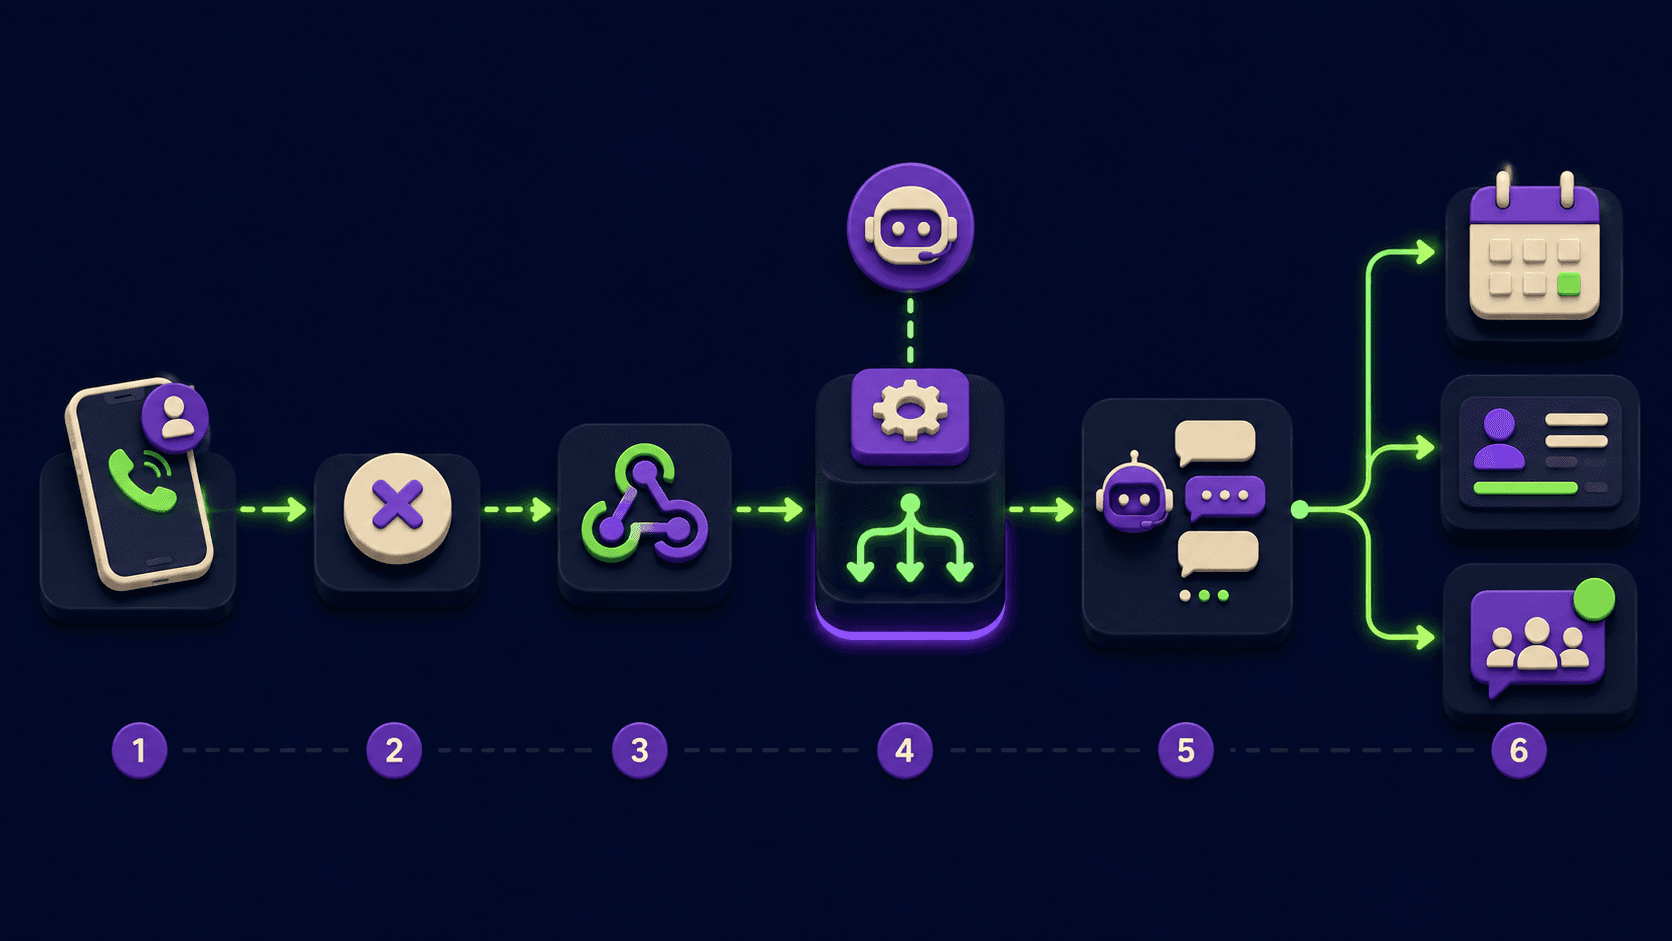
Voice Agent for Missed Calls: Every Service Business Is Bleeding Leads After Hours (2026)
AI Receptionist for Solo Professionals: Replace the Answering Service (2026)

OpenAI GPT-Realtime-2 (May 2026): Pricing, Latency & 30-Min Voice Agent
How to Sell AI Chatbots to Local Businesses ($1K-$5K Retainers, 2026)
Build a 70-Language Live Voice Agent With GPT-Realtime-Translate (2026)
