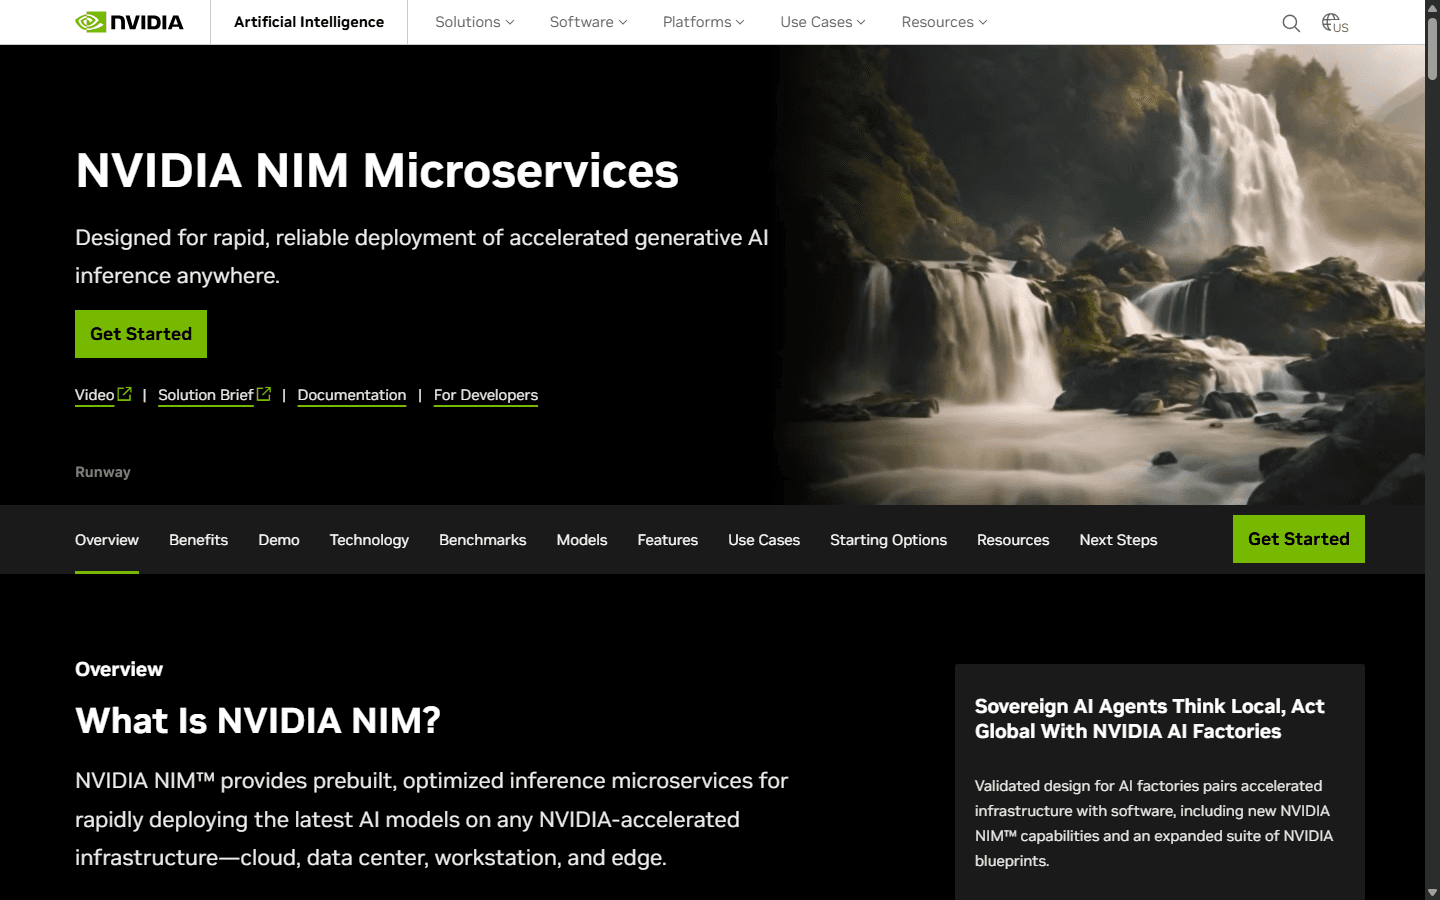
NVIDIA NIM empaca modelos de fundación como microservicios de inferencia optimizados por GPU para el despliegue de empresas. Prototyping es gratuito a través del Programa de Desarrolladores; necesidades de producción NVIDIA AI Enterprise desde $4,500 por GPU al año o alrededor de $1 por GPU-hora en la nube ( FAQ oficial, Sep 2026).
NVIDIA NIM (NVIDIA Inference Microservices) es un conjunto de contenedores preconstruidos, optimizados por GPU y puntos finales de API para el despliegue de modelos de bases para la inferencia. Cada NIM empaqueta un modelo más un tiempo de ejecución optimizado (Triton, TensorRT, TensorRT-LLM, PyTorch y motores relacionados) detrás de APIs de estilo industrial. NIM es parte de NVIDIA AI Enterprise. prototipo de desarrolladores en el catálogo hospedado en build.nvidia.com; autoanfitriona de producción requiere una licencia NVIDIA AI Enterprise.
A partir de septiembre de 2026, NVIDIA cuenta con licencias de producción oficiales NIM FAQ comenzar por 4.500 dólares por GPU al año o sobre $1 por GPU por hora en la nube, precio por cuenta de GPU (no por número de contenedores NIM), la misma tasa independientemente del tamaño de GPU. Los miembros del programa de desarrolladores de NVIDIA reciben gratuitamente prototipado de API hospedados y NIM descargables para investigación/dev/test en hasta 16 GPUs. Una licencia gratuita de evaluación NVIDIA AI Enterprise de 90 días cubre el uso de prueba de grado de producción. Hay no universal per-token NIM precio de NVIDIA para el catálogo - no inventar uno.
Qué ofrece NVIDIA NIM en septiembre de 2026
Workflow: explore modelos en el catálogo API → call hosted endpoints for POCs → pull Docker NIMs de NGC / the catalog for self-host on NVIDIA-Certified CUDA systems (on-prem or cloud) → move to AI Enterprise for production support, stable API branches, and SLAs. Los NIM cubren modelos comunitarios de código abierto, modelos de la Fundación NVIDIA AI y modelos personalizados. Las opciones sin servidor de socios (por ejemplo, Hugging Face) pueden incluir la licencia AI Enterprise en el alojamiento de pago como-vamos - ver cada página de modelo.
Dónde se sitúa NIM frente a Bedrock y fal
Amazon Bedrock vende API modelo gestionado con tablas de token públicas y sin licencia GPU matemáticas. NIM vende microservicios optimizados de inferencia que ejecuta en GPUs que controla (o hosts de socios), que gana para la residencia de datos, ventilación aérea y flotas GPU a escala de TCO. Mercados de GPU sin servidores como falte precio por segundo/por-call para los creadores; NIM se dirige a las pilas de inferencia de la empresa y el soporte AI Enterprise, no una pegatina de juegos creativos.
"Para utilizar NIM En producción, su organización debe tener una licencia NVIDIA AI Enterprise. Estas licencias comienzan en $4500 por GPU al año o ~ $1 por GPU por hora en la nube. El precio se basa en el número de GPU, no en el número de NIM". - NVIDIA NIM General FAQ, docs.api.nvidia.com/nim/docs/product, recuperada Septiembre 2026
Coste, cuotas y fricción real de uso
Costo real = licencia AI Enterprise + instancia GPU (CSP o on-prem) + ingeniería. Prototipado de catálogo hosted es gratuito pero limitado por tarifas (informes de la comunidad ~40 RPM - no un SLA publicado). Programa de desarrolladores caps descargables NIMs en 16 GPUs para uso no productivo. Cloud marketplace AI Enterprise (~$1/GPU/hora) evita CapEx anual, pero apila las tasas de instancia. El soporte cubre el motor/tiempo de funcionamiento optimizado, no salidas modelo.
Dónde NIM sigue fallando
Los equipos que esperan que ChatGPT-como facturación per-token rebotan - NIM es infraestructura. No-NVIDIA-Certified hardware está fuera de alcance para auto-anfitrión compatible. “Production” se define en términos generales (cualquier usuario final real o transacción comercial), por lo que enviar un proyecto paralelo sobre el Programa de Desarrolladores NIMs sin AI Enterprise es un riesgo de licencia. La calidad del modelo sigue siendo el problema del propietario del modelo; NIM optimiza el servicio.
"El uso de la producción implica cualquier uso de NIM para fines distintos del desarrollo, las pruebas, la investigación o la evaluación, como la realización de transacciones comerciales y cualquier actividad que no sea de prueba, incluyendo la actividad que sirve a usuarios finales reales." - NVIDIA NIM FAQ, recuperada Septiembre 2026
Quién debería usar NVIDIA NIM - y quién debería saltarlo
Utilice NIM si implementa IA generativa en GPUs NVIDIA y necesita microservicios portátiles y optimizados con soporte empresarial. Utilice el programa gratuito de desarrolladores / prueba de 90 días a POC. Skip NIM si quieres un producto de chat gestionado (ChatGPT, Amazon Q) o API simples per-token sin operaciones de GPU (Bedrock, OpenRouter). Skip if you lack CUDA-capable infrastructure and will not use Brev/LaunchPad/cloud GPUs.
Reseñas de usuarios
Aún no hay reseñas. ¡Sé el primero en compartir tu experiencia!
Inicia sesión para escribir una reseña.
Artículos relacionados
Guías y artículos relacionados con NVIDIA NIM.
Vantaige Launches the LLM VRAM Calculator: A Free GPU Compatibility Finder for Open-source and Open-Weight AI
Xiaomi MiMo-V2.6 Deep Dive: The 1-Trillion-Parameter Open-Source Titan Disrupting the Frontier